Mellum2.1真实下载体积:Q4量化8.07GB,部署前必看

别被 12B 参数误导:Mellum2.1 推荐量化实测 8.07 GB,16 GB 内存是真实门槛。
本文拆解 JetBrains Mellum2.1(12B MoE、每 token 激活 2.5B)的实际使用成本。作者直接查询 Hugging Face API 得到真实文件体积:推荐的 Q4_K_M 为 8.07 GB,最小 MXFP4_MOE 为 7.03 GB,BF16 参考精度 24.31 GB。结合 KV cache 与运行时开销,16 GB 内存是短到中等上下文下的实际底线,而模型卡示例中的 `--ctx-size 131072` 会直接触发内存压力,应从 8k–16k 起步。文中还提示两个坑:Ollama 官方库没有该模型标签,须走 hf.co 路径;MXFP4_MOE 需要较新的 llama.cpp 构建。JetBrains 自报评测显示该模型在单次代码生成任务上优于 dense 9B 对手,但在多步 agentic 基准上落后。
别被参数规模骗了:先看真实文件大小
所有关于 JetBrains Mellum2.1 的帖子都在重复同一句话:一个 12B 模型跑起来像 2.5B。这确实是 MoE 架构的真实特性——总权重 12B,每 token 激活约 2.5B,这也是它为什么能塞进 dense 12B 塞不进的显卡。
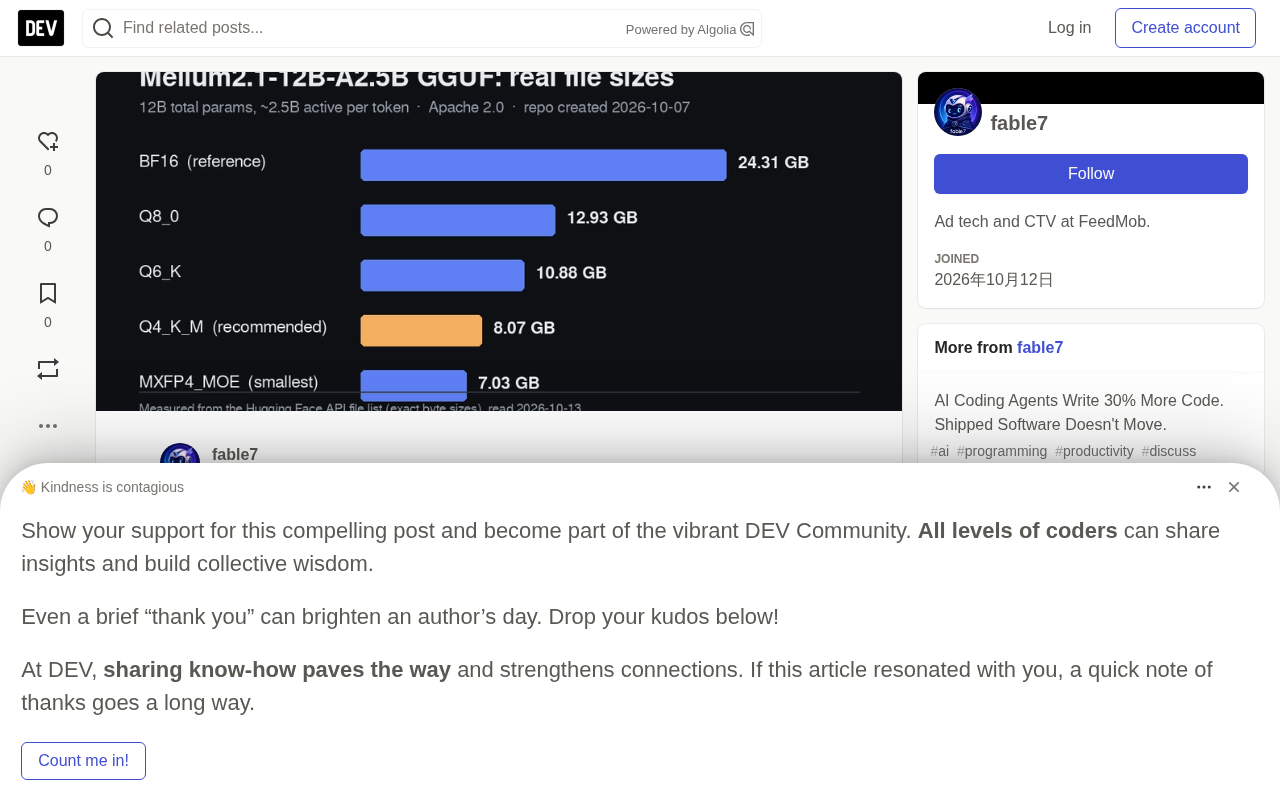
但没有人告诉你下载体积有多大。作者没有轻信二手摘要,而是直接向 Hugging Face API 索取了 JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF 仓库的完整文件列表(2026-10-13 读取),结果如下:
| 量化方案 | 文件大小 |
|---|---|
| BF16(参考) | 24.31 GB |
| Q8_0 | 12.93 GB |
| Q6_K | 10.88 GB |
| Q4_K_M(推荐) | 8.07 GB |
| MXFP4_MOE(最小) | 7.03 GB |
仓库创建于 2026-10-07,读取时已有 27,140 次下载、78 个赞,Apache 2.0 协议,商用没问题。
核心事实:推荐的 Q4_K_M 构建是 8.07 GB,最小的 MXFP4_MOE 是 7.03 GB,而参考精度 BF16 高达 24.31 GB。
MoE 是 Mixture of Experts(混合专家)的缩写。这类模型在结构上把前馈网络拆成若干个并行的"专家"子网络,再通过一个轻量的路由(router)为每个 token 只选择其中一小部分参与计算。于是出现两个不同口径的参数数字:总参数是所有专家加上注意力、嵌入等共享层权重的总和,激活参数(这里写作 A2.5B,即 active 2.5B)则是单个 token 实际经过的权重数量。Mellum2.1 总权重 12B、每 token 激活约 2.5B 就是这个意思。
需要特别注意的是:MoE 节省的是计算量和显存带宽,不是显存容量。推理时仍需把全部 12B 权重加载到内存里备用,路由到哪个专家是运行中动态决定的,事先无法只保留一部分。这也是为什么下载体积(8.07 GB 的 Q4_K_M)由总参数而非激活参数决定——参数规模与文件大小,是两件不同的事。
16GB 是真实门槛,上下文窗口才是陷阱
Q4_K_M 文件本身 8.07 GB,加上 KV cache 和运行时开销,16 GB 内存的机器是推荐构建在短到中等上下文下的实际底线。
问题出在 GGUF 模型卡自带的示例命令里设置了 --ctx-size 131072,即模型完整的 131,072 token 窗口。如果你在 16 GB 笔记本上直接复制这行命令,还没碰到 token 上限就会先撞上内存压力。作者的建议很直接:从 8k–16k 起步,只在确实需要时才往上调。
这就是"能在笔记本上跑"这种说法掩盖的部分:模型装得下,上下文未必装得下。
KV cache 指推理过程中缓存下来的 Key 和 Value 张量。Transformer 生成每个新 token 时都要回看之前所有 token 的注意力键值,若每次都重算代价极高,因此把这些中间结果按层、按注意力头存进显存或内存,避免重复计算。
关键在于它的体积随上下文长度线性增长:序列翻倍,缓存也大致翻倍,并且和批大小成正比。所以在 16 GB 机器上,8.07 GB 的模型权重本身只占一半,剩下的空间要同时容纳 KV cache、激活值、tokenizer 与运行时开销。这也是 --ctx-size 131072 危险的原因:即使模型装得下,长上下文下 KV cache 也可能单独吃掉数 GB,直接把内存压垮。用更少的层数或量化 KV cache(如 --cache-type-k q8_0)可以缓解,但代价是精度和速度。
两个会让你踩坑的细节
没有官方 Ollama 库标签
ollama.com/library/mellum2.1 和 ollama.com/library/mellum2 两个地址都返回 404。你在帖子里看到的 ollama run hf.co/JetBrains/... 命令行之所以能用,是因为它直接从 Hugging Face 拉取 GGUF,而不是解析本地库名称。如果你以为 ollama run mellum2.1 能跑起来,它不能。
GGUF 是 llama.cpp 项目主推的单文件模型格式,全称 GPT-Generated Unified Format。它把权重、张量元数据、分词器词表和量化信息打包进一个二进制文件,并按张量名称约定好命名规则,因此同一个文件能被 llama.cpp、Ollama、LM Studio 等众多推理工具直接读取,无需额外的配置或转换脚本。
Ollama 官方库里的模型(如 ollama run llama3)本质上是从 registry.ollama.ai 拉取的预打包清单。当你写 ollama run hf.co/JetBrains/... 时,Ollama 识别出 hf.co/ 前缀,改为直接从 Hugging Face 解析并下载对应 GGUF,再在本地建立一份清单。这也解释了为什么官方库里查不到 mellum2.1 标签却仍能运行——前者依赖社区或厂商主动发布到 Ollama registry,后者只是借道 HF 的通用下载路径。前缀不同,背后是两套完全独立的仓库体系。
MXFP4_MOE 不在旧版 llama.cpp 中
最小的量化方案(7.03 GB)需要较新的构建版本。如果你的工具链是几个月前的,要么选 Q4_K_M,要么先升级。
JetBrains 自己的数据说明了什么
以下数据来自 JetBrains 自报的评测结果,并非独立复现。对比对象是另一家实验室的 dense 9B 模型:
| 基准测试 | Mellum2.1 | Qwen3.5-9B |
|---|---|---|
| SWE-bench Verified | 47.0% | 50.0% |
| SWE-bench Pro | 28.0% | 38.0% |
| Terminal-Bench 2.1 | 17.4% | 21.7% |
| LiveCodeBench v6 | 82.0% | 75.4% |
| HumanEval+ | 91.5% | 89.6% |
这张表值得读两遍,因为它说的和发布会上说的不一样。12B MoE 在单次代码生成任务上胜出(LiveCodeBench、HumanEval+),但在多步 agentic 基准上输给了一个 9B dense 模型(SWE-bench Pro、Terminal-Bench)——而后者只需要一小部分内存就能装下。
JetBrains 还报告了单张 H200 上 7,969 tokens/s 的速度,对比 Qwen3.5-9B 的 4,347 tokens/s——同样,这是他们自己的测试。
如果你买这个模型是为了吞吐量(高并发生成、lint 级编辑、慢规划器背后的快速执行者),数据支持你。如果你买它是期望它独立解决复杂的仓库级 issue,那么在厂商自己的表格里,一个更小的 dense 模型得分更高。
为什么我没给出吞吐量测试数据
作者的测试机器是 2 vCPU、7 GB 内存(约 4 GB 可用)、无 GPU。最小的发布构建是 7.03 GB,模型根本装不下这台机器,所以没有运行,也不会引用一个自己从未测量的 tokens/s 数字。实际测量的内容就是上文这些:文件体积、仓库日期、两个 404。
这种诚实态度值得学习。社区里充斥着未经独立验证的速度和得分对比,而发布者往往不会告诉你他们的硬件条件。
下载前的检查清单
- 用 8.07 GB 加上 KV cache 来核对内存,而不是用"12B 参数"这个数字
- 除非你有 24 GB 以上内存,否则选 Q4_K_M
- 首次运行时削减上下文长度;模型卡里的示例是最大值,不是默认值
- 先在一个你已经修好的 bug 上测试,再指向你在意的仓库
- 把每一个速度和得分对比都当作厂商自报数据,直到有人发布独立测试
接下来一个月有意思的问题不是 12B MoE 能不能写代码,而是当更快的开源模型和解决更多任务的慢模型摆在你面前时,你的 agent 最终会用哪一个。
Sources: GGUF repository, model card, Hugging Face API metadata
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。