MemCompile:面向长期智能体内存的查询条件化编译框架

MemCompile 通过查询条件化的证据编译,将记忆寻址与证据呈现解耦,提升长期记忆系统答案质量。
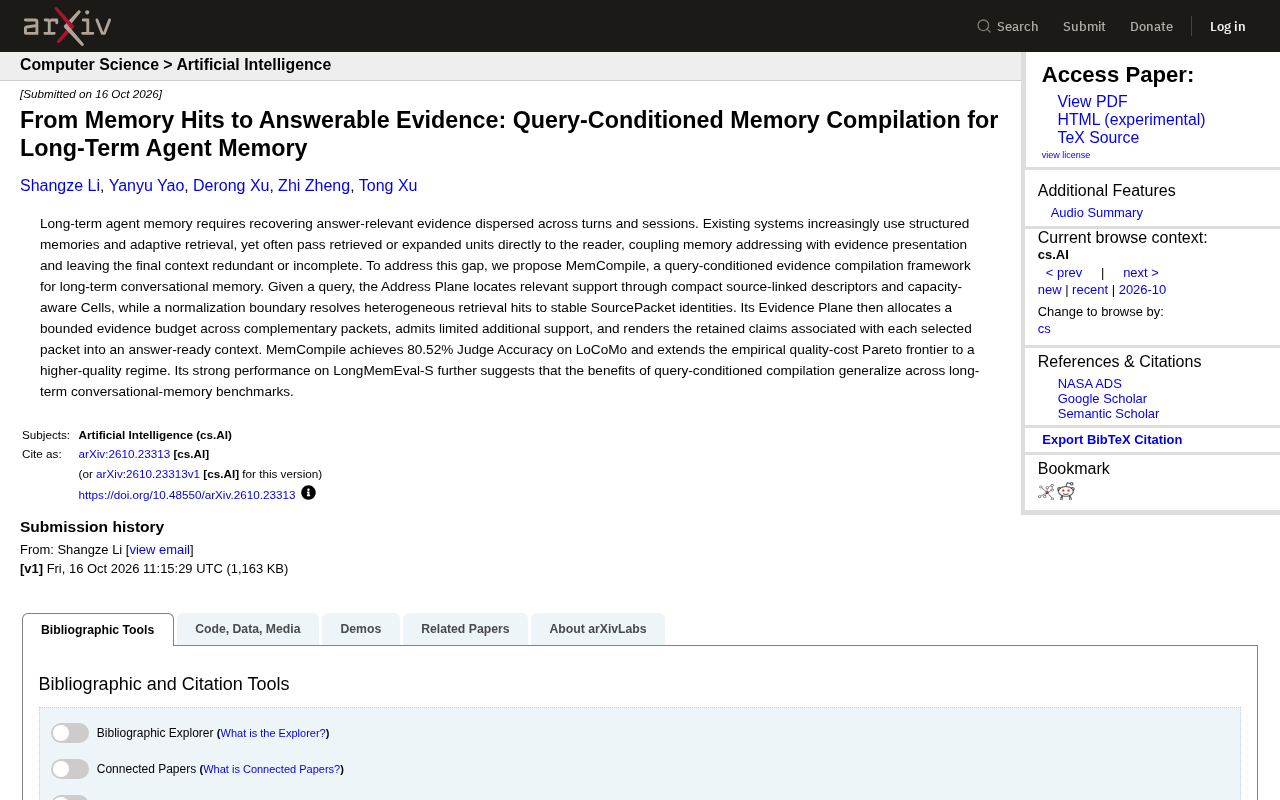
MemCompile 框架针对长期记忆系统中“检索即拼接”导致的上下文冗余或缺失问题,提出将记忆寻址与证据呈现拆分为寻址平面和证据平面。寻址平面利用源链接描述符和容量感知单元定位证据,并通过归一化边界将异构命中解析为稳定的 SourcePacket;证据平面则在有界预算下编译答案就绪的上下文,优先保留互补证据并允许有限额外支撑。在 LoCoMo 数据集上取得 80.52% Judge Accuracy,并在 LongMemEval-S 上验证了泛化性。该工作表明,在证据层面进行可控编译比单纯扩大检索更有效,为智能体内存设计提供了新范式。
长期记忆是智能体(Agent)实现连续对话与复杂任务的关键能力,但如何从海量历史交互中精准恢复“可回答问题的证据”仍是一个开放难题。现有系统通常将检索到的记忆单元直接拼接到上下文中,导致最终输入要么冗余、要么缺失关键信息。近期一篇论文提出的 MemCompile 框架,通过查询条件化的证据编译(query-conditioned evidence compilation)试图弥合这一鸿沟。
现有记忆系统的核心痛点
当前长期记忆系统普遍采用“结构化记忆 + 自适应检索”的范式,但在证据呈现环节存在明显缺陷。论文指出,这类系统往往将记忆寻址与证据呈现耦合:检索到的单元或扩展后的片段被直接传给阅读器(reader),既没有根据查询需求进行二次筛选,也没有对异构的检索结果做统一归一化。结果就是,最终上下文可能包含大量无关内容,同时遗漏了分散在不同会话中的互补证据。
这种“检索即拼接”的做法,在长对话场景下尤其低效——记忆库越大,冗余越严重,而真正支撑答案的线索可能藏在多个来源中。MemCompile 的出发点正是将“找到相关记忆”和“组织成可回答的证据”拆分为两个独立但协同的步骤。
阅读器(reader) 在检索增强生成(RAG)和长期记忆系统中,指接收检索结果并生成最终答案的模块,通常是一个大语言模型。它的输入质量直接决定输出质量:如果上下文冗余,模型可能被无关信息干扰;如果上下文缺失关键证据,模型则无法正确推理。因此,检索与阅读器之间的“证据呈现”环节是系统性能的瓶颈之一,这也解释了为何 MemCompile 要将证据编译独立为专门模块。
MemCompile 的两层架构:寻址与证据编译
MemCompile 的核心设计分为寻址平面(Address Plane) 和证据平面(Evidence Plane),两者通过统一的身份标识衔接。
寻址平面:从海量记忆中定位支撑证据
寻址平面负责在给定查询下,从长期记忆中快速定位相关支撑。它使用紧凑的、源链接的描述符(source-linked descriptors) 和容量感知的单元(capacity-aware Cells)来组织记忆。每个 Cell 可以容纳一定数量的记忆项,并通过描述符与原始来源建立链接。当检索命中多个异构来源时,一个归一化边界(normalization boundary) 会将这些命中解析为稳定的 SourcePacket 身份。这一步的关键在于,它不直接输出原始文本片段,而是输出带有来源标识的“证据包”,为后续编译提供干净、可追溯的输入。
SourcePacket 是 MemCompile 中表示“证据包”的基本单元。它将一次检索命中的多个异构来源(如不同会话、不同记忆单元)归一化为统一身份,并保留来源链接以便追溯。与原始文本片段不同,SourcePacket 携带结构化的来源标识和描述符信息,使下游模块能够判断证据的互补性与可信度。这种设计避免了直接拼接原始片段带来的格式混乱与来源丢失问题,是证据平面进行预算分配和渲染的前提。
证据平面:在预算约束下编译答案就绪的上下文
证据平面接收来自寻址平面的 SourcePacket 集合,并根据查询需求进行证据预算分配。具体来说,它会:
- 在互补的证据包之间分配有界证据预算(bounded evidence budget) ,优先保留与查询最相关的信息;
- 允许有限度的额外支撑(limited additional support)加入,以覆盖分散在多处的补充证据;
- 将每个选中证据包关联的保留断言渲染为答案就绪的上下文(answer-ready context),供下游阅读器直接使用。
这种“先编译、再生成”的流程,使得最终上下文既不过度膨胀,又能包含回答所需的关键证据。
实验结果:质量与成本的双重优势
论文在多个长期对话记忆基准上验证了 MemCompile 的有效性。在 LoCoMo 数据集上,MemCompile 取得了 80.52% 的 Judge Accuracy,并在质量-成本帕累托前沿(Pareto frontier)上扩展到了更高的质量区间。这意味着在相同成本下,它能提供更优的答案质量;或者说,达到同等质量时,它的成本更低。
此外,在 LongMemEval-S 基准上的强劲表现,进一步表明查询条件化编译的收益可以泛化到不同的长期对话记忆任务中。论文作者认为,这种将记忆寻址与证据呈现解耦的设计,为长期智能体内存提供了一种更可控、更高效的范式。
帕累托前沿(Pareto frontier) 在多目标优化中指一组“无法在不牺牲某一目标的情况下改进另一目标”的解集。在记忆系统中,质量与成本(如上下文长度、计算开销)往往相互制约。MemCompile 在质量-成本帕累托前沿上扩展到更高区间,意味着它能在不增加成本的前提下提升质量,或在不降低质量的情况下减少成本,从而优于现有方法的权衡曲线。这一指标比单一准确率更能反映系统的实际部署价值。
对智能体内存设计的启示
MemCompile 的提出反映了长期记忆研究的一个趋势:从“检索更多”转向“编译更准”。传统方法倾向于扩大检索窗口或增加记忆单元数量,但 MemCompile 证明,在证据层面做有损但可控的编译,反而能提升最终答案的准确性。
对于构建实际智能体系统的开发者而言,这一思路有两点可借鉴之处。其一,记忆系统应当输出带有来源标识的规范化证据包,而非原始片段,以便后续模块进行可追溯的筛选与组合。其二,证据预算的显式管理有助于控制上下文长度,在长对话场景下避免“记忆爆炸”带来的性能衰减。
目前 MemCompile 的细节已在论文中公开,其代码与实现若后续开源,有望成为长期记忆系统的一个有力基线。
有损但可控的编译 借鉴了编译原理中的思想:编译器将源代码转换为目标代码时,会丢弃冗余信息但保留语义等价性。在记忆系统中,这意味着证据平面不必保留检索到的全部内容,而是根据查询需求有选择地压缩和重组证据,同时通过预算约束和来源标识确保关键信息不丢失。这种“编译”视角将记忆组织从简单的检索拼接提升为主动的信息提炼,是 MemCompile 区别于传统方法的核心哲学。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。