MemCurrent:为生产级Agent设计持久记忆系统

生产级Agent的持久记忆应拆为写入、检索、更新、隔离四个工程模块。
文章指出,用AI工具快速搭建Agent原型已非难事,真正的分水岭在于部署到生产环境后能否跨会话保持持久记忆。上下文窗口无法替代记忆层:它带来Token成本随会话线性增长、关键信息被稀释、状态无法跨会话延续三大问题。MemCurrent的核心理念是把记忆从上下文工程中剥离,做成独立的存储与检索层。文章据此拆解出四个工程问题:写入侧需结构化抽取事实与偏好而非存原始文本;检索需在合适时机精准召回,兼顾规则与向量两条路径;记忆必须支持更新与遗忘,遗忘是必要功能;多租户隔离与隐私合规是企业落地硬门槛。最终判断是Agent竞争正从模型选型转向系统工程,记忆层值得作为独立基础设施投入,且与RAG在检索策略、更新频率和隐私边界上存在本质差异。
当Agent从演示走向生产线
AI工具让「vibe coding」一个Agent变得前所未有的容易。几个提示词、一段循环逻辑,一个能对话、能调工具的智能体就能跑起来。但真正的分水岭不在原型阶段,而在把它部署到生产环境之后——当它需要跨会话记住用户偏好、在长任务中保持上下文一致、在多轮交互后仍然「认识」对方时,持久记忆就成了绕不过去的工程难题。
MemCurrent 这个项目讨论的正是这个问题。它的核心命题不是「如何让模型记住更多」,而是「如何为生产级Agent设计一套可维护、可扩展的记忆架构」。这个角度的转变本身就值得展开。
为什么上下文窗口不是记忆
很多团队的第一反应是把对话历史一股脑塞进上下文窗口。这在Demo里行得通,在生产里会迅速暴露三个问题。
成本随会话长度线性增长。 每一次请求都重新携带完整历史,Token开销会随着用户使用时长不断攀升,长期活跃用户的单次交互成本可能达到新用户的数十倍。
注意力被稀释。 即使模型支持超长上下文,关键信息淹没在大量无关历史中,检索质量下降是已被反复观察到的现象。
状态无法跨会话延续。 上下文是会话级的,用户关掉窗口再回来,一切归零。生产环境需要的是账户级的、可持久的记忆层。
MemCurrent 的设计思路是把记忆从「上下文工程」中剥离出来,做成独立的存储与检索层。模型不再负责「记住」,只负责在需要时读取。
上下文窗口是Transformer类模型单次前向推理时能处理的最大Token序列长度,通常以Token数计量(如128K、200K)。它本质上是模型注意力机制的作用范围:窗口内的Token彼此可见,窗口外的内容则完全不可见。这意味着上下文窗口具有「会话级」而非「账户级」的生命周期——它不是存储介质,而是一次计算的输入边界。理解这一点很关键:把历史写入上下文窗口,只是把信息从外部存储复制到一次推理的输入中,推理结束后并不留存任何状态。所谓「长上下文」只是扩大了单次可携带的信息量上限,并没有改变「每轮必须重新携带、结束后即丢弃」的本质,因此无法承担跨会话持久记忆的职责。
持久记忆需要解决的四个工程问题
写入:什么值得记
不是所有对话都值得写入长期记忆。无意义的寒暄、一次性的查询结果、已被更新的旧信息,都应该被过滤。MemCurrent 主张在写入侧做结构化抽取——把原始对话转成事实条目、偏好标签、任务状态等可管理单元,而不是存储原始文本。这既压缩了存储,也让后续检索有明确的字段可用。
检索:在对的时机给对的信息
记忆的价值取决于召回时机。生产级Agent需要在每轮交互前判断:这次任务需要历史偏好、还是需要上次的任务进度、还是什么都不需要?无差别召回会引入噪声,过度保守又会丢失连续性。这一层的设计需要在延迟与准确性之间做权衡,通常需要结合规则与向量检索两条路径。
向量检索指把文本经嵌入模型编码为高维向量,通过余弦相似度或内积等度量在向量库中查找语义相近条目。它擅长处理「意思相近但用词不同」的模糊匹配,但对精确条件(如时间范围、用户ID、状态枚举值)不敏感,且召回结果缺乏可解释的过滤依据。规则检索则基于结构化字段做精确匹配或布尔组合,延迟低、可控性强,但无法覆盖语义变体。生产系统通常采用混合策略:先用规则按租户、时间、类型等元数据缩小候选集,再在候选集内做向量相似度排序,从而在延迟与召回质量之间取得平衡。这种「先过滤后语义排序」的两段式设计,是记忆检索层落地时的常见工程范式。
更新与遗忘:记忆会过期
用户换了工作、改了偏好、迁移了地址,旧记忆就成了负担。持久记忆系统必须支持更新与失效机制,否则Agent会用过时信息做出错误判断。遗忘不是缺陷,而是记忆系统的必要功能。
在记忆系统语境下,遗忘机制通常包含三类策略:其一是覆盖式更新,新事实写入时按唯一键替换旧值,适用于偏好、地址等单值属性;其二是时效衰减,为每条记忆附带时间戳与有效期,过期后自动降权或归档;其三是冲突消解,当新旧信息矛盾时依据置信度、来源与时间先后决定取舍。遗忘的价值在于控制噪声与错误传播——过时记忆若被召回,会直接污染模型判断,且这类错误往往难以被用户察觉。因此遗忘不是存储空间的被动清理,而是主动维护记忆质量的手段。
隔离与合规:谁能看到什么
多租户场景下,记忆必须严格按用户、按组织隔离。同时,记忆内容涉及用户隐私,需要支持删除请求、审计日志与保留期限策略。这一层往往被原型阶段忽略,却是企业落地的硬门槛。
对生产落地的几点判断
MemCurrent 提出的架构方向,指向了一个更宏观的趋势:Agent的能力竞争正在从「模型选型」转向「系统工程」。同一个模型,配上精心设计的记忆层,在客服、个人助理、长周期任务等场景中的表现会有量级差异。
对团队而言,这意味着两件事。其一,记忆层值得作为独立基础设施投入,而不是塞在业务代码里临时拼凑。其二,记忆的数据模型设计要先行——一旦写入格式定错,后续迁移成本极高。
另一个值得关注的信号是,生产级Agent的记忆需求与RAG有大量重叠但不完全等同。RAG面向文档知识,记忆面向交互状态,两者在检索策略、更新频率、隐私边界上都有差异。把二者混为一谈,往往会导致架构上的别扭。
小结
MemCurrent 的价值不在于提供了某个具体实现,而在于把「Agent记忆」从模糊的直觉问题,拆解成了写入、检索、更新、隔离四个可讨论的工程模块。对于正在把Agent推向生产环境的团队来说,这套拆解框架本身就是一份有用的设计清单。
相关推荐

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
LLM应用越改越糟?三步构建有效评估体系
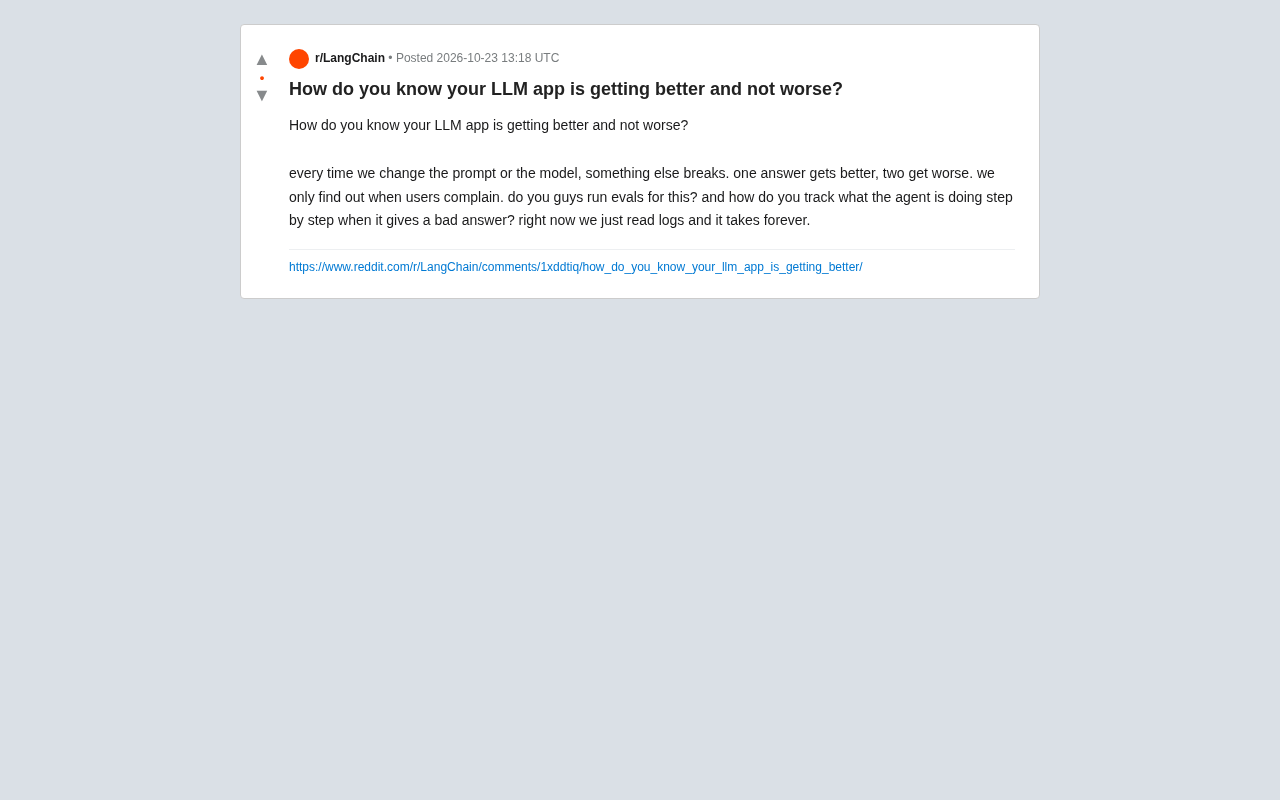
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。
瑞典政府封杀ChatGPT与Claude:AI工具治理的转折点
瑞典政府宣布禁止在员工电脑上使用ChatGPT和Claude,出于信息安全考虑。本文分析禁令细节、数据主权焦虑及对AI行业的影响。