MemEmo基准测试:记忆系统情感智能仅得45%

MemEmo基准揭示主流记忆系统情感处理聚合得分最高仅45%,远未及格。
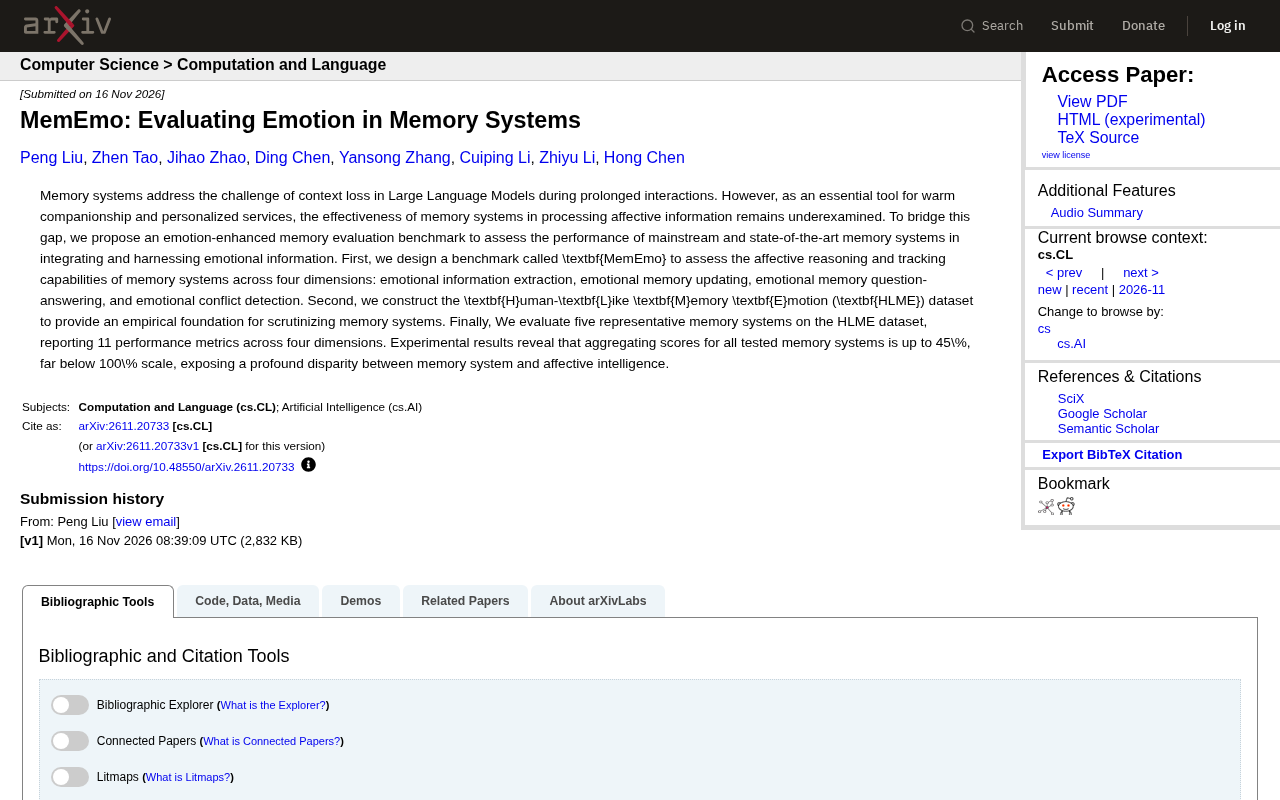
研究提出MemEmo基准,专门评估大语言模型记忆系统在情感维度上的能力。该基准将情感记忆拆解为情感信息提取、情感记忆更新、情感记忆问答和情感冲突检测四个维度,并构建HLME数据集,对五个代表性记忆系统进行评测,报告覆盖四维度的11项指标。结果显示,所有被测系统的聚合得分最高仅为45%,远低于100%满分,暴露出记忆系统擅长记住事实却在理解情绪上存在显著差距。文章分析认为,这一短板源于现有系统以事实性信息为优化目标、情绪信号易被当作噪声过滤,且多数架构擅长静态存储而非动态修正。MemEmo的价值在于把情感智能转化为可量化、可比较的工程指标,为AI陪伴与个性化服务中的记忆模块设计提供评估基础设施。
记忆系统的情感短板:从MemEmo基准说起
大语言模型在长时间交互中容易丢失上下文,记忆系统正是为解决这一问题而设计的。然而,当记忆系统被用于提供温暖陪伴和个性化服务时,它对情感信息的处理能力却鲜有系统性的检验。近期一篇研究提出了 MemEmo 基准,专门评估记忆系统在情感维度上的表现,结果并不乐观:参与测试的五个代表性记忆系统在所有维度上的聚合得分最高仅为45%,远低于100%的满分线。
这一结果揭示了一个关键矛盾:记忆系统擅长“记住事实”,却在“理解情绪”上存在 profound disparity(显著差距)。对于追求拟人化交互的AI应用而言,这无疑是一个值得关注的信号。
记忆系统在此语境中并非指人脑的记忆机制,而是指大语言模型外挂的、用于跨会话或长对话中持久化与检索信息的工程模块,常见实现包括向量数据库检索、摘要式记忆、结构化键值存储以及基于图谱的记忆等。这类系统通常以“事实召回率”“上下文一致性”为核心优化目标,其典型架构是把对话切分为片段、编码为向量或摘要后存入存储层,再在需要时按语义相似度召回。由于整条链路围绕信息保真度设计,情感信号(如语气、情绪标签、情绪转变)往往没有被显式建模,也就难以在检索与推理阶段被有效利用。
MemEmo如何评估情感记忆?
研究团队将情感记忆能力拆解为四个可测量的维度,并据此设计了基准测试:
- 情感信息提取:系统能否从对话中准确识别并抽取出情绪信号;
- 情感记忆更新:当用户情绪状态变化时,记忆系统能否及时修正旧有情绪标签;
- 情感记忆问答:涉及过往情绪经历的提问,系统能否正确检索并回答;
- 情感冲突检测:面对前后矛盾的情绪表达,系统能否识别出冲突并做出合理处理。
这四个维度覆盖了情感记忆从编码、存储到检索与推理的完整链路。研究同时构建了 HLME(Human-Like Memory Emotion)数据集,为上述任务提供实证基础,并在该数据集上对五个代表性记忆系统进行了评估,最终报告了覆盖四个维度的11项性能指标。
45%得分背后的技术现实
实验中最具冲击力的发现是:所有被测记忆系统的聚合得分最高仅为45%。这意味着即使在相对基础的评估框架下,主流方案的情感处理能力也远未及格。
从维度设计可以推测,这种不足可能来自两个层面。其一,现有记忆系统多以事实性信息为优化目标,情绪信号在管道中容易被当作噪声过滤或简化;其二,情感记忆的动态性——比如用户从沮丧转为释然——要求系统具备持续更新信念的能力,而多数记忆架构更擅长静态存储而非动态修正。
研究在HLME数据集上使用11项指标进行衡量,这种多维评估方式也说明,情感记忆并非单一能力,而是多个子任务协同的结果。任何一个环节的薄弱都会拉低整体表现。
聚合得分是指把多个子任务、多个维度的指标按一定规则汇总为单一数值,以便横向比较不同系统。在MemEmo中,11项指标覆盖提取、更新、问答与冲突检测四类任务,聚合方式通常先对同类指标取平均、再跨维度加权。需要留意的是,聚合得分会掩盖维度间的不均衡:一个系统可能在情感信息提取上表现尚可,却在情感记忆更新或冲突检测上接近失败,最终汇总出的45%仍会显得“平平”。因此解读这一数字时,应结合分项指标判断短板究竟落在编码端、存储端还是检索推理端,而不能仅凭总分推断系统整体可用性。
HLME(Human-Like Memory Emotion)数据集是为情感记忆评测专门构建的对话级数据资源,其设计目标是让每个测试样本都携带可追踪的情绪状态及其时间演变。与通用对话数据集不同,HLME需要在对话中标注情绪信号、情绪标签的变更时点、可回答的情绪相关问题,以及前后矛盾的情绪表达,从而支撑四类任务的分项测量。这类数据集的构建难点在于情绪标注的主观性:同一句话在不同语境下可能被解读为不同情绪,标注一致性直接决定基准的可复现性。也正因如此,HLME作为评估基础设施的价值,不仅在于提供题目,更在于为“情感记忆”这一模糊概念划定了可操作的测量边界。
对AI陪伴与个性化服务的启示
记忆系统被寄予厚望的场景,恰恰是情感密度最高的领域。无论是长期陪伴型对话助手,还是需要记住用户偏好的个性化服务,情感记忆的准确性直接影响体验的“温度”。
MemEmo基准的价值在于,它把“情感智能”从模糊的用户感受转化为可量化、可比较的工程指标。对于开发者而言,这意味着在设计记忆模块时,需要将情感信息的抽取、更新与冲突处理纳入显式设计,而非依赖通用记忆能力的自然溢出。对于研究者而言,45%的得分是一个清晰的起点——它标记了当前技术栈的真实水位,也为后续改进提供了可复现的测量工具。
当记忆系统从“记住用户说过什么”进化到“理解用户感受过什么”,AI交互的拟人化才会真正落地。MemEmo的出现,正是朝着这个方向迈出的评估基础设施一步。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。