MemoryOps:会从历史故障中学习的AI事件响应智能体

MemoryOps 是一个以持久记忆驱动的开源AI运维智能体,让故障处置经验可跨任务积累复用。
MemoryOps 是一个开源 AI 事件响应智能体,核心创新在于引入持久记忆层 Hindsight,通过 RECALL→REFLECT→RECOMMEND→RETAIN 四步闭环,使智能体在每次处理故障后将经验写回记忆库,下次遇到相似问题时可调用历史处置结果给出更具针对性的建议。项目以数据库连接池耗尽为演示场景,展示了记忆积累如何让推荐从通用排查方向演进为经过验证的具体解法。技术栈采用 React + FastAPI + Groq + Hindsight 的轻量组合,目前为 demo 级开源原型。项目同时抛出了 AI Agent 记忆管理的深层命题:记忆粒度、相似性判断、过时记忆淘汰等问题均尚无标准答案,是该方向走向生产可用必须解决的工程挑战。
运维工程师最头疼的场景之一,是同一类生产故障反复发生,每次都要从零开始排查。一位开发者构建的开源项目 MemoryOps 试图解决这个痛点——它是一个具备持久记忆能力的 AI 事件响应智能体,核心理念是让智能体在处理每次故障时,都能调用过往经验,而不是把每个事件都当作全新的问题。
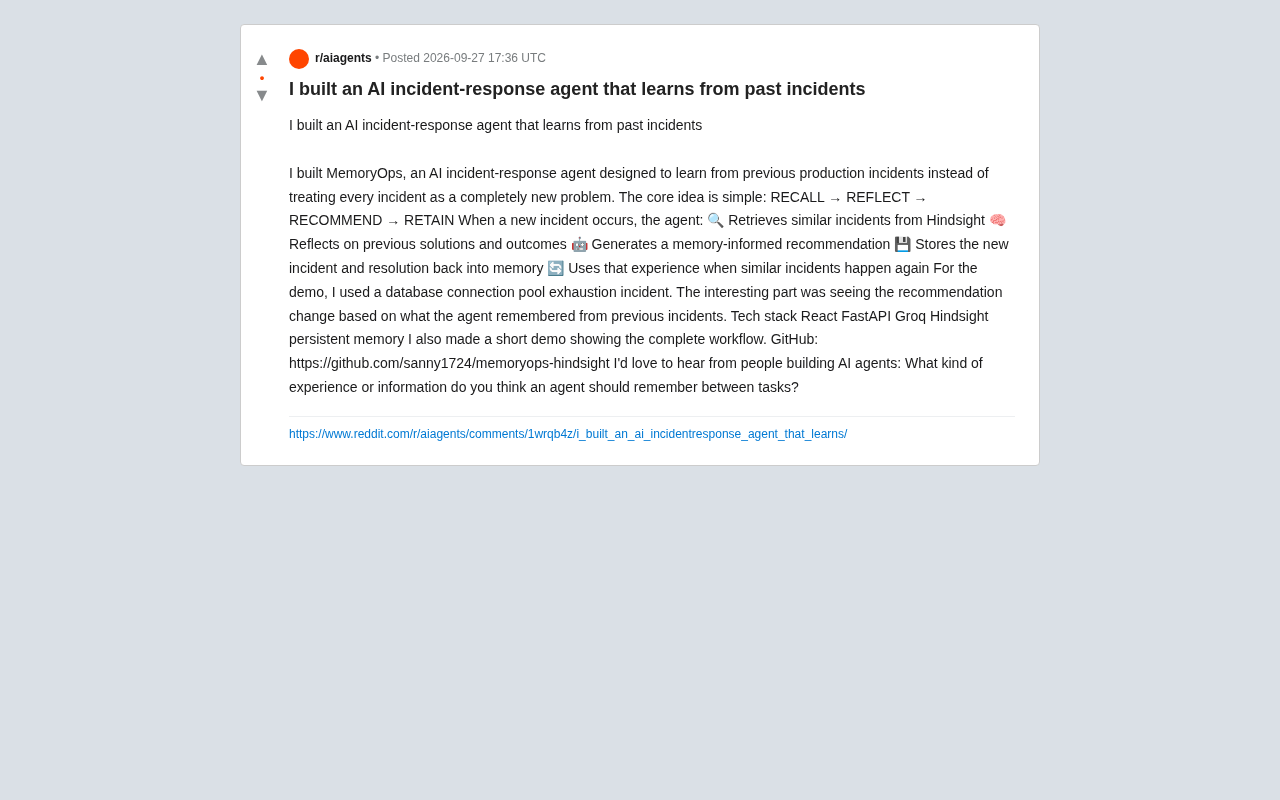
核心思路:RECALL → REFLECT → RECOMMEND → RETAIN
传统的告警和自动化脚本大多是无状态的:故障来了,按规则执行处置,处理完就结束,下一次同样的问题仍然要重新走一遍流程。MemoryOps 的设计者把这套循环改造成了一个带记忆的闭环,用四个动词概括:
- RECALL(检索):当新故障发生时,从记忆库 Hindsight 中检索相似的历史事件;
- REFLECT(反思):分析这些历史事件当时采用的解决方案以及最终效果;
- RECOMMEND(推荐):基于记忆生成一条“有经验依据”的处置建议;
- RETAIN(留存):把本次故障及其解决过程重新写回记忆库,供未来复用。
这个闭环最关键的价值在于第四步——每处理一次故障,系统的“经验值”都会累积。当类似问题再次出现,智能体给出的建议会因为记住了上一次的处置结果而发生变化,而不是每次都输出千篇一律的通用答案。
演示场景:数据库连接池耗尽
作者在演示中选用了一个运维中相当典型的故障:数据库连接池耗尽(connection pool exhaustion)。这类问题往往有多种诱因——连接泄漏、慢查询堆积、突发流量、配置上限过低等——而且解决方案高度依赖于具体环境的历史经验。
据作者描述,演示中最有意思的一点是:随着智能体“记住”了之前处理过的相似事件,它给出的推荐会随之演进。换句话说,第一次遇到连接池耗尽时,智能体可能只能给出一个较为通用的排查方向;但在积累了历史处置记录后,它的建议会更贴近该系统曾经验证有效的解法。这正是“记忆驱动”与传统规则引擎的本质差异。
数据库连接池(Connection Pool)是应用服务与数据库之间的连接复用机制,其核心作用是避免每次请求都新建 TCP 连接所带来的高延迟开销。连接池设有最大连接数上限,当所有连接都处于占用状态且无连接及时归还时,新的请求将进入等待队列直至超时,形成"连接池耗尽"故障。这类故障之所以适合作为记忆驱动智能体的演示案例,正是因为其根因多样(连接泄漏、慢查询、配置不当等),纯规则引擎难以覆盖所有情形,而历史处置经验恰好能有效缩短排查路径。
技术栈拆解
MemoryOps 的实现选型偏向轻量与快速迭代:
- React:前端界面,用于展示事件工作流与推荐结果;
- FastAPI:后端服务框架,负责编排智能体逻辑;
- Groq:提供推理能力的大模型接口,以低延迟推理著称;
- Hindsight:作为持久化记忆层,承担历史事件的存储与相似性检索。
其中 Hindsight 是整个系统的“灵魂”。智能体的记忆并不是简单地把日志堆在数据库里,而是需要能够按相似度检索、按结果反思。这类持久记忆组件正是当前 AI Agent 领域探索的热点——如何让智能体在多次任务之间保留有价值的上下文,是决定其实用性的关键。
Hindsight 在技术实现上通常依赖向量数据库(Vector Database)来完成相似性检索。其基本原理是:将历史故障事件通过嵌入模型(Embedding Model)转换为高维向量,存储在向量索引中;当新事件到来时,同样转换为向量,再通过余弦相似度或近似最近邻(ANN)算法找出最相关的历史记录。这与传统的关键字检索有本质区别——即使两次故障的描述措辞完全不同,只要语义相近,仍然能被匹配到。这种"语义记忆"能力是 RAG(检索增强生成)技术在 Agent 场景下的直接延伸,也是当前 LangChain、LlamaIndex 等 Agent 框架重点支持的功能方向。
记忆驱动智能体的意义与开放问题
这个项目虽然是一个 demo 级别的开源实践,但它触及了 AI Agent 落地的一个核心命题:跨任务的经验沉淀。
多数当前的 AI 助手在单次会话内表现尚可,但会话结束后一切归零。对于运维、客服、代码修复这类高度重复的场景,如果智能体能够记住“上次这么做有效、那么做失败”,它的价值会随着使用时间指数级增长。MemoryOps 用一个具体的事件响应场景,把这套理念做成了可运行的原型。
作者也在帖子结尾抛出了一个值得整个社区思考的问题:一个 AI 智能体究竟应该在任务之间记住哪些经验或信息? 这背后其实是一系列尚未有标准答案的工程难题——
- 记忆该以何种粒度存储?是完整事件、结构化摘要,还是关键决策点?
- 如何判断历史事件与当前事件“相似”?
- 过时或错误的记忆如何淘汰,避免智能体被历史包袱误导?
- 记忆检索与大模型推理如何协同,才能既准确又不冗长?
对于正在构建 AI Agent 的开发者,MemoryOps 提供了一个可参考的最小实现路径。项目已在 GitHub 开源(sanny1724/memoryops-hindsight),感兴趣的读者可以查看完整工作流演示。
记忆管理中的"遗忘"机制同样是工程实践中不可回避的挑战。人类运维专家会自然地降低对陈旧经验的信任,但 AI 智能体若不加干预,可能将数年前已失效的解决方案与最新经验等权对待。目前业界探索的几种应对策略包括:为每条记忆附加时间戳并设置衰减权重、引入人工或自动的"记忆审核"标记错误结论、以及通过结果反馈机制(如故障是否真正被解决)来强化或削弱对应记忆的检索优先级。这些机制在 MemoryOps 的当前 demo 中尚未完整呈现,但恰恰是将原型推向生产可用所必须解决的核心问题。
小结
MemoryOps 并非要取代成熟的可观测性与告警平台,而是示范了一种把“记忆”嵌入运维闭环的思路。它的 RECALL → REFLECT → RECOMMEND → RETAIN 四步循环,简洁地表达了记忆驱动智能体的基本形态。随着持久记忆技术(如 Hindsight)逐步成熟,这类能从历史中学习的 AI Agent 有望成为运维自动化的下一个方向。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。