孟加拉语指代消解研究:高质量小数据胜过混合大数据
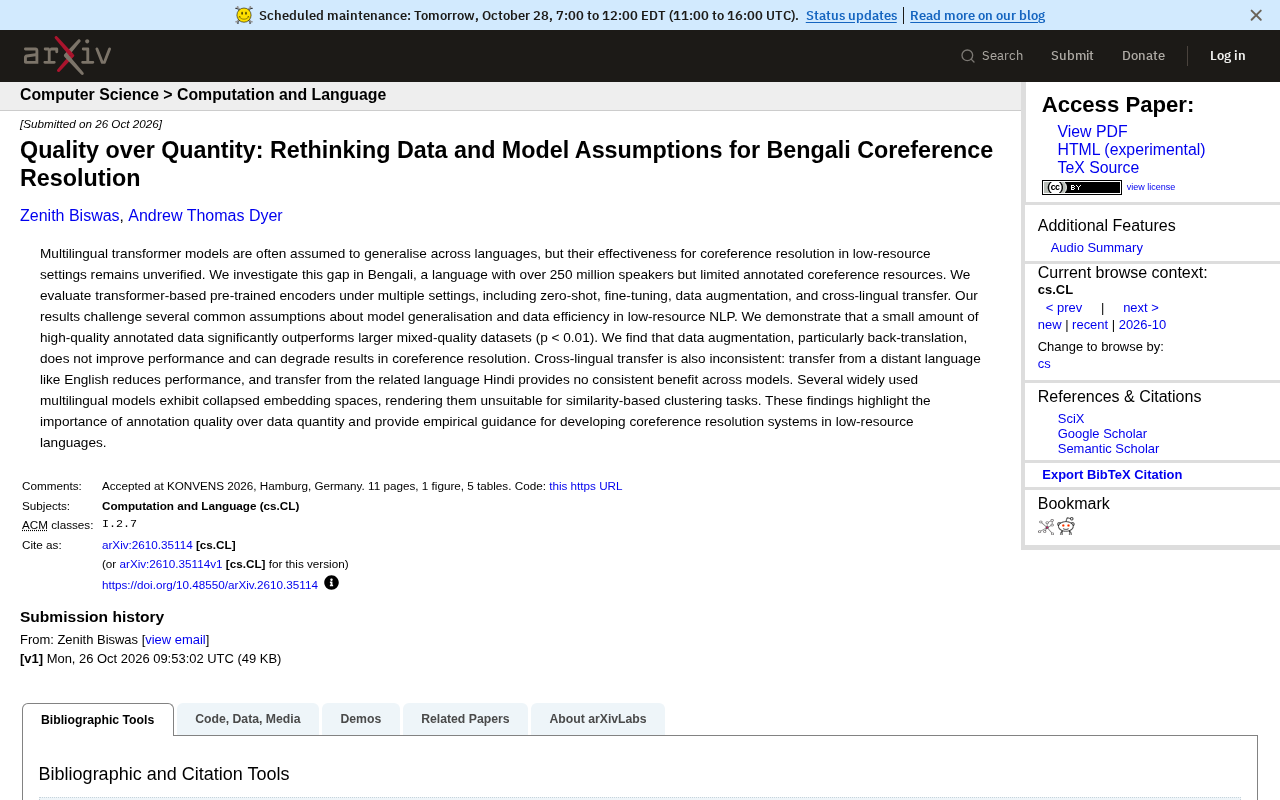
孟加拉语指代消解研究挑战“数据越多越好”与“多语言模型通用”两大假设。
一项针对孟加拉语指代消解的系统研究评估了零样本、微调、数据增强和跨语言迁移等多种设置,对低资源NLP中的常见假设提出挑战。研究发现,少量高质量标注数据的微调效果显著优于更大规模但质量参差的混合数据集(p < 0.01),说明标注质量比数据规模更关键。回译等数据增强手段不仅无提升,甚至可能损害性能,因其破坏篇章级实体一致性。跨语言迁移同样不稳定:从英语迁移降低性能,从印地语迁移在不同模型间无一致收益。此外,多个广泛使用的多语言模型存在嵌入空间坍缩,不适合依赖相似度的聚类任务。研究呼吁社区重新审视数据规模与多语言通用性假设。
多语言Transformer模型常被默认具备跨语言泛化能力,但在低资源语言上的实际表现往往缺乏验证。一项针对孟加拉语指代消解的研究系统评估了零样本、微调、数据增强和跨语言迁移等多种设置,结果对“数据越多越好”和“多语言模型通用”这两个常见假设提出了直接挑战。
低资源语言的指代消解困境
孟加拉语拥有超过2.5亿使用者,但标注好的指代消解资源十分有限。指代消解任务要求模型识别文本中哪些表达指向同一实体,这对篇章理解和下游应用都至关重要。研究团队选择孟加拉语作为切入点,正是因为它在“使用者规模大”与“标注资源少”之间的落差具有代表性。
以往的低资源NLP工作常依赖两种策略:一是直接套用多语言预训练编码器,期待零样本或少量微调就能奏效;二是通过数据增强或从高资源语言迁移来弥补标注缺口。这项研究对这些策略逐一做了检验,结论并不乐观。
指代消解(Coreference Resolution) 是自然语言处理中的一项基础任务,目标是确定文本中哪些名词短语(如代词、专有名词、描述性短语)指向现实世界中的同一实体。例如在句子“张三说他明天来”中,模型需要判断“他”与“张三”共指。该任务通常被建模为聚类问题:先将所有提及(mention)抽取出来,再判断哪些提及属于同一实体簇。评价指标常用 MUC、B³、CEAF 及其平均分 CoNLL F1。指代消解对篇章理解至关重要,是问答、摘要、信息抽取等下游任务的前置能力。与句子级任务不同,它依赖跨句甚至跨段落的实体一致性信息,因此对数据增强和迁移学习中的结构扰动格外敏感。
核心发现:标注质量比数据规模更关键
研究最明确的结论是:少量高质量标注数据的微调效果,显著优于规模更大但质量参差的混合数据集,统计显著性达到p < 0.01。这一结果意味着,在低资源场景下盲目扩充数据量可能收效甚微,甚至引入噪声。对实践者而言,把预算投入到精细化标注上,比堆砌低质数据更划算。
这一发现也呼应了低资源NLP中一个逐渐被接受的观点:数据效率的核心在于质量而非数量。但该研究通过严格的对照实验,把这一直觉变成了可复现的实证结论。
数据增强与跨语言迁移的意外失效
数据增强在不少任务中被视为低资源场景的救命稻草,但这项研究给出了反例。回译(back-translation)等增强手段不仅没有提升指代消解性能,在某些设置下还导致结果下降。研究者指出,指代消解依赖篇章级的实体一致性,增强过程可能破坏这种结构信息。
跨语言迁移的表现同样不稳定。从英语这类远距离语言迁移会降低性能,而从相关语言印地语迁移,在不同模型之间也没有带来一致收益。这打破了“语言相近就能迁移”的简单假设,说明迁移效果高度依赖模型与任务的具体匹配。
回译(Back-translation) 是一种常用的数据增强技术:将原始句子翻译成另一种语言,再翻译回原语言,从而生成语义相近但表达不同的新样本。它在机器翻译等任务中效果显著,常被借用到低资源场景以扩充训练数据。然而,回译生成的新文本在词汇和句法上都会发生偏移,可能改变代词所指、实体描述方式或篇章衔接关系。对于指代消解这类需要精确保持实体指称一致性的任务,回译可能引入指代歧义或破坏跨句实体链,这正是本研究中增强手段失效乃至有害的潜在机制。
多语言模型的嵌入空间隐患
研究还揭示了一个更底层的问题:若干广泛使用的多语言模型出现了嵌入空间坍缩(collapsed embedding space),即不同输入的表示高度趋同,导致它们不适合基于相似度的聚类任务。指代消解中的实体聚类正依赖这类能力,因此嵌入坍缩会直接损害模型表现。
这一发现提醒开发者,多语言模型在基准测试上的平均分数可能掩盖了表征层面的缺陷。在选择编码器时,有必要针对具体任务检查其嵌入空间的分布特性,而非只看通用评测结果。
嵌入空间坍缩(Embedding Space Collapse) 指模型对不同输入产生的表示向量高度趋同,导致向量间的区分度下降。在理想情况下,语义不同的输入应在嵌入空间中占据不同区域;发生坍缩时,大量输入的表示挤在狭窄区域内,余弦相似度普遍偏高,基于相似度的聚类、检索和匹配任务因此难以区分正负样本。这一现象在多语言模型中可能源于训练目标过度优化语言无关性,或表征维度利用率不足。检测方法包括观察向量分布的方差、计算随机样本对的平均相似度,或可视化降维后的嵌入分布。对本研究而言,坍缩直接削弱了模型区分不同实体提及的能力。
对低资源NLP实践的启示
综合来看,这项研究为低资源语言的指代消解系统开发提供了几条经验性指引:优先投资高质量标注而非数据规模;对数据增强保持审慎,尤其在依赖篇章结构的任务上;跨语言迁移需要逐模型验证,不能默认生效;多语言编码器的选择应结合任务特性做表征诊断。
这些结论虽然来自孟加拉语,但其方法论对其它低资源语言具有参考价值。研究的更大意义在于,它把“多语言模型天然通用”和“数据多多益善”这两个隐含假设摆上台面,用实验数据要求社区重新审视。
常见问题
这项研究是否意味着数据增强在低资源NLP中完全无效? 并非如此。研究针对的是指代消解任务中的回译增强,结论不能直接推广到所有任务。依赖篇章一致性的任务可能对增强更敏感,而句子级任务或许仍有收益。
为什么多语言模型的嵌入空间会坍缩? 原文未展开具体成因,但指出这一现象使模型不适合相似度聚类。实践中的应对方式是针对目标任务做表征检查,而非依赖模型宣传的通用能力。
高质量小数据具体指什么规模? 原文强调“少量高质量标注数据”显著优于“更大规模混合质量数据”,但未给出具体数量对比。核心信息是质量优先于数量这一方向性结论。
相关推荐
思科高管:不用AI就守不住安全,漏洞利用窗口仅八九分钟
思科安全负责人 Jeetu Patel 指出,漏洞公布到被利用仅八九分钟、平均补丁周期约 45 天、仅 20% 漏洞被修补,攻防速度差已让静态安全策略失效。他主张安全控制与策略必须智能体化、动态化,并以 OpenAI 作为底层基础支撑这一转向。
Jev AI的校准概率:输出0.8意味着80%正确率
Jev AI 的核心特性是校准概率:输出0.8意味着约80%的正确率。这种可测量的置信度让开发者能在真实代码库中自信使用 Jev,并为阈值设定和工程决策提供可解释的依据。
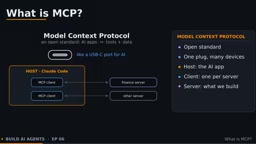
30行Python自建MCP服务器并接入Claude Code
用约30行Python把财务工具封装成MCP服务器,并通过stdio传输接入Claude Code。本文拆解MCP的三种角色与Tools、Resources、Prompts三类能力,讲解装饰器与类型提示的用法、MCP Inspector自测流程,以及claude mcp add的命令格式与作用域设置。