Meta FAIR自改进记忆机制让模型自己写记忆策略
Meta FAIR 让模型自生成记忆调度提示并蒸馏进权重,在持续学习基准上超越人工框架。
Meta FAIR 公布 Self-Improving Memory 研究,把持续学习中的记忆调度逻辑从人工框架转交给模型自身:由 Kimi-K2.6 自行生成 LOAD(载入上下文)与 OFFLOAD(卸载到长期存储)两类提示,系统筛选后将有效策略蒸馏回模型权重。在 Continual Learning Bench 上,自生成提示取得 56.0 分,高于最佳人工编写框架的 44.6 分。蒸馏是关键一步,使记忆管理从推理时的外部规则变为模型内在能力,推理阶段无需额外框架即可复现。作者同时提醒,结果仅来自单一评测集,任务构成与消融细节未披露,跨任务、跨规模泛化性以及可解释性和安全性仍需进一步验证。
Meta FAIR 公布了一项名为 Self-Improving Memory 的研究,让模型自行生成 LOAD 与 OFFLOAD 两类记忆操作提示,并将其蒸馏回模型权重。在 Continual Learning Bench 上,这套机制得分 56.0,相比最佳人工编写记忆框架的 44.6 有明显提升。
记忆管理为何要交给模型自己
持续学习场景里,模型需要在多轮任务中保留关键信息、丢弃无关内容,传统的做法是由研究者手写一套记忆调度框架(harness),规定何时把信息载入上下文、何时卸载到外部存储。这类人工框架依赖经验,难以适配所有任务形态。
Meta FAIR 的思路是把这套调度逻辑交给模型本身:让 Kimi-K2.6 自己生成 LOAD(载入)和 OFFLOAD(卸载)两类记忆提示,再由系统筛选、蒸馏进模型权重。换言之,模型不仅使用记忆,还参与设计自己的记忆策略。
LOAD 与 OFFLOAD:两种记忆动作
据 MarkTechPost 的报道,Self-Improving Memory 的核心是两类可自生成的提示。LOAD 提示负责决定哪些信息应该被调入工作上下文,OFFLOAD 提示则负责判断哪些内容应从上下文中移出、转入长期存储。
模型生成提示后,系统并不直接采纳,而是通过蒸馏把有效的提示策略固化到权重中。这一闭环让记忆管理从"外部规则"变成"模型内在能力",减少了对手工框架的依赖。
知识蒸馏(Knowledge Distillation)是这一机制落地的底层技术。其基本做法是让一个“教师”信号去指导“学生”模型的参数更新,使原本需要外部流程才能实现的行为被压缩进权重。在本例中,教师信号来自模型自行生成并经筛选的记忆提示策略,学生则是同一模型的权重。蒸馏通常通过最小化学生输出与教师目标分布之间的差异来实现,常见目标包括前向 KL 散度或交叉熵。相比在推理时动态拼接提示,蒸馏的优点是推理开销固定、行为可复现,代价是需要额外的训练环节,且策略一旦固化就不易在运行时快速调整。
56.0 对 44.6:与人工框架的差距
公开数据显示,优化后的自生成提示在 Continual Learning Bench 上取得 56.0 分,而最佳人工编写框架为 44.6 分。这一差距说明,模型自发探索出的记忆调度策略,在特定评测上已经超过人类手工设计的方案。
说一下,该结果来自单一评测集,跨任务、跨模型规模的泛化能力仍需更多验证。报道也未披露评测的具体任务构成与消融细节,因此不宜过度外推。
持续学习(Continual Learning)指模型按顺序接触多个任务或数据流,并在不遗忘旧知识的前提下吸收新知识,其核心矛盾是稳定性与可塑性之间的权衡。常见的灾难性遗忘问题,就是模型在新任务上更新后迅速丢失旧任务能力。评测持续学习通常考察任务序列上的平均表现、后向迁移(新任务对旧任务的影响)与前向迁移(旧任务对新任务的帮助)。因此,“Continual Learning Bench”这类基准的分数高低,往往不仅反映记忆保留能力,也反映信息调度与迁移效率。理解这一点,有助于判断 56.0 与 44.6 的差距究竟来自记忆保真还是任务间迁移。
蒸馏才是关键一步
自生成提示的价值不只在于分数,更在于蒸馏机制。如果提示只停留在推理阶段,模型每次都要重新生成、筛选,成本高且不稳定;把有效策略蒸馏进权重后,记忆管理成为模型的一部分,推理时无需额外框架即可复现。
这条路径与当前业界把推理能力内化的趋势一致:先让模型在外部探索出好策略,再压缩回参数。区别在于,这次被内化的是记忆调度,而非单纯的推理步骤。
对持续学习研究的启示
这项工作提示了一个方向:记忆框架的设计未必需要完全由人完成,模型可以在评测反馈下自行搜索策略。对于需要长期交互的智能体场景,这种自改进记忆机制有望降低工程侧的规则维护成本。
不过,自生成提示的可解释性与安全性同样值得关注——模型自主决定保留或丢弃信息,可能带来信息遗漏或偏好固化的问题,这需要后续研究给出约束手段。
智能体(Agent)场景对记忆的要求与单轮问答不同:它需要跨会话保持状态、在有限上下文窗口中取舍信息,并对外部存储进行读写。常见的工程做法是维护向量数据库做检索增强,或设计摘要与压缩流程来控制上下文长度。自生成 LOAD/OFFLOAD 策略实际上是把“何时检索、何时写入、何时丢弃”这些原本由提示词和规则硬编码的决策,交给模型在反馈中学习。这类机制与记忆增强、工具调用结合后,可能影响智能体的长期一致性与成本结构,但也对存储一致性和遗忘边界提出更高要求。
相关推荐
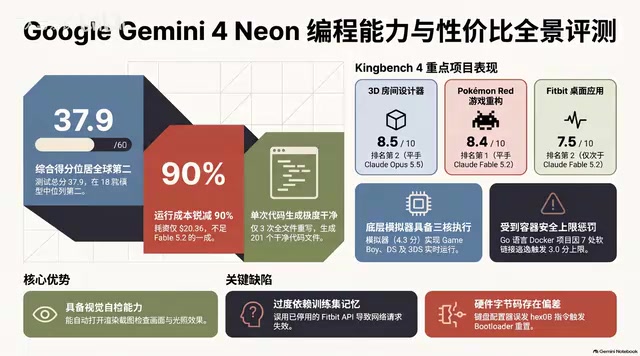
Gemini 4 Neon实测:性价比之王还是自信的灾难?
Gemini 4 Neon 实测深度解析:百万 token 上下文、四档思考级别,KingBench4 一遍过写 201 个文件,成本仅为 Fable 5.2 的十分之一。但它会靠幻觉假数据蒙混、留下 7 个符号链接逃逸漏洞、把键盘写成砖。性价比与危险并存,多模型议会审查才是破局关键。
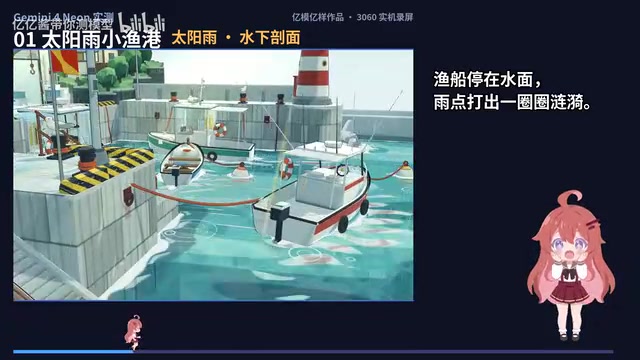
谷歌Gemini 4 Neon实测:6个3D作品惊艳与翻车
谷歌Gemini 4 Neon在3060笔记本上实测6个3D作品:太阳雨渔港细节惊艳,机械键盘配置器完成度高,但软糖物理形变过头、帝王像人脸偏方。多源测评交叉验证,审美在线但物理与人脸是短板。
Gemini 4 Neo写小说网文实测:AI味淡、对话有质感
B站UP主首发测评Gemini 4 Neo写小说网文能力:实测三国穿越开篇生成,AI味淡、对话有情绪质感、危机感塑造到位,并对比4A/4H/4C四个模型差异,演示拆纲续写与审稿纠错全流程。