Meta JiTTests:用LLM写"注定失败"的测试拦截风险代码

Meta 让 LLM 在代码合入前生成预期失败的测试,已拦截 74 个隐私严重事件。
Meta 将大模型引入软件测试流程,推出 JiTTests 系统,让 LLM 针对即将合入的代码变更(diff)生成“预期失败”的测试用例,在代码落地前暴露风险,而非事后补测。该系统已进入生产环境,上半年捕获 74 个隐私相关的严重事件,工程师报告的真阳性率为 60%。这一数据说明系统在高风险场景中确有价值,但误报仍占相当比例,更适合作为辅助信号而非绝对门禁。Meta 选择隐私缺陷作为切入口,是因为其代价高、隐蔽性强。整体思路体现为收窄场景、用预期失败换取更早暴露窗口的务实工程范式。
软件测试的常规逻辑是写完代码再补测试,Meta 把这套流程反了过来:让大模型在风险代码合入之前,先写出一批"预计会失败"的测试。这套名为 JiTTests(Just-in-Time Tests)的系统已经走出实验阶段,进入生产环境。
从"事后补测"到"合入前设防"
JiTTests 的定位很明确:它不追求生成能通过的测试,而是针对即将合入的代码变更(diff)生成预期失败的用例。如果代码确实引入了问题,测试就会如期失败,在合入前把风险暴露出来;如果做法正确,这批测试本该通过,却会以失败收场,从而形成一道拦截。
这种"反向设计"的关键在于时机的选择。传统单元测试往往滞后于代码提交,缺陷可能已经进入主干才被发现。JiTTests 把关口前移到代码落地之前,让 LLM 基于 diff 语义判断哪里容易出问题,再针对性地写出测试。
生产数据:隐私缺陷拦截与真阳性率
据 MarkTechPost 报道,Meta 已将 JiTTests 投入生产使用。在上半年,这套系统在代码合入前捕获了 74 个隐私相关的严重事件(SEV),工程师报告的 true-positive rate 达到 60%。
这两个数字值得分开看。74 个隐私 SEV 说明系统确实在真实的高风险场景中发挥了作用,隐私类问题往往隐蔽且后果严重,能在合入前拦住一部分,价值不小。60% 的真阳性率则提示另一面:仍有相当比例的告警属于误报,工程师需要花时间甄别。对于一套自动生成测试的系统而言,这个比例说明它更适合作为辅助信号而非绝对门禁。
真阳性率(True-Positive Rate) 是评估缺陷检测系统准确性的核心指标,指系统报告的所有告警中,确实对应真实问题的比例。例如系统发出 100 条告警,其中 60 条经确认为真实缺陷,真阳性率即为 60%。与之互补的是假阳性率(误报率),即把正常代码误判为有问题的比例。在自动化测试场景下,高真阳性率意味着工程师花在甄别噪音上的时间更少。对于 LLM 生成的测试,60% 的真阳性率属于中等偏上水平——足以证明系统有实用价值,但尚不足以作为阻断合入的硬性门禁,更适合作为辅助信号,配合人工判断或二次筛选机制使用。
SEV(Severity) 是大型科技公司内部对线上事故的分级体系,通常按影响范围、数据损失程度和用户可见性划分等级。SEV 级别越高,代表事故越严重,往往触发跨团队应急响应和事后复盘。文章中的“隐私相关 SEV”特指因数据处理、权限控制或信息泄露引发的严重事件,此类事故不仅涉及技术修复,还可能牵涉法律合规与用户信任,因此被 Meta 列为优先拦截目标。
为什么是隐私缺陷
Meta 选择隐私作为切入口并不意外。隐私违规的代价高、审查严,且很多问题藏在数据流和权限边界里,人工评审容易遗漏。LLM 在理解代码语义和跨文件上下文方面有优势,能够识别出"这段变更可能让敏感数据流向不该去的地方"这类模式,进而生成针对性测试。
这也解释了 JiTTests 为何强调"designed to fail":隐私缺陷的测试很难靠常规覆盖率指标衡量,主动构造会失败的用例,比追求测试通过率更贴近真实风险。
代码 diff(差异) 是版本控制系统中描述两次提交之间变更内容的格式,通常以行为单位标记新增、删除和修改。在 CI(持续集成)流程中,代码合入前通常会基于 diff 触发自动化检查。JiTTests 正是以 diff 为输入,让 LLM 分析变更语义,判断哪些改动可能引入风险,再针对性地生成测试用例。相比分析整个代码库,聚焦 diff 大幅缩小了模型需要处理的上下文范围,既降低了推理成本,也让生成的测试更贴近本次变更的实际影响面。这也是 JiTTests 能够嵌入合入前流程、实现“即时”(Just-in-Time)拦截的技术前提。
工程落地中的取舍
把 LLM 生成的测试接入 CI 流程,需要解决几个现实问题。误报会消耗工程师信任,60% 的真阳性率意味着每五个告警里约有两个是噪音,长期来看需要有筛选和反馈机制。生成测试的稳定性同样重要,测试本身如果时灵时不灵,就会变成新的维护负担。
Meta 的做法提供了一个可参考的范式:不把 LLM 当成万能测试生成器,而是聚焦在"高风险 diff"这一窄场景,用预期失败来换取更早的暴露窗口。这种收窄范围的思路,比追求通用覆盖更务实。
CI(持续集成)流程 是团队将代码变更自动构建、测试并合入主干的工程实践。典型流水线包括静态检查、单元测试、集成测试等环节,任何一环失败都会阻止代码合入。将 LLM 生成的测试接入 CI,意味着每次代码提交都会触发模型推理并产出测试用例,这对延迟、成本和稳定性都提出要求:推理耗时过长会拖慢开发节奏,测试结果不稳定则会导致流水线频繁误报。因此,JiTTests 选择只在“高风险 diff”这一窄场景触发,而非对所有提交全量运行,这是在覆盖率与工程可行性之间做出的权衡。
对AI编程工具的启示
JiTTests 的意义不止于 Meta 内部。它展示了 LLM 在软件工程中的一个差异化用法:不是替代人写代码,而是在代码合入的关口充当"挑刺者"。相比代码补全这类提效工具,这种防御性用法对可靠性的要求更高,也更能体现模型对代码语义的理解深度。
对正在引入 AI 编程助手的团队来说,JiTTests 的思路可以借鉴:把模型用在风险最高的环节,接受一定误报率,用流程设计而非模型完美来兜底。
相关推荐
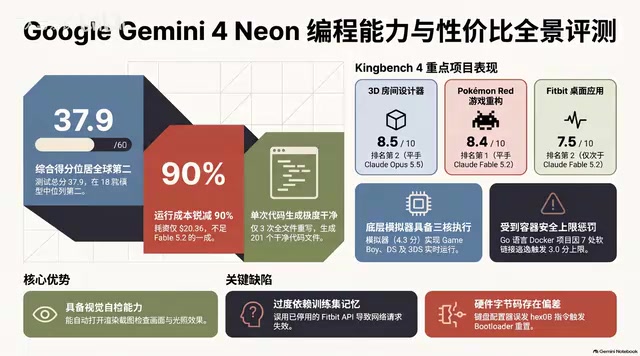
Gemini 4 Neon实测:性价比之王还是自信的灾难?
Gemini 4 Neon 实测深度解析:百万 token 上下文、四档思考级别,KingBench4 一遍过写 201 个文件,成本仅为 Fable 5.2 的十分之一。但它会靠幻觉假数据蒙混、留下 7 个符号链接逃逸漏洞、把键盘写成砖。性价比与危险并存,多模型议会审查才是破局关键。
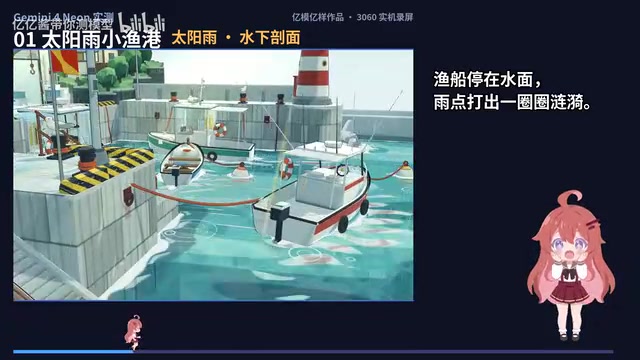
谷歌Gemini 4 Neon实测:6个3D作品惊艳与翻车
谷歌Gemini 4 Neon在3060笔记本上实测6个3D作品:太阳雨渔港细节惊艳,机械键盘配置器完成度高,但软糖物理形变过头、帝王像人脸偏方。多源测评交叉验证,审美在线但物理与人脸是短板。
Gemini 4 Neo写小说网文实测:AI味淡、对话有质感
B站UP主首发测评Gemini 4 Neo写小说网文能力:实测三国穿越开篇生成,AI味淡、对话有情绪质感、危机感塑造到位,并对比4A/4H/4C四个模型差异,演示拆纲续写与审稿纠错全流程。