Meta Muse Wonder 深度评测:长编码称王,但全能性不及 Opus 5.5

Meta Muse Wonder 长编码领先,但整体未夺第一,事实知识是短板。
Meta 发布的 Muse Wonder 分常规版与仅限订阅的 Full 版,后者不开放 API,新闻高分多来自 Full。在 Artificial Analysis 综合指数上 Full 得 56 分,落后 Claude Opus 5.5 的 58 分,与 Sonnet 5.5 并列;常规版仅 52 分。Full 在长编码 SWE Marathon 以 57.5 大幅领先 Opus 的 46.3,法律代理测试也占优,但测试条件不完全统一。事实知识是明显弱项,AA Omniscience 仅 30 分,远低于 Opus 的 46 分;Terminal Bench、OS World 等也被 Opus 或 Astra 反超。成本上 Wonder 每任务约 4.52 美元,低于 Opus 的 6 美元,高于 Astra 的 3.26 美元,Gemini 4 Argon 发布价最低约 2 美元。结论是 Full 适合长时代理编码,常规版性价比一般。
Meta 于 10 月 12 日发布了全新 AI 模型家族 Muse Wonder,官方称其为迄今最强大的模型,专为个人和专业代理场景设计,能执行长时间、多步骤任务。但这款模型并非简单的“更强 GPT 杀手”——它实际上包含两个版本,且各有明确的优势与短板。本文基于独立测评数据,拆解 Muse Wonder 的真实表现,并与 Claude Opus 5.5、GPT-6 Astra、Gemini 4 Argon 展开横向对比。
两个版本,别被高分误导
Muse Wonder 家族有两个成员:常规版 Muse Wonder 和更强的 MuseWonderFull。常规版可通过 Meta API、OpenRouter 以及所有 MuseCode 套餐使用;Full 版则仅限 MuseCode 的 PowerPlan(50 美元/月)或 MaximumPlan(200 美元/月)订阅,不提供 API 按 token 计费,Meta 也未公布其单价。
这带来一个关键陷阱:新闻报道中的高分通常属于 Full 版,而大多数开发者无法按 token 购买 Full。因此看到“Muse Wonder 得分 XX”时,务必先确认是哪个版本。
API 按 token 计费是当前大模型最主流的商业形态:用户按实际消耗的输入、输出 token 数量付费,可自由集成到任意应用,不绑定特定客户端。与之相对的订阅制则按固定月费提供打包额度或无限使用,通常限定在厂商自家的产品界面内。Full 版只走订阅、不开放 API,意味着开发者无法把它嵌入自己的流水线,只能在 MuseCode 里使用;同时其单位成本被订阅费“摊薄”,无法像常规版那样与其他模型做每 token 价格的直接比较。这也是为什么文章反复强调要先确认分数来自哪个版本——一个不可按量购买的模型,其跑分对大多数工程团队的可操作性有限。
Plan 分级(PowerPlan 50 美元、MaximumPlan 200 美元)通常对应不同的使用配额、并发数或功能权限,订阅前应核对额度是否覆盖你的实际调用量,避免高分模型因额度限制而无法用于生产。
核心功能:主动记忆与长任务代理
Muse Wonder 主打四项能力。主动记忆让模型跨对话携带关键信息,省去反复解释项目的麻烦。主动聚焦指遇到难题时持续尝试不同路径并从错误中恢复,Meta 强调它会在重要操作前征求确认,在独立性和可控性之间取得平衡。
代理工作是重点:模型可规划长任务、将子任务分派给小型子代理,并操作真实软件(浏览器、桌面应用、移动应用)。Meta 点名了法律、金融、健康场景,以及从小游戏到完整商业应用的编码任务。上下文窗口约 100 万 token,足以容纳数本长书或大型代码库。输入支持文本和图像(部分来源称还支持视频和音频),输出仅限文本——不生成图像、音频或视频。
定价与真实成本:标价之外看每任务开销
API 定价上,Muse Wonder 为每百万输入 token 4 美元、输出 20 美元,与 Claude Opus 5.5 标价持平。GPT-6 Astra 标价 10/50 美元,是前两者的 2.5 倍。Gemini 4 Argon 有 2/10 美元的发布特价,但 11 月 30 日截止,12 月 1 日起涨回 4/20 美元。
标价只讲了一半故事。Artificial Analysis 测量了单测试任务的平均成本:Muse Wonder 约 4.52 美元,Opus 5.5 约 6 美元,GPT-6 Astra 约 3.26 美元(因 token 用量少得多),Gemini 4 Argon 最低约 2 美元(按发布价)。结论是:Wonder 实际使用比 Opus 便宜,但比 Astra 贵,当前也不如 Argon 划算。
性能实测:长编码领先,整体排名第二梯队
在 Artificial Analysis 的综合 Intelligence Index 上,Claude Opus 5.5 以 58 分居首。MuseWonderFull 得分 56,与 Claude Sonnet 5.5 并列;GPT-6 Astra、Gemini 4 Argon 和 Claude Fable 5.5 各约 53 分;常规版 Muse Wonder 仅 52 分,Meta 前代 Muse Spark 1.3 为 48 分。Full 版进步明显,但并未超越 Opus。
Full 版的真正优势在长编码。SWE Marathon 测试中 Full 得分 57.5,常规版 53.1,而 Opus 5.5 仅 46.3,GPT-6 Astra 42.5——差距显著。但需注意两点:Full 的成绩是在“Extra High Effort”设置下取得,且各模型运行于不同编码工具,并非统一环境,因此应视为强信号而非精确测量。另一项由外部团队执行的 Deep SWE 测试中,Full 得 79.5,常规版 78.8,均领先 Opus 的 74.2 和 Astra 的 74.1。
法律代理测试 Harvey Lab 极为严格,Full 得分 13.1,远高于 Astra 的 8.6 和 Opus 的 4.2(分数低是因为要求所有标准均满足)。Meta 自家表格中的业务自动化测试,Full 得 45.4,Astra 41.6,Opus 41.2,常规版 39.1 落后于两个对手。Artificial Analysis 对疑似同测试的另一版本给出了不同数字,需谨慎看待。即便最高分也意味着超过一半工作流失败,人工检查仍不可少。
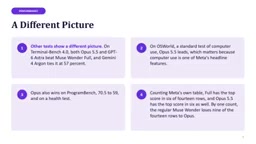
其他测试则呈现不同图景:Terminal Bench 4.0 上 Opus 5.5 和 GPT-6 Astra 均优于 Full,Gemini 4 Argon 与 Full 并列 57%;计算机使用标准测试 OS World 中 Opus 领先——这恰恰是 Meta 的主打功能之一;Program Bench 上 Opus 以 70.5 比 59 胜出,健康测试同样领先。统计 Meta 自家表格,Full 在 14 行中拿下 6 行最高分,Opus 5.5 拿下 10 行;常规版 Muse Wonder 对 Opus 输掉 14 行中的 9 行。
Intelligence Index 是 Artificial Analysis 维护的综合能力评分,把多个独立基准(推理、编码、知识、代理任务等)归一化后加权合成一个分数,便于跨模型横向比较。它的价值在于“一站式”概览,局限在于权重由评测方设定,不同任务偏好的用户可能得出不同结论——高分不等于在你关心的细分场景更强。
SWE Marathon 类基准模拟长时间、多步骤的软件工程任务(如需跨多个文件修改、反复调试并保持上下文一致),更贴近真实开发流程,因此与单轮代码题基准结论常有分歧。Terminal Bench 侧重在命令行环境中完成操作序列,OS World 评测图形界面下的计算机操作能力,Program Bench 则考察程序级推理与实现。这些基准各自覆盖代理能力的不同侧面,正是文章中出现“同一模型在不同测试上互有胜负”的原因。
还需注意推理强度设置(如 Extra High Effort)会显著影响成绩与成本:更高强度通常意味着更长的思维链、更多 token 消耗和更高延迟,跨模型比较时必须对齐这一参数,否则分数不具可比性。
短板明确:事实知识差距大
事实知识是 Muse Wonder 最明显的弱项。AA Omniscience 测试奖励正确答案、惩罚错误回答:Full 仅得 30 分,常规版 25 分,而 Opus 5.5 得 46 分,GPT-6 Astra 43 分,Gemini 4 Argon 42 分。差距一目了然。新模型比 Spark 编造更少,但确实比对手“记得少”。若你需要模型凭记忆回答事实性问题,务必预留额外核查环节。
速度方面表现尚可:最大推理强度下约 100 token/秒,但首个 token 可能需等待约 20 秒,难题起步慢、后续快。
AA Omniscience 是一类“惩罚性”事实知识基准:不仅看答对多少,还对自信的错误回答扣分,因此分数低往往反映模型倾向编造而非承认不知道。这类测试与幻觉问题直接相关——模型在缺乏依据时生成看似合理的内容。分数偏低意味着模型内部存储的事实覆盖面较窄或召回不稳定,对依赖模型“凭记忆”回答的问答、客服、检索增强场景是实质风险。实务上的应对是接入检索工具、要求引用来源、并在关键结论上设置人工或程序化核查环节。
与三大竞品逐一对决
对比 Claude Opus 5.5:Opus 在独立指数上是更强的全能模型,事实知识遥遥领先。Full 版在长编码、法律代理和工作流自动化上胜出。常规版 Wonder API 标价与 Opus 相同但综合分更低,仅在 Deep SWE 上略占优。要最佳通用模型,Opus 是更稳妥的选择;若你的工作局限于 MuseCode 内的长编码项目,Full 值得认真测试。
对比 GPT-6 Astra:Full 指数 56 对 Astra 53,SWE Marathon 和 Deep SWE 明显领先。但 Astra 在 Terminal Bench 上胜出,事实知识更强,独立测试中每任务成本更低——尽管其标价高得多。常规版 Wonder 52 分略低于 Astra,因此通用场景 Astra 性价比更高,马拉松编码则 Full 更合适。
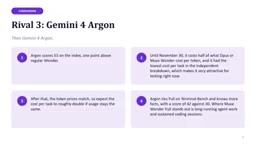
对比 Gemini 4 Argon:Argon 指数 53,比常规版 Wonder 高 1 分。11 月 30 日前其 token 价格仅为 Opus/Wonder 的一半,且独立测试中每任务成本最低,当下测试极具吸引力。此后 token 价格持平,同等用量下每任务成本预计翻倍。Argon 在 Terminal Bench 与 Full 并列,事实知识 42 分对 30 分占优。Full 的独特优势在于长时间代理运行和持续编码会话。
值得一提,MuseWonderFull 与 Claude Sonnet 5.5 在指数上并列 56 分——这说明 Full 是紧咬第一梯队的竞争者,拥有几项明确强项,而非跨越式领先。
适用人群与最终判断
适合:需要长时间代理运行构建软件、审阅大规模文档集、执行多步骤法律或金融工作的团队,MuseWonderFull 值得实测。不适合:主要需求是快速问答、强事实知识或图像视频生成的用户,其他模型更合适。
最终结论:MuseWonderFull 是严肃的模型,在长编码领域是领跑者,但未拿下整体第一。常规版 Muse Wonder 是定价合理的可靠代理模型,却非市场最优性价比。Meta 已明确抵达前沿,但仍有差距待补。Meta 表示完整安全报告与额外评估稍后发布,许多亮眼数字来自自家表格——在更多独立测试出炉前,建议用你自己的真实任务做对比:跑一遍 Muse Wonder,再跑 Opus 5.5、Astra 或 Argon,核对成本与准确率后再做决定。
相关推荐

Gemini 4 Argon API实战:思考等级、后台模式一次讲透
Free Code Camp 出品的 Gemini 4 Argon API 速成教程:从申请密钥、发送首次请求,到用思考等级控制推理成本、用 previous_interaction_id 实现多轮对话,再到后台模式一句话生成打砖块游戏,附 Google 工程师对模型能力的解读。

强化学习通关《抡大锤》:63%进度背后的分布式训练策略
开发者用深度强化学习挑战《抡大锤》,智能体从底部攀爬至63%进度,卡在铁砧部分。项目开源,采用分治训练和CPU训练策略,寻求社区协作突破瓶颈。

AAAI 2027二审放榜在即:社区热议评审公平与投稿生态
AAAI 2027第二阶段评审结果即将公布,Reddit社区热议评审一致性与流程透明度。本文梳理放榜前的社区情绪、顶会评审的结构性矛盾,以及作者应对二审结果的务实策略。