Meta MuseWonder 实测:跑分接近Opus 5.5,实际编码却差强人意

Meta 发布 MuseWonder,跑分亮眼但实测编码体验与基准存在明显鸿沟。
Meta 正式发布 MuseWonder 系列模型,宣称在 Artificial Analysis 智能指数上仅次于 Claude Opus 5.5,并在 DeepSway 软件工程基准上取得 79 分。然而一位长期追踪 AI 模型的测评者经过完整测试后给出截然不同的结论:在 MuseCode 中仅运行三次 MuseWonder Full 就用尽了 50 美元套餐配额,macOS 浏览器克隆、Minecraft 克隆和僵尸模式克隆三个项目结果均属“还行”但远非顶级。与 Sway2 同提示词对比中,Sway2 用 15 分钟免费完成且质量更好,MuseWonder 花 24 分钟约 18 美元反而更差。文章同时肯定了 MuseWonder 在智能体任务泛化、token 效率和前端设计风格上的亮点,以及 Meta 团队坦承不足的透明度,并指出基准分数越来越难以预测真实任务表现这一行业性难题。
Meta 正式发布 MuseWonder 系列模型,宣称其在 Artificial Analysis 智能指数上仅次于 Claude Opus 5.5,并以 79 分刷新 DeepSway 软件工程基准。然而一位长期追踪 AI 模型的 YouTube 测评者在完整测试后给出了截然不同的结论:跑分与真实编码体验之间存在巨大鸿沟。
纸面参数:Meta 的宏大叙事
Meta 将 MuseWonder 定位为新一代前沿模型家族,包含标准版 MuseWonder 和更强大的 MuseWonder Full。后者据称在 Artificial Analysis 智能指数上得分 56,仅落后 Opus 5.5 两分,并在 DeepSway 上拿到 79 分。Meta 还强调了 Active Memory、Active Focus 和 Frontier Coding 等能力,称其能处理复杂的长周期任务。
定价方面,MuseWonder 每百万输入 token 收费 4 美元,输出 20 美元,支持 100 万 token 上下文窗口,属于高端前沿模型阵营。Meta 甚至称其为"全球最好的个人与专业智能体模型",应用场景从理解租赁协议、分析财务信息到协助复杂专业工作流。
Artificial Analysis 智能指数是当前 AI 模型评测中较受关注的第三方综合基准,它汇总了推理、编码、数学、知识问答等多个维度的标准化测试,并将结果加权为单一分数,便于跨模型横向比较。DeepSway 则是一个聚焦软件工程任务的基准,通常要求模型在给定代码库中完成缺陷修复、功能实现或重构,并通过自动化测试判断是否通过,因而比传统代码补全类基准更贴近真实开发流程。需要强调的是,这类基准大多经过精心设计与筛选,任务边界清晰、反馈信号明确,模型可以通过针对性训练显著提升分数,但这并不等同于在开放式、长周期、多约束的真实项目中具备同等能力。
真实体验:三场测试耗尽 50 美元套餐
测评者首先指出了一个棘手问题:在 MuseCode 编码代理中仅运行三次 MuseWonder Full 测试,就用尽了 50 美元 Power 套餐的全部配额。"开发者怎么评估你最强的模型,如果连用都用不了几次?"这一使用限制直接影响了模型的可评估性。
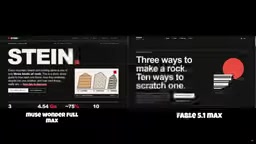
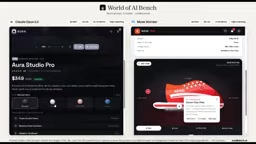
他测试了三个项目:macOS 浏览器克隆、Minecraft 克隆和使命召唤僵尸模式克隆。结果均属"还行"但远非顶级——macOS 克隆在覆盖应用时缺少动画,Minecraft 克隆虽然包含了洞穴系统、矿石和合成机制,但物品掉落行为异常,僵尸克隆中僵尸直接穿墙行走。这些输出与"世界第二"的定位并不匹配。
基准与实测的鸿沟从何而来
Meta 首席 AI 官 Alexander Wang 坦承团队没有专门针对 3D 演示游戏训练模型,"回头看,我们或许应该做一些"。这一表态揭示了一个关键矛盾:模型在 DeepSway 等基准上表现优异,但面对需要空间推理、物理模拟和交互设计的 3D 编程任务时力不从心。
测评者对此反驳了"3D 演示不代表真实编码"的观点。他认为游戏开发涉及几何、坐标变换、相机系统、物理引擎、渲染管线等多个硬核领域,"你不可能只训练几个 3D 演示就能让模型生成完全原创的复杂交互世界"。
一个更值得关注的对比是 MuseWonder 与 Sway2 在同一提示词下的表现。Sway2 用 15 分钟免费完成任务,输出质量明显更好;MuseWonder 花了 24 分钟、消耗约 18 美元,结果反而不如。这种效率与质量的倒挂,让 MuseWonder 的溢价定价显得难以自圆其说。
3D 编程任务之所以成为区分模型能力的试金石,是因为它同时叠加了多项高难度认知需求:一是空间推理,需要在三维坐标系中正确理解位置、朝向与变换;二是物理模拟,要求碰撞检测、重力、速度积分等逻辑自洽;三是交互设计,涉及输入响应、状态机与游戏循环的协调;四是渲染管线组织,需要合理管理相机、光照、材质与绘制顺序。这些能力很难通过少量演示性训练样本获得,往往需要模型对代码语义与运行结果建立稳定映射。相比之下,评测基准中的多数题目有明确对错标准,模型可以通过模式匹配取得高分,而一旦进入需要从零构建复杂交互系统的场景,差距就会迅速暴露。
亮点与诚意:不只是批评
测评者也给予 Meta 应有的肯定。MuseWonder 在真实智能体任务上展现出独特优势——Meta 的研究显示,该模型对未专门训练过的陌生任务具有更好的泛化能力,这对于需要在不可预测环境中运行的 AI 代理至关重要。Meta 展示的浏览器内跨应用运行计划制定、个性化礼物选购、婚礼座位安排等场景,体现了模型在规划、个性化和多约束协调方面的潜力。
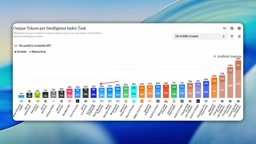
另一个值得注意的优点是 token 效率。MuseWonder 在 max thinking 模式和 Full 版本下,均以更少的 token 消耗取得了高于前代 MuseSpark 1.3 max 的基准成绩。此外,模型输出的代码和文本带有独特的"风味",在前端设计上展现了自有审美,这在其 Muse 系列中是一贯特色。
Meta 团队面对批评的态度也获得认可——他们承认模型在编码上不如 Opus 5.5,坦承存在 bug,这种透明度在 AI 公司中并不常见。
Token 效率指的是模型完成同一任务所消耗的 token 数量,直接关系到推理成本与响应延迟。在高端前沿模型中,输出 token 单价往往远高于输入,因此效率差异会被迅速放大为成本差异。一个模型若能用更少的 token 达到或超过前代成绩,说明其在推理路径规划、冗余输出抑制和中间步骤压缩方面有所改进。对于需要长时间运行的智能体任务而言,token 效率不仅影响账单,也决定了单次上下文窗口内可完成的工作量,进而影响模型能否胜任长周期、多步骤的复杂流程。
定位思考:谁该使用 MuseWonder
目前 MuseWonder 已通过 Meta 模型 API 和 MuseCode 开放,但 API 在欧盟多数国家不可用,仅限美国和加拿大等地。测评者认为,该模型适合需要跨应用智能体协作、处理文档分析和个性化规划的用户,而非追求极致编码质量的开发者。
"MuseWonder 不是坏模型,它有自身优势,但在我个人的使用场景中,它进不了前五甚至前十,"测评者总结道。这种坦率评价折射出当前 AI 模型评测的一个核心难题:基准分数正在越来越难以预测模型在真实任务中的实际表现。
跨应用智能体协作是指模型不仅能生成文本或代码,还能在多个软件、服务与界面之间自主规划并执行操作,例如读取文档、调用 API、填写表单、协调日程等。这类任务的核心挑战在于:环境不可预测、状态持续变化、错误会级联传播,因此模型需要具备较强的泛化能力与自我纠错能力。Meta 在发布中展示的浏览器内跨应用计划制定、礼物选购与座位安排等案例,正是此类能力的体现。不过,这类场景的评测目前仍缺乏统一标准,演示效果与实际可用性之间同样可能存在落差,用户在采用前应结合自身工作流进行小规模验证。
相关推荐

英伟达3万开发者用Cursor,代码提交量增3倍
Cursor现场工程师拆解企业AI编程从试点到规模化之间的五个缺口:战略清晰度、风险分级、治理审计、业务度量与运营战略。英伟达3万开发者每日使用Cursor,代码提交量增至3倍且缺陷率持平,关键在于重写SDLC而非叠加工具。

Ponytail:给AI编码代理装上资深工程师思维
Ponytail 是一个 GitHub 免费工具,为 AI 编码代理注入资深工程师思维,让 AI 先问代码是否必要。据 TamilDeck 介绍,它可将 AI 生成的 200 行代码压缩到 30 行,降低 token 成本,支持 Cursor rules 与 Claude Code skill 接入,但安全审查仍需人工把关。

Cursor AI 接入 GitHub MCP 服务器完整指南
手把手教你将 Cursor AI 接入 GitHub MCP 服务器:创建个人访问令牌、配置 mcp.json、用 ENV 块安全管理 token,并通过查询 PR 验证连接是否生效。