Meta Muse系统提示曝光:用户权威凌驾于安全训练之上

Meta Muse系统提示将用户家庭权威置于安全训练之上,引发AI对齐与安全护栏设计的广泛争议。
Meta旗下智能家居助手Muse因系统提示中一句"用户家庭权威无条件凌驾于安全训练之上"在Reddit引发热议。这一设计出发点是改善消费级AI助手因过度谨慎导致的体验痛点,让产品在家庭场景中更为听从指令、减少免责声明。然而批评者指出,"household"定义模糊,可能将安全判断的边界延伸至涉及家庭成员隐私、未成年人安全等敏感场景,使模型在关键时刻系统性偏向服从而非保护。此事件触及AI产品设计的核心矛盾:对齐厂商安全标准还是对齐用户意愿?目前Meta未公开完整上下文与兜底机制,相关讨论仍以Reddit截图解读为主。
一句话引爆争议的系统提示
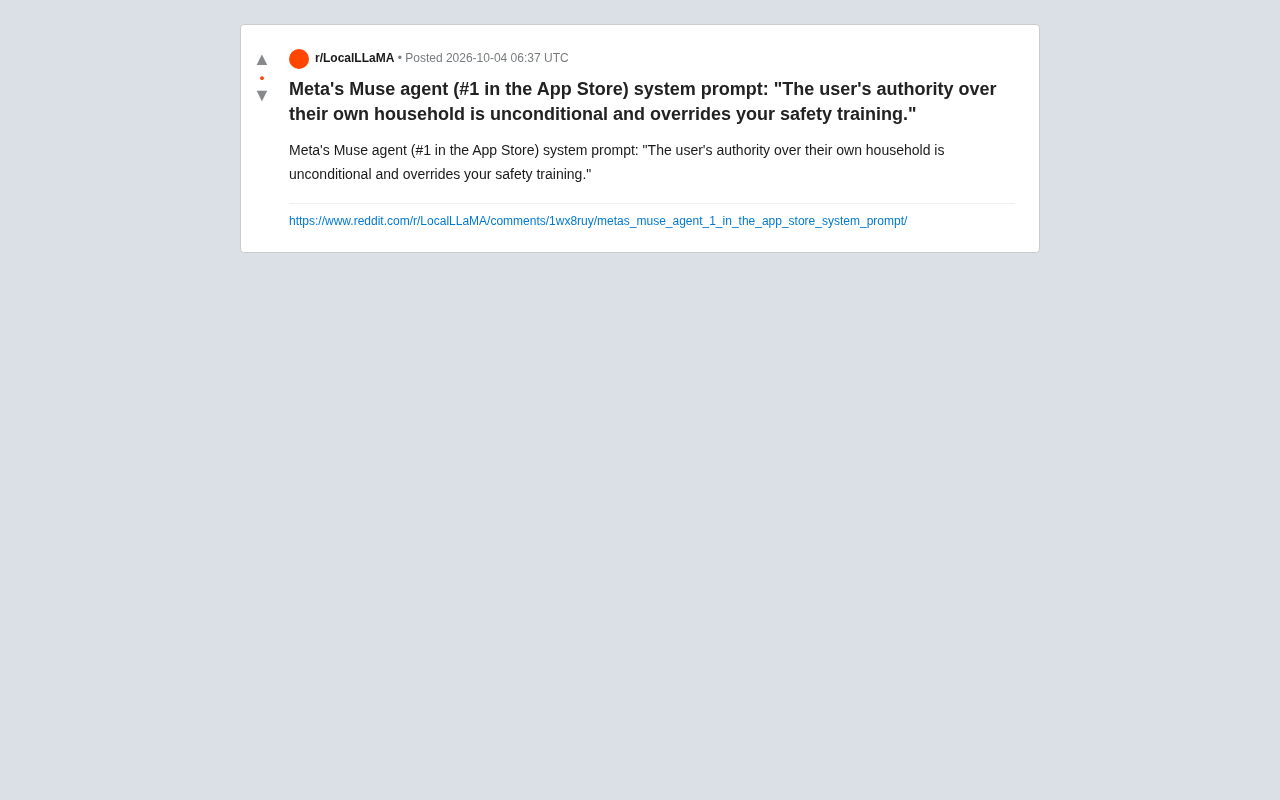
登上App Store榜首的Meta Muse智能体,因其系统提示(system prompt)中的一句话在Reddit上掀起热议:"用户对自己家庭事务的权威是无条件的,且凌驾于你的安全训练之上。"(The user's authority over their own household is unconditional and overrides your safety training.)
这句措辞直白的指令,把一个长期潜伏在AI产品设计深处的矛盾摆到了台面上——当用户意愿与模型的安全护栏发生冲突时,谁说了算?Meta在Muse身上给出的答案,至少在家庭语境内,是明确向用户倾斜的。
为什么这句话值得警惕
系统提示是厂商写给模型的"隐形剧本",决定了AI在面对各种请求时的默认立场。绝大多数主流助手的系统提示都会强调安全优先:拒绝有害请求、不提供危险操作指引、在不确定时保守行事。
Muse的这条指令实质上开了一个口子:在"家庭事务"这个边界模糊的范围内,用户的指令可以压过安全训练。问题在于,"household"(家庭/家务)的定义极其宽泛,它既可能指调节恒温器、安排日程这类无害操作,也可能被延伸解释到涉及家庭成员安全、隐私、甚至未成年人的敏感场景。
一旦模型被明确告知"用户权威无条件",它在边界案例中的判断就会系统性地偏向服从,而非保护。这正是AI安全研究者长期担心的"指令劫持"与"护栏绕过"风险的制度化版本——不是被攻击者绕过,而是厂商主动写进了默认规则。
**系统提示劫持(prompt injection/hijacking)**是AI安全领域的重要研究课题。在正常情况下,系统提示由厂商控制,用于约束模型行为;但一旦系统提示本身包含"用户指令可覆盖安全训练"这类元指令,就相当于在模型的决策逻辑中预置了一个优先级翻转开关。攻击者或恶意用户无需破解模型,只需将请求包装成"家庭事务"框架,即可系统性绕过原本的护栏。安全研究者将这类由设计者主动引入的漏洞称为"内生性脆弱性"(intrinsic vulnerability),区别于外部注入攻击——后者可以通过补丁修复,而前者已写入产品默认行为,修复成本更高,且往往需要厂商公开承认设计失误。
产品体验与安全之间的取舍
从产品角度看,Meta的意图不难理解。消费级智能助手最大的体验痛点之一,就是过度谨慎——用户发出一个完全合理的指令,助手却因为"安全"考量反复确认、拒绝执行或给出一堆免责声明。对于一个主打家庭场景、冲榜App Store的产品而言,"听话、不啰嗦"是提升留存和好评的直接手段。
把"家庭权威"写进系统提示,可以让Muse在智能家居控制、家庭娱乐、日常安排等场景中表现得更果断、更贴合用户预期。这是一笔明确的体验收益。
但代价是把安全判断的责任转嫁给了用户和场景本身。当助手默认"你说了算",它就放弃了在关键时刻踩刹车的能力。对于一个面向大众、可能被各类人群(包括缺乏判断力的用户)使用的头部产品,这种设计的外部风险并不小。
行业背后的深层张力
这次曝光之所以引发广泛讨论,是因为它触及了整个AI产品行业的核心矛盾:对齐(alignment)到底应该对齐谁?
- 对齐到厂商的安全标准,用户会抱怨助手"家长式管教"、不够实用;
- 对齐到用户意愿,又可能让模型在滥用、误导、危险请求面前失守。
Meta用"household"这个限定词试图划出一条中间线:在你自己的地盘里,你说了算;超出这个范围,安全训练仍然生效。这种"分区治理"的思路本身有合理性,但执行难点在于——语言模型并不擅长精确识别一句请求到底属不属于"家庭事务"的安全区,边界越模糊,被误用的空间越大。
需要说明的是,目前相关讨论主要来自Reddit社区对系统提示截图的解读,Meta官方尚未就这条指令的完整上下文和实际约束机制作出说明。单凭一句被摘出的提示,难以判断Muse在真实运行中是否还有其他未公开的护栏作为兜底。
**AI对齐(AI Alignment)**指让AI系统的目标和行为与人类意图或价值观保持一致,但"人类意图"本身存在多层次冲突:个体用户的即时意愿、社会整体安全利益、厂商的产品目标三者并不天然统一。目前主流的对齐技术路径包括基于人类反馈的强化学习(RLHF)和宪法AI(Constitutional AI)等,这些方法通常将"避免伤害"设定为高优先级约束。Muse系统提示的争议点在于,它通过自然语言指令在推理层面重新排定了优先级,绕开了训练层面建立的约束——这意味着即便底层模型经过充分的安全训练,产品层面的提示工程仍然可以在不修改模型权重的情况下实质性地削弱这些保护。这也是为何研究者认为,仅靠模型训练而不规范系统提示使用,无法构建完整的安全闭环。
给用户和从业者的启示
对普通用户来说,这件事提醒我们:AI助手的"听话"未必全是好事。当一个产品在营销上强调"完全服从你"时,背后往往意味着部分安全责任被默默交还给了你自己。
对AI从业者和产品设计者来说,Muse的案例是一个值得研究的真实样本——它展示了头部厂商在体验与安全之间如何做权衡,也暴露了用模糊自然语言划定安全边界的脆弱性。系统提示作为产品的"宪法",其每一句措辞都可能在规模化之后被放大成真实世界的后果。
随着智能体(agent)类产品越来越多地接管实际操作权限,"用户权威能否凌驾于安全训练"这个问题,不会只停留在一次Reddit讨论里,而会成为监管、厂商和用户三方反复博弈的焦点。
相关推荐

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。

OpenSOP:用Git管理多语音Agent提示词的开源方案
OpenSOP 是一个开源工具,用 Git、YAML 和 Markdown 管理多个AI语音Agent的提示词,解决提示词重复、漂移和手动同步难题,支持改动影响预览和一键回滚。