Muse Glimmer 30B深度实测:Meta开源智能体模型本地部署全解析

Meta重返开源赛道:Muse Glimmer 30B正式登场
正如马克·扎克伯格此前所承诺的那样,Meta正式重回开源AI赛道。这是继Llama系列之后,Meta发布的又一款重磅开源模型,被视为其开源战略的核心枢纽。本次的主角是 Muse Glimmer 30B——一款拥有约300亿参数、专为本地设备运行而设计的开源智能体(Agent)模型。
你可能没注意到,Glimmer与稍后即将发布的完整全重版本 Muse Spark 1.2 有所区别。Glimmer的定位更加清晰:它是一款针对智能体应用深度优化的稠密模型,采用 Apache 2.0 宽松许可证,赋予了开发者极大的自由度。它支持 128K(约121K有效)上下文窗口,并具备多模态能力,可以完美运行在 24GB 显存的消费级显卡上。
稠密模型架构的选择
Glimmer采用的"稠密模型"(Dense Model)架构与当前流行的混合专家模型(Mixture of Experts, MoE)形成鲜明对比。稠密模型在推理时激活所有参数,每个输入token都经过模型的全部神经网络层处理;而MoE架构(如Mixtral、DeepSeek广告-V3等)则只激活部分专家网络,虽然总参数量更大,但实际计算量更小。稠密模型的优势在于推理行为更可预测、硬件利用率更均匀,特别适合GPU加速;缺点是同等参数下计算开销更大。Glimmer选择稠密架构,正是为了在消费级GPU上获得稳定且可预测的推理性能。
从技术演进角度来看,稠密模型代表了一种"所见即所得"的设计哲学——30B参数就是30B的计算量,开发者可以精确预估推理延迟和吞吐量,这对于需要实时响应的智能体应用尤为关键。相比之下,MoE模型虽然在大规模服务器部署中表现优异,但其路由机制的不确定性和对内存带宽的更高要求,使其在消费级硬件上的表现往往不如理论预期。
Apache 2.0许可证的战略意义
Apache 2.0是开源软件领域最宽松的许可证之一,允许用户自由使用、修改、分发甚至商业化衍生作品,唯一要求是保留原始版权声明和免责条款。相比之下,Meta此前的Llama系列采用的是自定义许可证,对月活超过7亿的企业有额外限制。采用Apache 2.0意味着任何规模的公司都可以无条件将Glimmer集成到商业产品中,这对初创企业和独立开发者尤为重要,极大降低了法律合规成本。
这一许可证选择也反映了Meta在开源AI生态竞争中的战略转变。此前Google的Gemma系列、阿里的Qwen系列均已采用Apache 2.0,Meta若继续使用限制性许可证,可能导致开发者社区的流失。从商业逻辑看,Apache 2.0通过最大化模型采用率来构建生态护城河——当足够多的应用构建在Glimmer之上时,Meta就获得了定义AI基础设施标准的话语权,这比直接从模型许可中获利更具战略价值。
对于一直纠结"当下到底哪款本地模型最强"的用户来说,这个问题其实没有简单答案——它取决于你的使用场景。
Glimmer vs Qwen对比:智能体与编程的能力分野
从实测来看,Glimmer与Qwen 3.6 27B形成了鲜明的能力分野,两者各有所长。
Glimmer的核心优势:智能体与工具调用
Glimmer最大的差异化优势在于智能体代理能力。它专门针对工具调用(Tool Calling)和任务拆解做了优化,支持处理长周期的多步规划,并且能够在执行出错时实现自我纠偏。在 MCP、深度搜索工作流、代理任务及长程规划方面,Glimmer的表现明显优于同规模的其他本地模型。
理解工具调用与MCP协议
工具调用是指AI模型在推理过程中主动调用外部工具(如API、数据库查询、代码执行器等)来完成任务的能力。这要求模型不仅能生成自然语言,还能输出结构化的函数调用指令,并根据返回结果继续推理。具体而言,模型需要完成三个关键步骤:识别当前任务需要哪些工具、生成符合工具接口规范的调用参数、以及正确解析工具返回的结果并据此调整后续行动。这种能力需要在训练阶段通过大量的工具交互数据进行专门优化。
MCP(Model Context Protocol)是Anthropic于2024年提出的开放标准协议,旨在统一AI模型与外部数据源、工具之间的通信方式,类似于AI领域的"USB接口"。在MCP出现之前,每个AI应用都需要为每个工具编写专门的集成代码,导致开发成本高昂且难以扩展。MCP定义了统一的服务发现、认证、调用和响应格式,使得一个支持MCP的模型可以自动对接任何符合MCP标准的工具服务器。支持MCP意味着Glimmer可以无缝对接各类第三方服务和本地工具链,大幅降低智能体应用的开发门槛。
Qwen的核心优势:编程与逻辑推理
相比之下,Qwen系列在纯编程能力、通用任务、操作系统级任务以及逻辑推理方面更胜一筹。在 SWE-Bench、Terminal-Bench 等计算机操作基准测试中,Qwen依然占据优势。
值得解释的是,SWE-Bench是由普林斯顿大学推出的软件工程基准测试,包含从真实GitHub仓库中提取的编程问题,要求模型理解代码库上下文并生成正确的补丁修复bug,被认为是衡量AI编程实际能力的黄金标准。与传统的代码补全测试不同,SWE-Bench中的每个问题都来自真实的Issue和Pull Request,模型需要理解跨文件的代码依赖关系、定位bug根源,并生成可通过单元测试验证的修复代码。Terminal-Bench则专注于评估模型在终端环境中执行操作系统级任务的能力,如文件管理、进程控制、网络配置等。这两个基准测试代表了"实际动手编程"而非"回答编程问题"的能力维度。
Qwen在这些测试中的优势,部分源于阿里在训练数据中大量纳入了代码仓库的完整上下文信息,以及针对代码生成和修复任务的强化学习微调。这使得Qwen在处理复杂软件工程问题时具备更强的上下文理解和代码结构感知能力。
结论很明确:编程任务优先选Qwen,智能体任务则交给Glimmer。将两者结合并在本地运行,能够解锁更多AI应用的可能性。
Glimmer 30B基准测试数据详解
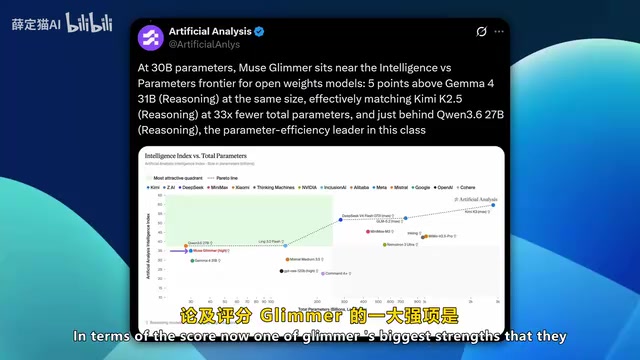
根据 Artificial Analysis 的独立评测,Glimmer 30B 的智能指数得分为35分,相比上一代Llama系列提升巨大,在同体量模型中极具竞争力:
- 以30分超越 Gemma 2 27B;
- 几乎追平 Qwen 2.5(36分);
- 虽然 Qwen 2.5 72B 仍以38分暂居榜首,但Glimmer凭借更小的参数规模实现了接近的表现。
Artificial Analysis是一家专注于AI模型性能基准测试的独立评测机构,其智能指数(Intelligence Index)综合评估了模型在推理、知识、编程、数学等多个维度的表现,被业界视为较为客观的第三方评测标准。Glimmer以30B参数逼近72B模型的表现,反映出模型架构和训练方法的优化在缩小参数规模差距方面发挥了重要作用。
在通用智能体任务上,据官方报告Glimmer得分达 24%,明显高于Qwen的17%。此外,Meta的测试数据显示Glimmer在大多数基准测试中都超越了同级竞品。
幻觉问题:GPQA V2测试的警示
不过Glimmer也有明显短板:知识处理任务和幻觉表现。在 GPQA V2 版本测试中,其幻觉率高达82%——这意味着在需要事实准确性的场景下需要额外谨慎。
GPQA(Graduate-Level Google-Proof Q&A)是一个由领域专家编写的高难度问答基准,问题涉及物理、化学、生物等学科的研究生级别知识,设计初衷是即使通过Google搜索也难以找到答案。V2版本进一步提升了难度和覆盖面。82%的幻觉率意味着模型在面对超出训练知识范围的专业问题时,倾向于生成看似合理但实际错误的回答,而非承认不知道。这是当前所有语言模型的通病,但82%的比例确实偏高,提示用户在事实核查场景需格外小心。
从技术角度理解,幻觉问题的根源在于语言模型本质上是概率生成模型,它们学习的是token之间的统计关联而非真正的"知识表征"。当模型被专门优化为智能体能力(即强化其行动规划和工具使用能力)时,可能在一定程度上牺牲了对事实知识边界的感知能力。这也解释了为什么Glimmer在工具调用上表现出色,却在纯知识问答中容易"胡说八道"——解决方案是通过RAG(检索增强生成)或工具调用来弥补知识缺口,这恰好是智能体架构的强项。
Token效率的优势
值得一提的是,Glimmer的 Token效率远高于Qwen 3.6及同量级的许多其他模型,这对于本地部署的成本和速度都是加分项。Token效率指模型完成同等质量任务所需消耗的token数量。更高的token效率意味着:在本地部署时,相同的推理时间能完成更多工作;在API调用场景下则直接降低成本。
对于智能体任务尤其重要——一个多步规划流程可能涉及数千到数万token的生成和处理,token效率的差异会在长程任务中被放大为显著的时间和成本差距。Token效率的提升通常来自两个方面:一是更高效的tokenizer设计(用更少的token表示相同的语义内容),二是模型在训练中学会了更简洁精确的表达方式,避免冗余输出。对于本地部署场景,每一个多余的token都意味着额外的GPU计算周期和等待时间。
本地部署硬件方案与性价比分析
Glimmer属于稠密模型,因此专用GPU对其性能有显著加持。以下是详细的硬件运行参考:
| 硬件 | 生成速度(约) | 备注 |
|---|---|---|
| RTX 3090(4bit量化) | 40 tokens/秒 | 性价比最高 |
| RTX 5090 | 75 tokens/秒 | 支持4B/6B量化 |
| RTX 4090 | 略快于3090 | 成本较高 |
| Apple M系列 Pro | 22 tokens/秒 | 高内存支持更高质量量化 |
| DGX Spark | 15 tokens/秒 | 受限于内存带宽 |
作为参考,人类的平均阅读速度约为每秒4-5个token,因此即使是最慢的15 tokens/秒也已远超人类阅读速度。而40 tokens/秒的实时生成体验几乎感受不到延迟,足以支撑流畅的交互式智能体工作流。
4bit量化技术解析
量化(Quantization)是将模型权重从高精度浮点数(如FP16的16位)压缩为低精度表示(如4位整数)的技术。4bit量化可将模型显存占用降低约75%,使30B参数的模型从约60GB压缩至约18GB,从而适配消费级显卡。常见的4bit量化方法包括GPTQ(GPU优化的训练后量化)、AWQ(激活感知权重量化)和GGUF格式的Q4_K_M(llama.cpp生态的混合精度量化)等。
GPTQ通过逐层最小化量化误差来保持输出质量;AWQ则发现模型中约1%的"显著权重"对性能影响巨大,通过对这些权重保持更高精度来减少整体损失;Q4_K_M则在不同层使用不同的量化位数,在显存和质量之间取得平衡。虽然量化会带来一定的精度损失,但现代量化算法通过保留关键层的高精度、使用分组量化等技术,已能将性能损失控制在可接受范围内——通常在各项基准测试中的下降幅度不超过1-3%。
约18GB显存即可跑起4bit量化版本,128K上下文窗口。若使用 Flash Attention 等技术,速度可提升约1.5到3倍,尤其在GPU上效果明显。
Flash Attention的加速原理
Flash Attention是由斯坦福大学Tri Dao等人于2022年提出的高效注意力计算算法,目前已迭代至Flash Attention 3版本。传统Transformer的自注意力机制需要O(n²)的显存来存储注意力矩阵——对于128K的上下文长度,这意味着需要存储一个128K×128K的巨大矩阵,这在消费级GPU上是不可能的。
Flash Attention通过分块计算(tiling)和内核融合(kernel fusion)技术,避免将完整注意力矩阵写入GPU高带宽内存(HBM),转而利用更快的片上SRAM进行计算。具体来说,它将输入序列切分为小块,在SRAM中完成每个块的注意力计算后直接输出结果,无需等待完整矩阵构建完毕。这不仅将显存开销从O(n²)降至O(n),还因减少内存读写次数而显著提升计算速度——现代GPU的计算速度远快于内存带宽,Flash Attention正是利用了这一硬件特性。对于128K这样的长上下文场景,Flash Attention几乎是必备的优化手段,没有它,长上下文推理在消费级硬件上将完全不可行。
需要提醒的是,如果系统内存仅16GB或更低,通常不建议运行,除非能接受较低的生成质量。
128K上下文窗口的实际含义
上下文窗口(Context Window)是指模型单次推理能处理的最大token数量。128K tokens约等于一本20万字的中文小说,或约300页英文文档。"约121K有效"的说法是因为模型需要预留部分token用于系统提示词和输出生成。
对于智能体任务,长上下文意味着模型可以在一次对话中维持更多的任务状态、历史记录和工具调用结果,而无需频繁截断或总结,这对多步规划至关重要。举例来说,一个复杂的智能体任务可能包含:系统提示词(约2K tokens)、工具定义(约3K tokens)、多轮工具调用历史(可能累积到50K+ tokens)、以及当前需要处理的新信息。没有足够长的上下文窗口,模型将不得不"遗忘"早期的执行步骤,导致决策失误或重复劳动。
不过正如后文测试所示,复杂的多应用场景仍可能触及上下文上限。此外,需要注意的是模型在上下文窗口末端的注意力准确度通常会有所下降——这被称为"迷失在中间"(Lost in the Middle)现象,即模型对上下文中间位置的信息检索能力弱于开头和结尾。
编程能力实测:Web开发与代码生成
作者首先测试了并非Glimmer核心强项的网页开发任务。
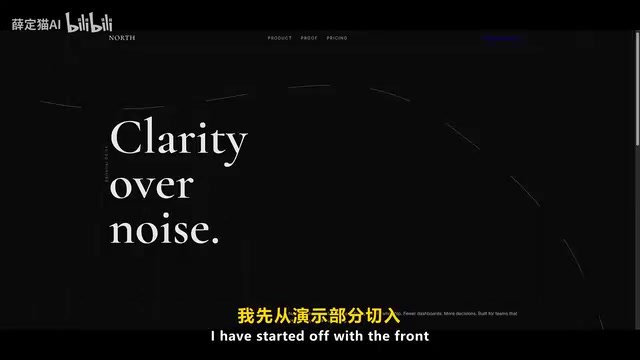
在生成SaaS落地页时,Glimmer的输出"算不上顶级,但作为本地模型已相当出色"——它正确添加了指定的依赖包,还实现了滚动触发效果。在生成塔防游戏时,功能基本正常,但与Qwen 3.6 27B相比,视觉质量、视觉深度感和功能完备度都有明显差距。这也印证了前文的判断:在Three.js等web开发任务上,Glimmer确实稍显逊色。
Three.js是一个基于WebGL的JavaScript 3D图形库,广泛用于创建浏览器中的3D场景、游戏和可视化效果。生成Three.js代码不仅需要理解API调用语法,还需要具备3D数学(向量、矩阵变换、光照模型)和场景图管理的隐性知识,这对模型的代码生成能力提出了较高要求。
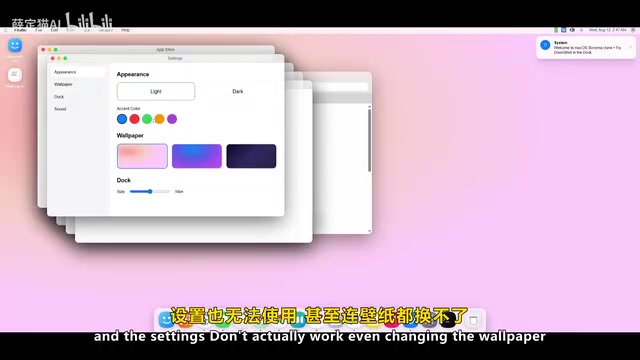
作者还测试了一个模拟操作系统界面的项目。结果喜忧参半:通知显示、聚焦搜索、Safari和照片应用等实现了适配,但底部工具栏运行不够流畅,设置和壁纸更换等功能无法正常工作。作者将其归因于 121K 上下文窗口的限制——对于这类复杂多应用场景确实偏小。模拟操作系统界面这类任务需要生成大量相互关联的组件代码,每个"应用"都需要独立的状态管理和UI逻辑,累积的代码量很容易超出上下文容量。
令人惊讶的是,Glimmer在生成"纽约天际线"艺术画时表现不俗,甚至完美捕捉了蝴蝶的对称结构与摆动的触角,还原度相当逼真。作者形容其能力"像早期GPT-4,某些方面接近4.5的水平"。这里的"艺术画"指的是通过SVG或Canvas代码程序化生成的图形,而非传统的图像生成模型输出,这展现了Glimmer在结构化图形描述方面的出色能力。
智能体代理能力实测:Glimmer的真正实力
Glimmer真正大放异彩的地方在于智能体任务。作者构建了一个本地日历与会议代理进行测试:不再手动指挥每一步操作,而是给出一个大目标,让模型自行拆解。
例如指令为:"帮我安排明天的会议,避开时间冲突,加上路程时间,再为客户演示准备一份简短备忘录。"Glimmer会读取本地的Markdown文件,将碎片化信息整理成完整工作流,核对日程表、分析冲突、确认参会者空闲时间,甚至自动生成了一个前端界面。
这一过程展现了Glimmer出色的规划能力、策略性工具使用以及自主协同工作的特质——这正是它区别于其他本地模型的核心价值。
智能体模型与传统聊天模型的区别
智能体模型与传统聊天模型的关键区别在于:传统模型是"一问一答"式的被动响应,而智能体模型具备主动规划、环境感知、错误恢复和多步执行的能力。它不只是生成文本,而是真正"做事"——调用工具、读写文件、协调多个子任务,并在遇到障碍时调整策略重新尝试。
从技术实现角度看,智能体能力的训练通常需要:(1)大量的工具交互轨迹数据,让模型学会何时调用什么工具;(2)强化学习或人类反馈训练,让模型学会在多步决策中做出最优选择;(3)专门的错误恢复训练数据,教会模型在遇到工具调用失败或意外结果时如何回退和重新规划。Glimmer在这方面的专项优化,使其能够处理"安排会议"这种需要读取文件→分析冲突→做出决策→生成输出的链式任务,而不是简单地回答"如何安排会议"这个问题。
总结:Glimmer 30B适合谁?
综合来看,Muse Glimmer 30B 是一款相当全能且实用的本地模型。它以更高的计算效率、专业的智能体能力和宽松的Apache 2.0协议,为开发者提供了一个极具吸引力的本地部署选择。
不过作者也坦言,这次发布"略显仓促",推测Meta是为了在Qwen即将发布的380亿参数新模型之前抢占市场,从而集中精力研发下一代开源权重模型。这种"抢先发布"的策略在AI领域已成常态——开源模型的竞争不仅是技术实力的较量,更是生态建设的速度战。先发布的模型能够优先获得社区的微调、工具链适配和应用生态积累,这些网络效应一旦形成就很难被后来者轻易撼动。
无论商业动机如何,对开源社区而言,能在本地运行如此强大的智能体模型本身就是一项了不起的成就。正如作者所说:"这些公司已经实现了将此类智能部署在本地。"对于侧重智能体自动化流程的开发者来说,Glimmer 30B 值得一试;而若你的重心在纯编程,Qwen 仍是更稳妥的选择。两者并非非此即彼的关系——在本地同时部署两个模型,根据任务类型自动路由,可能是当前最佳的实践方案。
核心要点
核心要点
相关推荐

Felix Rieseberg 个人主页
Felix Rieseberg 个人主页在 Hacker News 引发关注。本文介绍这位 Slack 工程师的技术背景、nativefier 项目的兴衰,以及开发者个人主页作为技术名片的价值。

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。