Meta发布美国最强开源权重模型,Ollama即将上线

Meta发布被称为美国最强开放权重模型,即将登陆Ollama供本地运行。
Meta的人工智能研究团队发布了一款新的开放权重模型,被业界观察者称为“迄今为止美国最强的开放权重模型”,并预计很快在Ollama平台上线,让开发者能在本地便捷运行与实验。文章介绍了开放权重模型公开训练参数、促进透明度与社区创新的特点,指出Meta通过Llama系列已是这一路线的重要推动者。Ollama的支持将显著降低部署门槛,加速模型在实际项目中的应用与反馈。对开发者与研究者而言,开放权重带来灵活实验与私有数据微调的空间;但模型架构、训练数据和基准成绩等细节尚未披露。开放权重模型竞争日趋激烈,新模型的实际表现与生态支持将成为后续关注焦点。
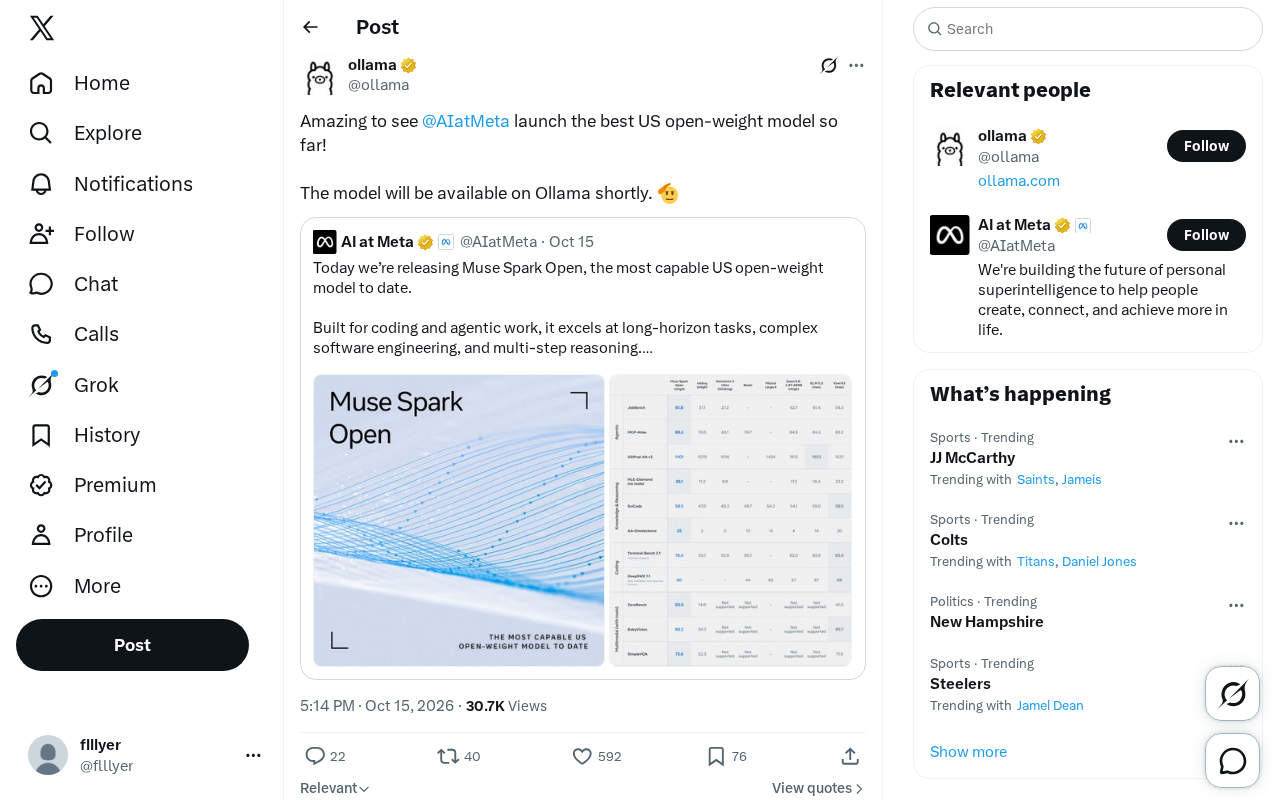
Meta的人工智能研究团队(@AIatMeta)近日发布了一款新的开放权重模型,被业界观察者称为“迄今为止美国最强的开放权重模型”。根据社交平台上的讨论,该模型很快将在Ollama平台上提供,这意味着开发者可以更方便地在本地运行和实验这一新模型。
开放权重模型的意义
开放权重模型是指模型的训练参数对外公开,允许研究人员和开发者下载、检查甚至微调。与完全闭源的模型相比,开放权重模型促进了透明度、可复现性和社区创新。Meta一直是开放权重模型的重要推动者,此前发布的Llama系列已经在开源社区产生了广泛影响。此次新模型被描述为“美国最佳”,暗示其在性能上可能超越了此前同类的美国开放模型。
开放权重(open weights)与开源(open source)在严格意义上并不等同。开放权重仅指模型的训练后参数被公开发布,使用者可以下载并直接推理或微调;但训练代码、训练数据配比、数据清洗流程等往往并未一并公开,因此通常不满足OSI(开放源代码促进会)对“开源AI”的完整定义。Llama系列即属于典型的开放权重模型,其许可协议还附带用户规模、商用等附加条款。与之相对,完全开源模型(如部分由学术机构发布、附带完整训练脚本与数据说明的模型)在可复现性上更强,但数量稀少。开放权重的价值在于:一是允许研究者在真实权重上做可解释性与安全性分析,二是让企业能在私有数据上微调而不必将数据外传,三是形成围绕权重分发、量化压缩与本地推理工具的生态。理解这一区分,有助于判断某次发布究竟是“透明度提升”还是“有限开放”。
Ollama平台的支持
Ollama是一个流行的本地大模型运行工具,支持用户在个人电脑上轻松部署和运行各种开放模型。该模型即将登陆Ollama,意味着开发者无需复杂的配置就能体验其能力,这通常会大幅降低使用门槛,并加速模型在实际项目中的应用和反馈循环。
Ollama的运作机制值得单独说明。它本质上是一个模型运行时与模型仓库的结合体:用户通过命令行拉取模型文件(通常是经过量化的GGUF格式),Ollama负责加载权重、管理上下文窗口、暴露本地HTTP API,并兼容OpenAI风格的接口调用。量化(如4-bit、8-bit)会以一定精度损失换取显著降低的显存与内存占用,使模型能在消费级GPU甚至CPU上运行。因此“登陆Ollama”不仅意味着安装方便,还意味着该模型需先完成格式转换与量化适配,社区往往会在数天内跟进产出不同量化等级。对开发者而言,这带来的是可离线、低延迟、数据不出本地的推理路径,但也需注意量化版本在长上下文与复杂推理任务上可能与原始权重存在可感知的差异。
对开发者和研究社区的影响
对于开发者而言,新模型的开放权重和Ollama支持意味着更灵活的实验机会。研究人员可以深入分析模型行为,企业也可以基于自身数据微调模型而不必依赖外部API。不过,目前关于该模型的具体架构、训练数据和基准测试成绩的详细信息尚未在原始推文中披露,社区仍在等待更完整的技术报告。
竞争格局与未来展望
开放权重模型的竞争日趋激烈,Meta的新发布可能会进一步推动美国在开源AI领域的进展。随着模型在Ollama上线,预计将吸引大量开发者测试和比较,其实际表现和生态支持将成为关注焦点。
(注:本文基于公开推文信息,模型详细规格以官方发布为准。)
相关推荐

房产经纪人用AI提效的5个实操方法(2026版)
房产经纪人如何用AI提效?结合YouTube实操演示,拆解ChatGPT写房源描述、Canva做营销物料、表单管理开放日线索、Zapier自动跟进、卖家面谈准备5个方法,并提示公平住房法规、照片真实性与定价核实等风险边界。

Grok Bot vs ChatGPT Agent:两大AI代理谁更强?
Grok Bot 与 ChatGPT Agent 有何区别?本文对比两者的工作方式:Grok Bot 拥有云端计算机、可常驻工具内自动执行多步任务;ChatGPT Agent 在浏览器中操作网页,通用任务更成熟。附选型建议。

Walmart Agent Gateway:AI帮你自动购物,亚马逊为何反其道而行?
沃尔玛推出Agent Gateway,允许ChatGPT、Gemini等AI助手直接接入商品库替用户搜索比价加购,并设消费限额与逐笔审批三道安全阀。亚马逊则封堵外部AI代理,两大零售巨头走向相反路线。功能目前仅限美国,印度市场或随后跟进。