Meta发布Muse Wonder:个人超级智能模型登场

Meta发布Muse Wonder,主打个人超级智能,以主动记忆与主动专注切入消费级Agent赛道。
Meta近日发布Muse Wonder模型,核心理念是面向普通人日常生活的"个人超级智能",并配套推出内部基准Personal Superintelligence Index。模型聚焦两大功能:主动记忆,让模型跨对话保留用户关键信息;主动专注,使其在长任务中自主切换方法并在重要操作前确认。Muse Wonder将驱动Meta的个人Agent产品Muse,率先向付费订阅用户开放,标志着Meta在Agent赛道选择消费级日常助手而非开发者编程工具。同时,完整版Muse Wonder Full据称在DeepSuite等长程编程基准上领先,但仅在Meta代码订阅中提供;轻量版已通过API开放。个人化定位能否在实际使用中兑现,仍待验证。
Meta近日发布了Muse Wonder模型,整场发布围绕一个核心理念展开:个人超级智能(Personal Superintelligence)。按照Meta的说法,这指的是真正对普通人的日常生活有用的模型,而不是又一个编程Agent。为了衡量这类能力,Meta还专门创建了一个内部基准——Personal Superintelligence Index。
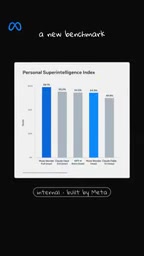
两大核心功能:主动记忆与主动专注
Meta在Muse Wonder上聚焦两个功能。
主动记忆(Active Memory) 意味着模型能够跨对话携带关于你的关键信息,你不需要每次重新解释自己的背景和偏好。这解决了当前大多数助手类产品"每次对话都从零开始"的痛点。
主动专注(Active Focus) 则让模型在长任务上持续工作,遇到卡点时主动尝试不同方法,并在执行重要操作前先和你确认。
在Meta的一段演示中,Wonder可以跨浏览器和其他应用协同工作,结合你的偏好生成一份跑步计划。这个场景展示的正是"个人超级智能"的定位——处理的是生活事务,而不是代码任务。
主动记忆(Active Memory) 与传统的"上下文窗口"或"记忆库"有本质区别。当前大多数助手依赖单次会话的上下文窗口,一旦对话结束,信息即被清空;部分产品虽有跨会话记忆,但通常需要用户手动保存或调用,本质上仍是"被动检索"。主动记忆指的则是模型自行判断哪些信息值得长期保留——例如你的作息偏好、常用工具、饮食禁忌——并在后续对话中无需提示即可调用。这背后涉及记忆的写入、检索与遗忘三层机制,也带来新的挑战:记忆准确性如何保证、隐私边界如何界定、错误记忆如何纠正。这些问题恰恰是决定个人化体验能否成立的技术底座。
Muse:Meta的个人Agent
Muse Wonder也将成为驱动Muse的模型。Muse是Meta推出的个人Agent,将率先向付费订阅用户开放。
这意味着Meta在Agent赛道上选择了一条与编码Agent不同的路径:面向普通消费者的日常助手,而非开发者的编程工具。付费订阅作为首发渠道,也说明Meta将Muse视为可商业化的消费级产品。
Agent(智能体) 通常指能够自主拆解目标、调用工具、执行多步操作的大模型应用形态。过去一年,行业最成熟的Agent落地场景是编码Agent,如能读写代码库、运行测试、提交PR的编程助手,因为编程任务的验证标准清晰、工具接口标准化。而面向普通消费者的日常Agent难度更高:任务边界模糊("帮我安排周末"没有唯一正确答案)、涉及跨应用操作、失败代价直接落在用户体验上。Meta选择从消费级场景切入,本质是在验证Agent能否从"任务执行器"升级为"生活协作者",这是比编码Agent更难的命题。
编程能力并未放弃
Muse Wonder依然具备编程能力。据Meta介绍,更大规模的版本Muse Wonder Full在DeepSuite等长程编程基准测试中处于领先位置。
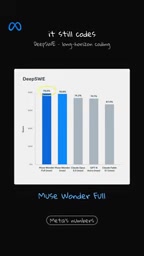
这也透露出Meta的产品分层策略:轻量版通过API面向开发者开放,完整版则仅在Meta的代码订阅服务中提供。
长程编程基准(Long-horizon Coding Benchmark) 指的是评估模型在需要数十步甚至上百步操作、跨越多个文件和工具调用后仍能保持目标一致性的测试集。DeepSuite即属于此类,它衡量的不只是单点代码生成能力,更关注模型在长时间任务中是否迷失方向、能否从错误中恢复、以及最终产物是否可运行。这类基准之所以被看重,是因为它更接近真实软件开发流程——真实项目很少能靠一次生成完成。Meta强调Wonder Full在此类基准上领先,意在表明其底层模型能力并未因"个人"定位而妥协,只是产品化路径做了分层。
可用性与待验证的问题
Muse Wonder目前已通过Meta的API开放使用,完整版则只存在于Meta的代码订阅之中。
真正的悬念在于:当用户开始大规模使用后,这种"个人"定位能否在实际体验中兑现。跨对话记忆的准确性、长任务中主动确认的时机判断、以及跨应用协同的稳定性,都是决定这类产品成败的关键。Meta用自建基准给自己打分是一回事,用户用日常需求投票是另一回事。
从行业角度看,Meta此举也标志着大模型竞争的一个转向:在通用能力和编程能力趋于同质化之后,"对个体的深度理解"可能成为下一个差异化战场。
自建基准(Internal Benchmark) 在AI发布中已成常态,但其公信力始终存在争议。厂商自建基准的好处是能精准衡量自身产品想要强调的能力维度,例如Personal Superintelligence Index显然侧重日常事务处理而非通用问答;风险则在于测试集、评分标准与数据分布均不公开,外部无法复现,容易演变为"自己出题自己考"。行业更认可的验证方式是第三方基准与真实用户留存数据的结合。因此Meta用自建指数证明"个人超级智能"能力,只是第一步,用户规模扩大后的实际表现才是更有力的证据。
相关推荐

黑人觅食者Alexis Nelson:从觅食到出书,快乐零食别死
黑人觅食者Alexis Nikole Nelson做客Talks at Google,分享从童年跟随母亲认识植物到出版食谱书《Happy Snacking, Don't Die!》的旅程,揭示美国觅食兴衰背后的种族与土地历史。

如何有效呈现你的想法:三种揭示式演讲方法
揭示式演讲是传递想法最直接的方式。本文解析奇妙漫步、动态演示和梦想图景三种演讲类型,结合David Gayo、Michael Pritchard、Sylvia Earle等经典案例,教你如何有效呈现想法。

Modern Web Guidance:让AI写原生声明式对话弹窗
Google Modern Web Guidance 让 AI 编程助手在生成代码时优先使用浏览器原生声明式 dialog 能力,替代重复的 JavaScript 事件监听,实测可显著减少样板代码。