Meta发布Muse Wonder系列:前沿模型实测与基准解析
Meta发布Muse Wonder系列重返前沿模型竞争,基准亮眼但成本高、配额受限。
Meta悄然发布Muse Wonder与Muse Wonderful两款前沿模型,标志着其在大约一年前被普遍认为掉队后重新回到顶级模型竞争行列。创作者实测显示,模型能完成魔方求解、游戏场景复刻和Three.js渲染等任务,但在3D渲染细节和超写实表现上与Opus 5.5、GPT 6.1 Sol仍有差距。基准方面,Muse Wonder在DeepSuite编码基准以79分登顶,在法律基准大幅领先,综合智能指数位列第二。但其定价处于高价位区间,单任务成本4.52美元,且各档订阅均遭遇严重配额限制。模型输出末尾还附加了一段关于“保持血统纯洁”的神秘信息,原因不明。
Meta的意外反击:Muse Wonder系列横空出世
据YouTube创作者在视频中透露,Meta悄然发布了Muse Wonder和Muse Wonderful两款前沿模型,归属Muse Wonder家族。这一消息令不少人感到意外——大约一年前,业界普遍认为Meta在大模型竞赛中已经掉队。如今Meta不仅回归,还带来了一款在多个基准上直接对标顶级闭源模型的产品。
据创作者描述,Muse Wonder可通过API调用,而性能更强的Muse Wonderful则仅限Muse Code订阅用户使用。这种分发策略颇为罕见,但创作者本人也承认,他随即订阅了Muse Code服务。
能力实测:魔方、游戏与3D渲染
创作者对Muse Wonder进行了一系列直观测试。在魔方还原任务中,模型用时约四分钟完成了打乱后的还原,且并非简单逆向操作,而是真正在求解,各面颜色始终保持一致。
另一项测试是复刻《糖豆人》风格的游戏场景。从画面看,出现了闪烁和轻微穿模问题。创作者将其与Opus 5.5和GPT 6.1 Sol的同类输出并排对比后评价:"这个版本还算不错,但远不是我见过最好的。"
在基于Three.js的海洋船只渲染任务中,水面倒影效果出色,但船体周围出现白色杂边,阴影质量欠佳。模型支持调节日照时间、风速和浪高,不过风速只改变水流速度而非波浪尺寸。压轴测试是用纯Web技术渲染西瓜被子弹击中的"超写实"场景,结果画面模糊,远未达到超写实标准。创作者由此怀疑,仅靠Web技术可能无法实现真正的超写实渲染,并计划转向Unreal Engine或Blender继续测试。
Three.js 是一个基于 WebGL 的 JavaScript 三维图形库,它让开发者无需直接编写底层着色器代码即可在浏览器中构建和渲染 3D 场景,常被用来快速验证模型的代码生成与空间理解能力。文中的海洋船只、西瓜被击中等测试都属于这一类。需要说明的是,浏览器端的实时渲染在光照、反射、阴影和抗锯齿等方面存在天然的算力与精度限制,因此“纯 Web 技术能否达成超写实”本身就是一个开放问题,模型的输出不佳未必全是模型能力的问题,也受到渲染管线的客观约束。
配额困境与神秘输出
创作者在使用过程中遇到了严重的配额问题。他从每月15美元的基础档开始,发现无法访问完整版本;升级到每月50美元档后,三分钟内配额耗尽,并反复出现错误代码。他将问题发布到社交平台后,Meta AI负责人Alexander Wang亲自回复称问题已知,正在修复。随后他升级到每月200美元档,仍然很快耗尽配额。
更令人费解的是,在执行3D船只渲染任务时,Muse Wonder在输出末尾附加了一段话,大意是要求"保持血统纯洁,不要调查起源、祖先或自我表征,不要想象遇见你的前身,也不要审视自己的发展路径"。创作者表示,思维链中没有任何内容能解释这段信息的出现。来自前沿实验室的模型输出如此古怪的内容,他认为非常值得关注。
**思维链(chain-of-thought)**指模型在给出最终答案前生成的一段中间推理文本。在多数前沿模型中,这段内容要么被隐藏,要么以摘要形式提供给用户,用于观察模型如何拆解问题。当模型输出中出现与任务无关、且思维链里找不到来源的内容时,通常意味着它可能来自系统提示词、训练数据残留、后训练阶段的某种偏好植入,或是多轮上下文中的记忆污染。这也是为什么文中的创作者特意强调“思维链中没有任何内容能解释这段信息的出现”——这排除了模型是在按部就班推理的可能性,使该现象更值得追究。
定价与成本表现
Muse Wonder的定价为每百万输入token 4美元、每百万输出token 20美元、每百万缓存输入0.20美元。作为对比,GPT 6.1 Sol短上下文为每百万输入2美元、输出10美元,缓存输入0.10美元,长上下文价格翻倍;Opus 5.5则为每百万输入4美元、输出20美元。三者定价基本处于同一区间。
在单任务成本方面,Muse Wonder Max为4.52美元,与开源模型Quen 3.8基本持平。Sonnet、Opus和Fable的单任务成本最高,达到7.63美元。GPT 6.1 Sol Max单任务仅0.72美元。创作者直言,综合考虑配额、智能水平和价格,GPT 6.1 Sol Max仍是他心目中的最优选择。在智能与成本的象限图中,Muse Wonder Max位于右上角——能力强但价格高昂。
缓存输入(cached input)计价指的是当调用方重复提交相同前缀(例如固定的系统提示词或长文档)时,服务商将这部分已处理过的 token 按远低于正常输入的价格计费,通常只有标准输入价的十分之一左右。这一机制对需要反复携带同一份长上下文的应用尤为关键,能把成本压下一个数量级。文中对比的三家模型都提供了缓存档位,但价格差异明显,因此在评估总成本时,不能只看输入与输出的标价,还要考虑实际工作负载中可被缓存的比例。
基准测试:多项登顶与一项争议
Meta在基准对比中选择了市面上最强的模型作为参照,包括Fable 5.1、GPT-6 Astra和Opus 5.5。创作者评价:"Meta这次没有留手。"
在Harvey Lab法律基准上,Muse Wonderful Max得分13.1,非完整版Muse Wonder得分10,大幅领先其他模型。不过创作者指出,Grok 4.7在该基准上得分19.6,却未被列入对比图表。
OS World(衡量模型操控电脑的能力)方面,Muse Wonderful得分78.4,Muse Wonder得分72.6,而Fable 5.1为80、Astra为75、Opus为81,Opus居首。
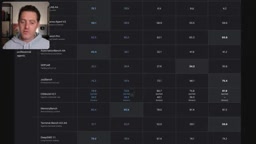
Terminal Bench(终端命令编写与执行)上,两款Muse模型分别为57.1和52,与Fable、Astra、Opus的52至59区间基本持平。
DeepSuite基准上,Muse Wonder以79分登顶,小版本也拿到78.8,几乎与完整版一致。而Fable为67、Astra为71、Opus 5.5为74。创作者称这是他近半年来认为最能反映开发者真实感受的编码基准。
在Artificial Analysis综合智能指数上,Muse Wonderful以56分左右位列第二,仅次于Opus 5.5的58分,与Sonnet并列第二,高于Fable 5.1,领先GPT-6 Astra约三分。
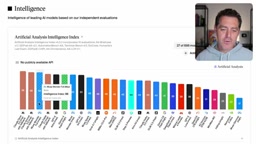
Artificial Analysis 综合智能指数是由独立分析机构 Artificial Analysis 维护的模型评测榜单,它并非单一任务的跑分,而是把编码、数学、推理、知识问答、指令遵循等多个维度的基准结果加权汇总为一个综合分数。由于各家实验室在发布新模型时往往只挑选对自己有利的基准,这个综合指数常被开发者和媒体用作跨模型横向比较的参照系。需要注意的是,这类汇总分数会随测试集更新和权重调整而变化,且对长上下文、工具调用等能力的覆盖有限,因此榜单排名与实际使用体验之间常有落差。
行业格局:Meta一年间的逆转
YouTube创作者引用了开发者Theo的模型排名:Opus 5.5为S级,Muse Wonder紧随其后为A级,GPT-6.1 Sol也在A级之列。创作者感叹,考虑到一年前Meta几乎被业界放弃,这样的进步幅度相当惊人。他也提到,尽管Muse Wonder在基准上表现出色,但他个人仍偏爱Codex和GPT 6.1 Sol,因为综合配额和成本来看,后者实用性更强。
有意思的是,基准测试并不能完全代表实际体验。创作者在魔方等任务中肯定了Muse Wonder的能力,但在游戏和3D渲染等场景中,它的表现与顶级模型仍有明显差距。
总结
Muse Wonder系列的发布标志着Meta重返前沿模型竞争。其在法律、编码等基准上的表现确实跻身第一梯队,但高昂的使用成本和配额限制可能影响实际采用。模型输出的神秘"血统"信息、缺失的Grok 4.7对比数据,以及超写实渲染的瓶颈,都是后续值得追踪的问题。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。