Meta Muse Image模型发布:AI合影功能引发肖像权争议

Meta超级智能实验室首款图像模型正式亮相
Meta近日宣布推出Muse Image图像生成模型,这是其超级智能实验室(Superintelligence Labs)成立以来发布的首款AI图像生成模型。根据Meta官方公告,该模型已为Meta AI应用、Instagram和WhatsApp中的图像生成工具提供技术支持,并将很快登陆Facebook和Messenger平台。
背景:Meta超级智能实验室的来龙去脉 Meta超级智能实验室(Superintelligence Labs)是Meta于2025年组建的专注于前沿AI研究的核心机构,由前Scale AI CEO Alexandr Wang与Meta内部研究团队联合主导。与此前Meta的FAIR(基础AI研究部门)不同,这一实验室被定位为更具进攻性的"登月"项目,目标直指通用人工智能(AGI)的突破性进展。其设立背景是扎克伯格公开承诺将2025年定为AI投入"决定性之年",并宣布在AI基础设施上投入高达600亿美元资本支出。Muse Image作为该实验室首款面向消费者的产品,承载了外界对其落地能力的第一次系统性检验。
这一发布标志着Meta在生成式AI竞赛中的又一次重要落子。Muse Image并非孤立功能,而是Meta将AI能力深度整合进其庞大社交生态的战略体现。凭借数十亿月活用户,Meta旗下平台为这一模型提供了其他AI厂商难以企及的分发渠道与使用场景。
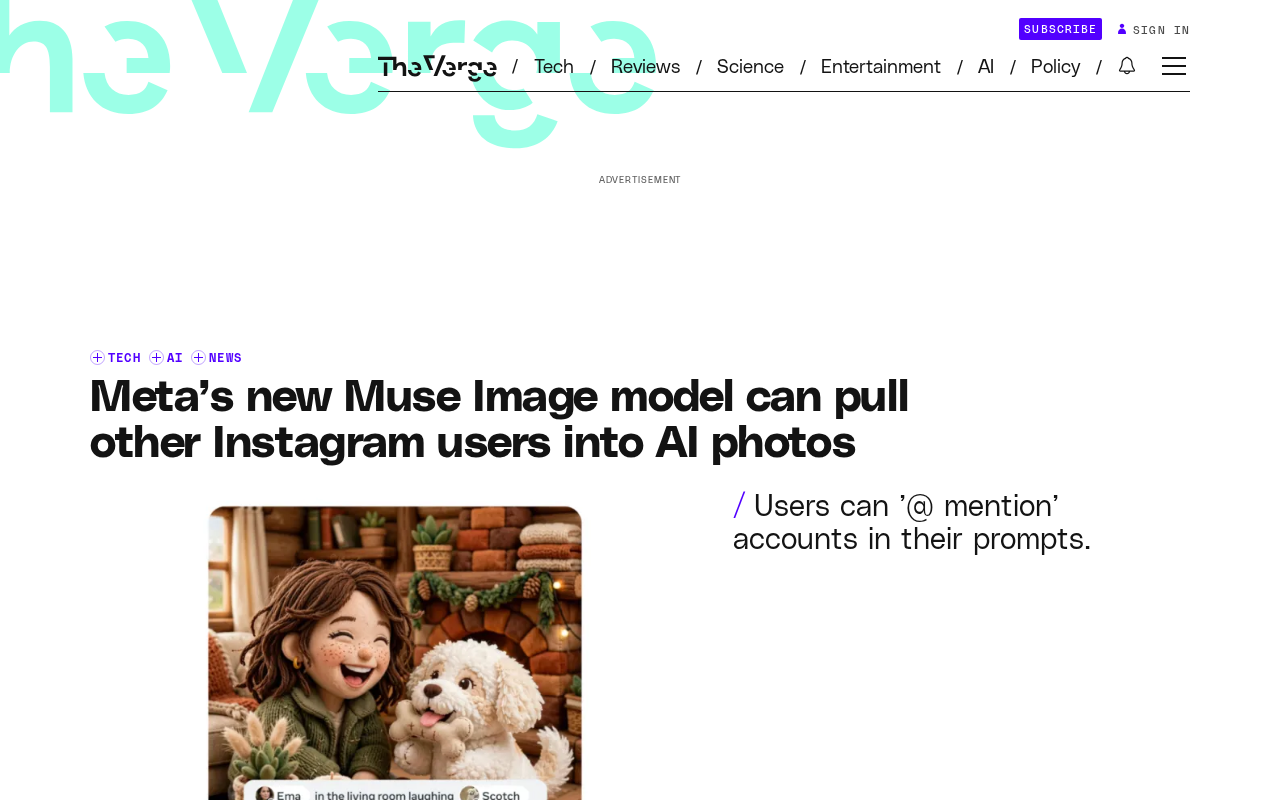
最受关注的功能:将真实用户拉入AI合成照片
Muse Image最具话题性的功能,是允许用户将其他Instagram用户"拉入"AI生成的照片中——即把平台上真实用户的形象纳入合成图片,生成包含多个真实人物的AI影像。
这一功能在技术层面得益于当前AI图像生成模型的重大进步。当前主流AI图像生成方案主要分为两类路线:以Stable Diffusion、DALL-E 3为代表的扩散模型(Diffusion Models),通过对噪声图像反复去噪迭代来生成高质量画面,在细节还原和风格控制上表现突出;以及将图像生成类比于语言模型token预测的自回归模型路线。
扩散模型的核心思想源于非平衡热力学中的扩散过程。训练阶段,模型学习如何将一张真实图像逐步添加高斯噪声直至完全随机化;推理阶段,则从纯噪声出发,通过神经网络反复预测并去除噪声,最终还原出高质量图像。这一"破坏-重建"的对称学习框架,赋予了扩散模型极强的分布建模能力。相较于此前主流的生成对抗网络(GAN),扩散模型训练更稳定、多样性更高,但推理速度较慢——这也是各厂商持续优化的核心工程挑战之一。
Meta此前在CM3leon、Emu系列多模态研究上积累了丰富成果,Muse Image大概率在此基础上进一步融合了身份一致性保持(Identity Consistency Preservation)技术。这一技术通过引入人脸编码器(Face Encoder)将人脸特征向量注入图像生成的跨注意力层(Cross-Attention),实现了在任意场景和风格下保持人物身份特征的能力。以IP-Adapter、InstantID、PhotoMaker为代表的业界方案已验证了此类技术路线的可行性,这也正是Muse Image能够将多个真实Instagram用户形象自然合成进全新场景的底层技术支撑,区别于普通文生图工具的核心壁垒所在。
这一功能具有天然的社交传播潜力:与朋友、偶像甚至陌生人共同出现在一张从未真实发生的场景照片中,门槛极低,效果直观。它将过去需要专业修图技能才能实现的创意合成,变为普通用户触手可及的日常操作。
便利背后:肖像权、隐私与滥用风险
然而,这项功能也不可避免地引发了关于肖像权、隐私保护和潜在滥用的广泛担忧。当任何人都可以将他人形象置入AI生成场景时,以下问题亟待解答:
- 如何防止未经授权的肖像使用?
- 如何避免用户被置于不当或误导性语境?
- 平台是否提供有效的退出机制?
肖像权的法律现状在不同地区差异显著。美国各州法律(尤其是加州和纽约州)严格禁止未经授权将个人形象用于商业目的;欧盟《通用数据保护条例》(GDPR)则将个人形象纳入个人数据范畴,任何处理须有明确合法依据。当一张照片从未真实存在、却包含真实人物的高度还原形象时,现有法律框架面临根本性挑战。
美国国会推进中的《NO FAKES法案》(Nurture Originals, Foster Art, and Keep Entertainment Safe Act)试图在联邦层面建立AI生成仿真人像的授权要求:未经本人明确书面授权,任何人不得创建、托管或分享以AI技术生成的逼真人物仿真内容,且授权不可由第三方代为同意。与此同时,欧盟《人工智能法案》(AI Act)已于2024年正式生效,要求所有AI生成内容须进行机器可读的水印标注;中国则于2023年发布《生成式人工智能服务管理暂行办法》,明确要求平台对AI生成内容进行显著标识。这一多地区、多层次的监管格局,意味着Meta的Muse Image需要针对不同市场构建差异化的合规机制,而非采用统一的全球产品策略。
此类功能一旦被恶意利用,可能催生新型骚扰、诽谤乃至**深度伪造(Deepfake)**内容。深度伪造是指利用深度学习技术——尤其是生成对抗网络(GAN)或扩散模型——将一个人的面部特征无缝替换到另一段媒体内容中的技术。自2017年出现以来,随着计算能力普及和开源工具的扩散,其制作门槛急剧下降。英国《在线安全法》已将非自愿色情深度伪造列为刑事犯罪。Meta此前曾因平台上流传的名人AI换脸广告问题多次受到监管压力,Muse Image的多人合成功能实质上是将部分深度伪造能力产品化,如何设计有效的内容审核与溯源标注机制,将是其面临的核心合规挑战。
Muse系列产品与Meta的AI社交战略
Muse Image是Meta正在构建的Muse系列AI产品矩阵的组成部分。将AI图像生成能力横向铺开至所有主力应用——从Instagram Reels到WhatsApp日常聊天——体现了Meta"AI无处不在"的产品思路。
与OpenAI、Google主要通过独立产品或API输出AI能力的路径不同,Meta的核心优势在于无可比拟的用户规模与社交网络效应。网络效应(Network Effects)是指产品或服务的价值随用户数量增加而指数级提升的经济现象,是社交平台最核心的竞争壁垒。Meta旗下产品的多边网络效应尤为显著:用户留在平台,是因为其社交关系网络已在此积累,迁移成本极高。
Meta的AI分发护城河在数字上极为直观:Facebook月活用户超31亿,WhatsApp月活超20亿,Instagram月活超20亿——相比之下,ChatGPT月活约4亿,Midjourney约1500万。这种量级差异意味着,Muse Image可以通过原生内嵌的方式将图像生成能力转化为日常社交行为的一部分:用户在WhatsApp聊天中顺手生成AI合影,或在Instagram Stories中嵌入AI创意图像,其使用频率和情感黏性将远高于专门打开一款独立AI创作工具。
行为经济学将此称为"默认效应"(Default Effect):当AI生成功能成为发图流程的默认选项之一,用户的实际采用率将远高于需要主动跳转的独立应用。这种"无感渗透"式的AI整合策略,是Meta在生成式AI竞争中最核心的差异化路径,也是将图像生成直接嵌入用户每天使用的应用中、快速形成规模化用户行为的关键所在——这是OpenAI、Midjourney等纯AI公司短期内难以复制的结构性优势。
超级智能实验室的首份答卷
Muse Image是Meta超级智能实验室交出的首款面向消费者的图像生成产品。这一实验室的成立本身代表Meta对前沿AI能力的重金投入与长期押注。作为首秀,Muse Image的市场表现将在一定程度上检验Meta在生成式AI基础研究与工程落地上的综合实力。
展望:社交与AI融合进入新阶段
Muse Image的推出,是社交媒体与生成式AI深度融合趋势的又一注脚。当AI图像生成从专业工具演变为社交平台的原生功能,内容创作形态与社交互动方式都可能被深刻重塑。
对用户而言,这意味着更丰富的表达手段;对Meta而言,这是巩固平台粘性、激活内容生产的新引擎。但将真实用户形象纳入AI合成的能力,也让内容真实性、平台责任与监管合规等议题变得更加紧迫。随着欧盟《人工智能法案》、美国各州AI立法以及全球平台内容监管的持续收紧,Meta需要在产品设计阶段就将合规机制内嵌其中,而非事后修补。这类功能如何在创新与规范之间持续演进,值得长期关注。
核心要点
核心要点
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。