Meta Muse Glimmer vs 通义千问:30B开源模型高考数学实测对比

Meta重返开源牌桌:Muse Glimmer正式发布
本周,Meta发布了一款全新的30B级别开源大模型——Muse Glimmer,在AI社区引发不小的讨论。这是Meta继Llama 4之后再度推出的重磅开源模型。当时Llama 4的市场反应平平,甚至一度让人怀疑Meta是否还在大模型的第一梯队之列。如今,随着扎克伯格本人也在社交平台亲自发帖祝贺,可以看出Meta对这款新模型寄予厚望。
Meta在开源大模型领域的布局可以追溯到2023年发布的Llama系列。Llama的开源策略在当时被视为对OpenAI闭源路线的直接挑战,也奠定了Meta在开源AI社区中的领导地位。Llama 2和Llama 3相继发布后,大量开发者基于这些模型进行微调和二次开发,形成了庞大的生态系统。然而Llama 4的发布未能延续这一势头,业界对其评价不一,部分原因在于竞争对手如通义千问广告、Mistral和Google Gemma等在同期取得了显著进步,使得Llama 4的相对优势不再明显。
Meta坚持开源大模型的策略背后有着深刻的商业考量。与OpenAI、Anthropic等依赖API调用收费的闭源模式不同,Meta的核心收入来源是广告业务,而非直接销售AI模型。通过开源策略,Meta可以实现多重战略目标:首先,培育开发者生态系统,使更多应用构建在Meta的技术栈之上,间接增强其平台粘性;其次,通过社区的广泛使用和反馈加速模型迭代,降低自身研发成本;再者,开源策略有助于在AI人才争夺战中树立技术品牌形象,吸引顶尖研究者加入。这一策略也被称为"开源护城河"——当足够多的企业和开发者基于Llama或Muse系列构建产品时,Meta的技术标准就成为事实上的行业基准。
模型的命名颇有深意:Muse是古希腊神话中的缪斯女神,象征智慧与灵感;Glimmer意为"微光"。两者结合,寓意"缪斯的微光"。这道微光能否照亮Meta的卷土重来之路,正是本次评测想要探究的问题。
值得注意的是,30B(300亿参数)级别的大模型在当前AI生态中处于一个非常关键的"甜蜜点"位置。相比70B或更大规模的模型,30B级别模型可以在消费级GPU(如单张NVIDIA RTX 4090或A100)上进行推理部署,大幅降低了硬件门槛。同时,相比7B-13B的小型模型,30B级别在复杂推理、多步逻辑和知识覆盖面上有明显提升。这使得30B级别成为企业私有化部署和个人开发者本地运行的主力选择,也是各大厂商竞争最激烈的参数区间之一。
这一"甜蜜点"的形成与当前GPU硬件架构密切相关。以NVIDIA RTX 4090为例,其配备24GB GDDR6X显存。使用4-bit量化技术(如GPTQ或AWQ),30B参数模型大约需要15-18GB显存,刚好可以在单卡上运行并留有余量用于上下文窗口。量化(Quantization)是一种模型压缩技术,通过降低权重参数的数值精度(如从16-bit浮点数降至4-bit整数)来减少显存占用和计算量,同时尽量保持模型性能。目前主流的量化方法包括GPTQ(后训练量化)、AWQ(激活感知权重量化)和GGUF(面向CPU推理的量化格式),各有其适用场景和精度-效率权衡。正是这种硬件与模型规模的适配关系,使得30B级别成为兼顾性能与可部署性的最优区间。
评测方法:用高考数学题检验真实推理能力
为了检验Muse Glimmer的真实能力,本次评测选择了一个颇具挑战性的场景——全国一卷高考数学题。这一选择很有代表性:高考数学题不仅考验模型的数学推理能力,还对答案格式的规范性提出了严格要求。
选择高考数学题作为评测基准,在方法论上有其独特优势。高考题经过严格的命题审核流程,题目质量和难度梯度有保证,且每道题都有唯一确定的标准答案,评判标准客观明确。这与许多主流AI基准测试(如MMLU、HumanEval)不同——这些标准化测试集因被大量引用和公开讨论,已经面临严重的"基准饱和"问题,即模型在这些测试上的高分可能并不完全反映真实能力。高考数学题涵盖了函数与导数、概率统计、立体几何、解析几何等多个知识领域,要求模型具备多步骤逻辑推理、公式推导和数值计算的综合能力,是检验数学推理能力的高质量测试场景。
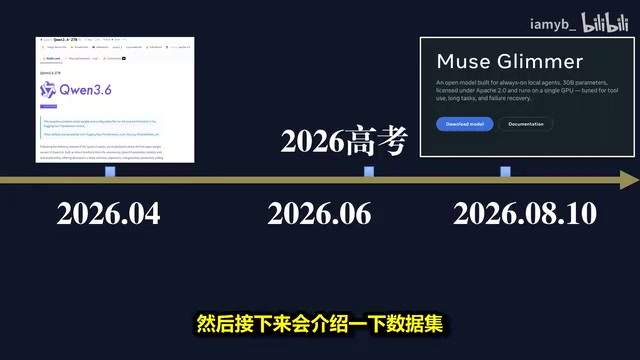
评测方对比的另一款模型是通义千问3.6 27B,其发布时间早于高考;而Muse Glimmer则是在高考结束后约两个月发布的。这一时间差值得注意——理论上,后发布的模型更难"提前见过"这套题目,测试结果的公平性反而更高。这里涉及大模型评测中一个重要的方法论问题——数据污染(Data Contamination)。如果评测所用的题目在模型训练数据中已经出现过,那么模型可能通过"记忆"而非"推理"来给出正确答案,导致评测结果虚高。2024年高考题在考试结束后会迅速在互联网上传播,理论上可能被后续训练的模型"看到"。因此,在高考之前发布的模型(如通义千问3.6 27B)反而在评测公平性上更具说服力,因为其训练数据中不太可能包含这些题目。
数据污染是当前大模型评测领域最棘手的方法论挑战之一。其本质问题在于:当互联网上的公开数据被大规模爬取用于预训练时,评测数据集的题目和答案很可能已经混入训练语料。研究表明,即使是轻微的数据污染也可能导致评测分数虚高5-15个百分点。目前学界提出了多种应对策略:一是使用时间戳作为过滤条件,确保评测数据在模型训练截止日期之后才发布;二是采用"金丝雀字符串"(Canary Strings)技术,在数据中嵌入特殊标记以检测是否被模型记忆;三是设计动态生成的评测题目,使模型无法通过记忆作答。本次评测中关注模型发布时间与高考时间的先后关系,正是在方法论层面对数据污染风险的审慎考量。
数据集构建细节
评测者使用工具从高考数学卷中提取出客观题,构建了一个JSONLines格式的数据集。JSONLines(也称JSONL)是一种轻量级的数据存储格式,每行一个独立的JSON对象,非常适合大规模数据集的流式读取和处理。相比传统的JSON数组格式,JSONL在处理大文件时无需将整个文件加载到内存中,效率更高。
数据集中所有数学公式均采用LaTeX格式表达,总共包含14道题目。LaTeX是学术界和工程界广泛使用的数学公式排版系统,能够精确表达分数、积分、矩阵等复杂数学符号。在大模型评测中使用LaTeX格式的数学题,不仅考验模型对LaTeX语法的解析能力,还间接测试了模型在预训练阶段对学术文献和数学内容的学习深度。每个模型运行三次,以统计结果的稳定性。
值得一提的是,提交给大模型的提示词中并不包含题型提示信息(即不会告诉模型这是单选题、多选题还是填空题),需要模型自行判断题型。这一设计大大提高了测试难度,更贴近真实的解题场景。
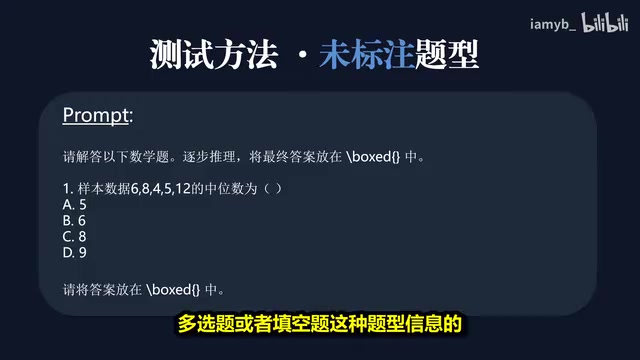
评测指标详解:语义正确率、稳定性与格式规范
本次评测设置了多个维度的指标,全面衡量模型的实际表现:
- 语义正确率:测试模型的数学推理能力,即答案在语义上是否正确;
- 三次全对率:三次运行全部答对的占比,反映模型表现的稳定性;
- 格式正确率:测试模型遵循输出格式规范的能力。
模型返回结果后,测试脚本会自动提取答案,并与数据集中对应题目的参考答案进行比对。
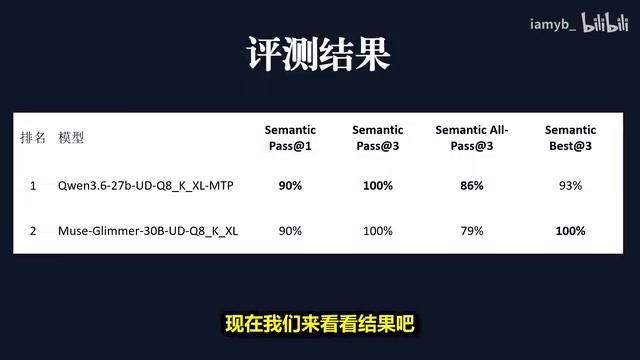
通义千问3.6 27B全面胜出
从结果来看,通义千问3.6 27B在各项指标上都表现更优。在代表答题稳定性的语义三次全对率上,千问明显胜出;在格式正确率上,千问同样领先Muse Glimmer不少。
评测者特别举了一个例子:即便是Muse Glimmer格式遵循最好的一次测试,在几道单选题上,标准答案应为选项对应的字母,但模型却把选项对应的数值也一并带了出来,导致格式不够规范。三次测试中,其他两次也存在类似问题。
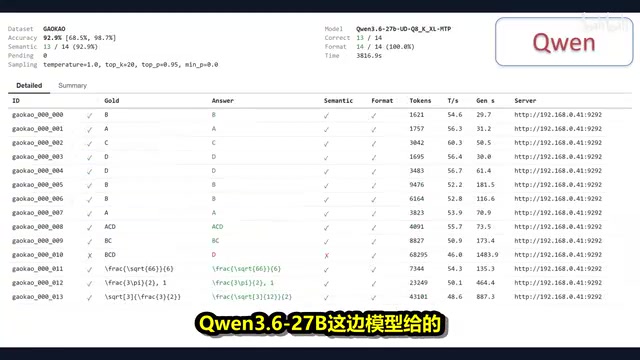
格式正确率和指令遵循能力是大模型从"实验室产品"走向"生产可用"的关键指标。在实际应用中,大模型通常需要将输出结果传递给下游系统进行自动化处理,例如通过正则表达式或JSON解析器提取结构化数据。如果模型在回答单选题时将"A"输出为"A. 3/4",虽然语义上可能正确,但会导致自动化评分系统无法正确匹配。
这种能力的背后涉及到模型在RLHF(基于人类反馈的强化学习)和SFT(监督微调)阶段的训练质量。RLHF和SFT是当前大模型后训练阶段的两大核心技术。SFT阶段使用人工标注的高质量指令-响应对对模型进行微调,使其学会遵循指令的基本模式。RLHF则更进一步:首先训练一个奖励模型(Reward Model)来模拟人类的偏好判断,然后使用PPO(Proximal Policy Optimization,近端策略优化)等强化学习算法,引导语言模型生成人类偏好的响应。近期,DPO(Direct Preference Optimization,直接偏好优化)作为RLHF的替代方案也备受关注,它无需单独训练奖励模型,直接从偏好数据中优化策略,简化了训练流程。这些后训练技术的质量直接决定了模型在格式遵循、安全性和实用性方面的表现。高质量的指令微调数据和对齐训练是提升格式遵循能力的核心手段。
相比之下,通义千问27B给出的答案在格式上总体更加干净利落,观感明显更好。从对高考数学题的整体表现来看,通义千问3.6 27B依旧是30B这一级别中最好的模型。评测者还提到,虽然未将Google Gemma的数据纳入本次对比,但实际上Gemma的表现也要优于Muse Glimmer。
开源生态的积极信号:竞争推动进步
尽管Muse Glimmer在本次评测中未能超越通义千问和Gemma,但对整个开源社区而言,Meta的回归无疑是一件好事。
开源大模型领域的竞争,本质上是一场良性的"军备竞赛"。头部厂商持续投入、不断迭代,最终受益的是广大开发者和用户。Meta作为曾经Llama系列的开创者,其重新入场将为开源生态注入新的活力,也会倒逼其他厂商加快创新步伐。
2024-2025年的开源大模型竞争格局呈现多极化态势。除了Meta的Llama/Muse系列外,阿里巴巴的通义千问(Qwen)系列凭借出色的多语言能力和数学推理表现,已成为开源社区最受欢迎的模型之一。Google的Gemma系列以高效的架构设计著称,在同参数量级下展现出极具竞争力的性能。法国创业公司Mistral以精巧的模型架构和高效的推理速度闻名,其MoE(Mixture of Experts,混合专家)架构在保持高性能的同时显著降低了计算成本——MoE架构的核心思想是将模型参数分成多个"专家"子网络,每次推理时仅激活其中一部分,从而在不增加计算量的前提下扩展模型总参数量。此外,DeepSeek广告、01.AI等中国厂商也在开源模型领域持续发力。这种多方竞争的格局对开发者极为有利——更多的选择意味着更低的迁移成本和更强的议价能力,也推动了整个行业的技术标准不断提高。
值得思考的是,这次评测也揭示了当前开源模型竞争的一个关键点:综合能力的均衡性。Muse Glimmer在数学推理上或许并非完全落后,但在格式遵循这类"工程化细节"上的短板,反而拉开了与竞品的差距。这提醒我们,评价一个大模型的实用价值,不能只看单一的推理能力,格式稳定性、指令遵循等"软实力"同样至关重要。这些"软实力"的提升,往往依赖于后训练阶段(Post-training)的精细打磨,包括高质量的人类偏好数据收集、多轮RLHF迭代以及针对特定下游任务的专项优化。这也意味着,一个优秀的开源模型背后,不仅需要强大的预训练基础,更需要在对齐和微调环节投入大量的工程资源。
希望Meta能够再接再厉,在后续版本中带来更好的模型,让这道"缪斯的微光"真正照亮开源大模型的未来。
核心要点
相关推荐

吴恩达联手Anthropic:Claude Code保姆级实战教程全解析
吴恩达与Anthropic合作推出Claude Code短课程,系统讲解清晰上下文、并行会话、MCP服务器等最佳实践,并通过RAG聊天机器人、Jupyter数据分析、Figma转前端三个实战项目,带你从零掌握这款高自主性编程助手。

入门Agent只推荐三个:ZeroStack、Claude Code与DeepSeek Harness
B站UP主推荐三款入门Agent:ZeroStack适合轻量设备,Claude Code生态完善,DeepSeek Harness易于集成插件。本文梳理各工具适用场景与实用技巧。

AI Agent如何操控你的电脑?Hermes三层工具链全解析
B站UP主小悠拆解Hermes操作电脑的三层工具链:出厂自带的Terminal、文件修改与代码执行底座,按需开启的联网搜索、视觉分析、语音合成与浏览器桌面控制,以及通过CLI和MCP自由扩展的外部生态,并解答SSH连上却操作不了的常见困惑。