Meta与出版商的AI数据之争:服务条款修改引爆互联网未来之战

Meta修改商业账户条款欲用关联数据训练AI,引发出版商和创作者集体反弹。
Meta悄然修改商业账户服务条款,允许利用与商业账户关联的任何网站或服务来训练AI模型,引发出版商和创作者强烈反对。Meta先让公关团队降温,后删除“训练”一词并解释新条款仅针对广告产品,但律师指出新条款仍保留AI训练权限。媒体行业组织联名致信扎克伯格要求正式谈判,Meta被迫将条款生效日推迟至11月20日。争议本质是平台试图通过默认同意的条款更新,合法化对海量第三方内容的攫取,剥夺用户说“不”的权利。创作者和企业需警惕关联资产被用于AI训练的风险,博弈远未结束。
Meta正深陷一场看似围绕服务条款的纠纷,实则关乎互联网未来走向的战争。争议的核心在于:Meta悄然修改了其商业账户的服务条款,允许公司利用与商业账户关联的任何网站或服务来训练其AI模型。这意味着,如果你用Instagram账户登录或关联了一个网站、一份新闻邮件,Meta理论上就可以抓取这些内容用于模型训练。据YouTube科技评论频道分析,这被出版商和创作者视为赤裸裸的越界行为。
事件复盘:从条款修改到集体反弹
Meta的初始回应与退让
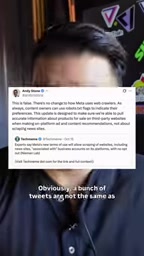
消息曝光后,舆论迅速发酵。Meta的第一反应是让公关团队出面降温,声称外界“反应过度”。然而,正如评论者所言,几条推文并不能等同于具有法律效力的服务条款。在压力之下,Meta发布了修订版协议,删除了“训练”一词,并解释新条款仅针对广告产品。
商业账户(Business Account)是Meta为在Facebook和Instagram上运营品牌、投放广告或管理主页的用户提供的账户类型,与个人账户分离。商业账户通常需要关联一个Facebook主页或Instagram专业账户,并可能绑定额外的联系信息、网站链接或第三方应用。Meta的服务条款中针对商业账户的部分与个人账户条款不同,因为商业账户被视为商业用途,其数据使用规则可能更为宽泛。此次争议的核心在于,Meta试图通过修改商业账户条款,将关联到商业账户的第三方网站或服务的内容也纳入可训练AI的数据范围,而许多用户并未意识到商业账户条款的变化会影响到其在Meta生态之外的内容。
律师与行业组织的二次狙击
退让并未平息事态。多位律师审阅新版条款后指出,即便措辞调整,Meta依然保留着训练AI模型的充分权限。随后,代表媒体行业利益的大型贸易组织联名致信马克·扎克伯格,明确表示该条款不可接受,要求就条款内容进行正式谈判。面对行业联合施压,Meta再次让步,将新条款的生效日期推迟至11月20日,外界普遍解读此举是为谈判留出窗口。
AI模型训练需要海量文本、图像等数据,通常来源于公开网络抓取、授权数据集或用户生成内容。然而,未经明确同意使用受版权保护的内容或用户私有数据训练模型,可能涉及版权侵权、违反合同甚至数据保护法规。Meta条款争议的关键在于,它试图通过服务条款的“默认同意”机制,将原本可能构成侵权的数据使用行为合法化。法律上,服务条款若未以显著方式提示用户并获得明确同意,其效力可能受到挑战。律师指出,即使Meta删除了“训练”一词,条款中关于“使用”“分析”关联内容的宽泛表述仍可能被解释为允许AI训练,因此需要更清晰的措辞和用户选择权。
为什么这不是一次普通的条款更新
表面看,这是一场关于数据授权的拉锯战。但更深层的矛盾在于,Meta试图通过一次服务条款的“默认同意”更新,完成对海量第三方内容的合法化攫取。评论者一针见血地指出,所有平台都渴望更多数据,尤其是为AI代理系统(如Meta的Muse)争取访问其他网站、收集数据并享有普通用户权限的能力。而这些权限从未经过任何形式的协商。
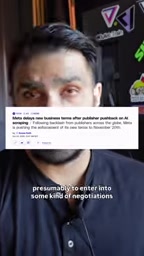
将如此重大的权限扩张塞进服务条款的例行更新中,之所以引发强烈反弹,是因为它剥夺了人们说“不”的机会。当AI开始颠覆互联网的运作方式,每一个被卷入其中的个体和机构,都理应拥有拒绝的权利。Meta此刻经历的,正是这种被压抑的反弹力的集中释放。
服务条款的“默认同意”是指用户在使用服务时,若未主动拒绝或退出,即被视为接受条款更新。这种机制在互联网平台中普遍存在,但用于重大权利变更时容易引发争议。欧盟《通用数据保护条例》(GDPR)等法规要求对数据使用目的变更需获得用户明确同意,而非默认同意。Meta此次条款更新试图利用默认同意机制,将原本可能受限的数据使用范围扩大至AI训练,这剥夺了用户事先协商和拒绝的机会。评论者强调,当AI系统需要访问第三方网站并收集数据时,平台应提供明确的退出选项,而非将重大权限扩张隐藏在例行条款更新中。
对创作者与企业的实际影响
对于在Meta生态内经营业务的创作者和企业而言,风险是具体而直接的。如果你的商业账户关联了独立站、博客或新闻邮件,按照原条款,这些内容都可能成为训练素材。尽管Meta已删除“训练”措辞并推迟生效日,但法律层面的不确定性依然存在。评论者提醒,当前版本仍可能被解读为允许AI训练,因此保持警惕、审慎评估关联资产是必要的自我保护。
对于创作者和企业而言,关联资产包括独立网站、博客、新闻邮件、作品集页面等。这些资产通常通过Meta商业账户的“联系信息”或“网站”字段与账户绑定,用于引流或身份验证。若Meta条款允许使用关联内容训练AI,则这些资产上的原创内容可能被纳入模型训练,而创作者可能无法追踪或获得补偿。此外,AI模型训练后的输出可能模仿或复制原创风格,对创作者的市场竞争力构成潜在威胁。因此,创作者应审查与Meta账户关联的资产清单,考虑是否需要在条款生效前解除关联,或通过法律途径要求Meta明确数据使用范围。
博弈远未结束
推迟条款生效只是缓兵之计,而非终局。媒体行业组织要求的正式谈判尚未有实质性结果,Meta是否会拿出真正尊重内容方权益的条款仍是未知数。这场冲突揭示了一个更广泛的趋势:AI时代的数据获取正在从“隐秘抓取”转向“条款授权”,而后者一旦缺乏透明度和协商机制,就会演变为平台与内容生态之间的信任危机。互联网的未来形态,或许就取决于这类条款谈判的走向。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。