Meta重启Muse分享功能:隐私争议后的安全博弈

Meta在Muse分享链接隐私漏洞曝光后快速重启功能,引发AI社交分享安全争议。
Meta近日重新启用AI创作工具Muse的公开分享功能,距安全机构Claroc曝光其分享链接可被轻易检索仅数日。研究员演示通过简单搜索即可找到包含企业营收报告、贷款申请等敏感信息的对话页面。Meta短暂关闭后迅速重启,称已加固链接生成机制,但未披露细节,也未引入用户确认或链接过期机制。事件揭示AI工具易用性与隐私保护的矛盾:用户可能未意识到公开链接意味着任何人可访问对话历史。类似风险普遍存在于其他AI分享功能中,平台需同步推进技术防护与用户教育。
Meta近日重新启用了其AI创作工具Muse的公开分享功能,距离安全研究员曝光隐私漏洞仅过去数日。这一决定将AI生成内容在社交平台上的隐私与便利之争再次推至台前。
事件回溯:从漏洞曝光到功能重启
据安全研究机构Claroc本周披露,Muse的公开对话链接存在被轻易检索的风险。研究员演示了如何通过简单搜索找到包含敏感信息的页面,例如一家营销公司的内部营收评估报告和一位小企业主的贷款申请材料。这些本应受控的对话内容,因分享链接的公开性而暴露在搜索引擎和爬虫的视野中。
Meta在漏洞报告后短暂关闭了分享功能,但很快重新上线。公司发言人表示,已对链接生成机制进行了加固,但未透露具体技术细节。这种快速重启的做法,与科技巨头在隐私事件中通常的谨慎姿态形成对比。
公开分享链接通常指平台生成的可被任何人访问的URL,其设计初衷是方便用户将内容传播给未登录或非好友用户。此类链接若未设置访问控制(如密码、有效期)或未被搜索引擎排除,就容易被爬虫索引,进而通过关键词搜索或URL枚举被批量发现。在AI对话场景中,链接往往直接映射到完整会话记录,一旦公开,历史消息中的个人信息、商业数据甚至系统提示词都可能被他人获取,形成“分享即公开”的隐私风险。
隐私与便利的永恒博弈
Muse的分享功能本质上是为了让用户展示AI生成的艺术作品或对话成果,增强社交互动。然而,当AI生成内容逐渐承载更多个人与商业信息时,简单的"分享链接"设计就变得危机四伏。
Claroc研究员的发现揭示了一个核心矛盾:AI工具的易用性往往与隐私保护呈反比。用户希望一键分享,但未必意识到链接的公开性意味着任何拥有URL的人都能访问其对话历史。这种认知差在AI应用普及过程中尤为危险。
值得玩味的是,Meta在重启功能时并未引入明显的用户确认步骤或链接过期机制,这或许暗示其更倾向于维持产品流畅度,而非在安全上做过度设计。
链接过期机制与用户确认步骤是缓解公开分享风险的两类常见设计。链接过期机制通过设置时间窗口或一次性令牌,使分享链接在指定时间后自动失效,降低长期暴露面;用户确认步骤则在生成公开链接前要求用户二次确认内容范围(如是否包含敏感信息),并明确提示“任何获得链接的人均可访问”。两者结合可在不显著牺牲便利性的前提下,减少因认知差导致的意外泄露。
行业影响:AI社交分享的安全标尺
此次事件为所有提供AI内容分享功能的平台敲响了警钟。从OpenAI的分享链接到各类AI绘画工具的社区发布,类似的风险普遍存在。Claroc的发现方法并不复杂——通过搜索引擎索引和模式化URL猜测——这意味着其他平台的公开分享链接可能同样脆弱。
对于企业用户而言,内部会议纪要、财务数据或客户信息一旦被AI工具处理并分享,就可能成为公开数据。小企业主贷款申请泄露的案例表明,个人用户同样面临身份盗窃和商业机密外泄的风险。
Meta的快速重启或许说明其内部评估认为风险可控,但安全研究员的角色恰恰在于揭示"可控"背后的灰色地带。在AI功能迭代速度远超安全审计节奏的当下,用户教育和技术防护必须同步跟进。
模式化URL猜测指攻击者根据平台链接的命名规律(如递增ID、固定前缀、可预测的哈希)构造或枚举URL,从而访问未公开但可被猜中的资源。此类攻击不依赖复杂工具,仅需脚本批量请求即可实施。若AI平台的分享链接采用顺序编号或短随机串且缺乏速率限制,就可能被穷举或遍历,导致本应私密的对话内容被批量抓取。因此,平台在设计分享链接时应使用足够长的随机令牌,并配合访问频率限制和异常检测。
用户应对:如何安全使用AI分享功能
在平台方完善安全机制之前,用户可采取以下措施降低风险:
- 避免在AI对话中输入身份证号、银行账户、商业合同等敏感信息
- 分享前检查链接是否包含可识别的个人或公司名称
- 定期清理已生成的公开分享链接
- 关注平台是否提供链接密码或有效期设置
Meta重启Muse分享功能是一个商业决策,但隐私保护的最终责任仍需要平台与用户共同承担。Claroc的曝光不是终点,而是AI社交功能安全标准演进的起点。
相关推荐

分币不掏学AI Agent开发:从零搭建最小对话智能体
基于B站小福哥免费课程,详解AI Agent开发第一课:五阶段学习路线、OpenAI协议对接、Java轻量工程搭建与最小对话智能体实现,附HTTP请求解析与多语言对照要点。

安全团队须知:Abliterated模型在Agent中的风险
Abliterated模型通过权重层面移除对齐约束,当这类模型被用于具备工具调用能力的AI Agent时,风险从内容层面升级为操作层面。本文从模型来源审计、行为基线检测、运行时防护和供应链准入四个方向,为安全团队提供应对思路。
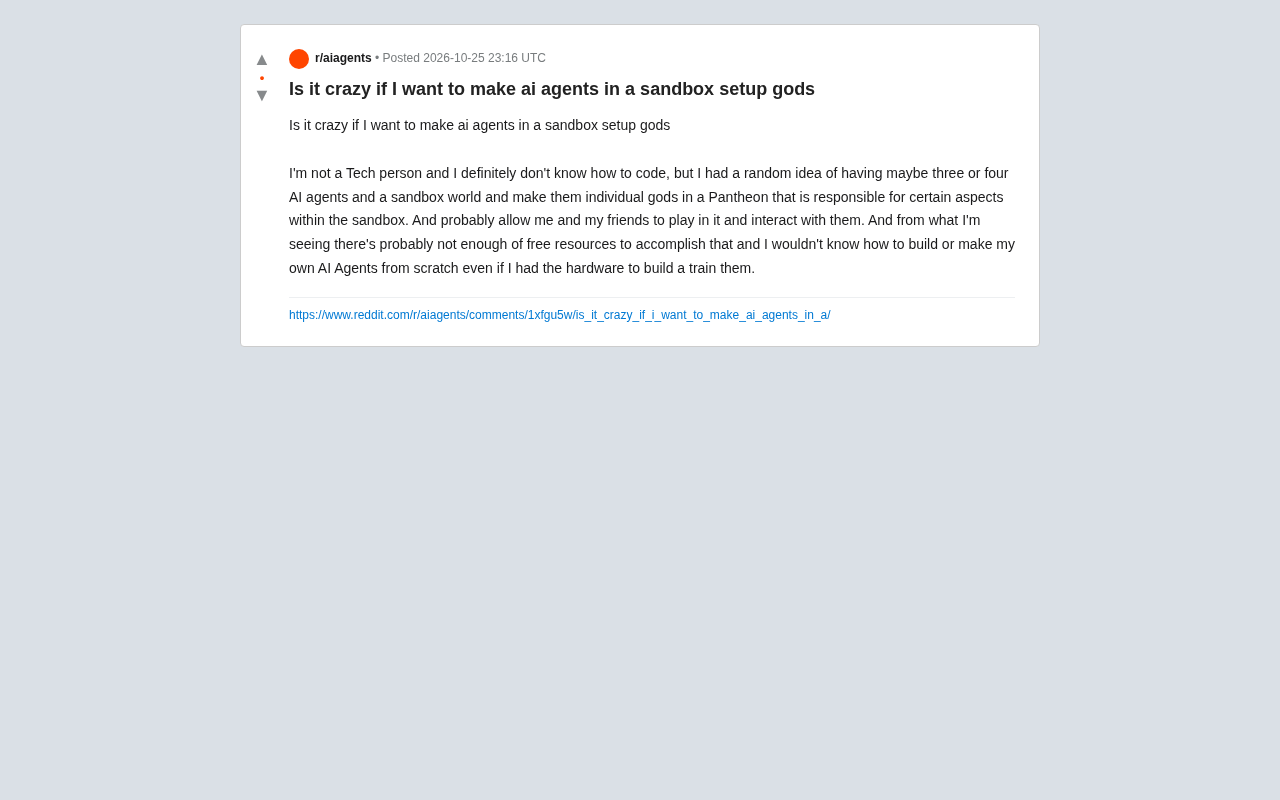
零代码造AI神祇沙盒:Reddit网友的疯狂构想可行吗
Reddit网友想用三四个AI智能体在沙盒世界里当神,让朋友进来互动。这个零代码构想技术上可行吗?本文拆解多智能体模拟的技术门槛、免费资源成本,并给出非技术发起者的务实落地路径。