幂等键难题:如何处理API重试中的“僵尸进程”
用数据库唯一约束实现幂等抢占声明,但进程崩溃导致的"死锁键"问题仍是分布式重试的未解难题。
本文围绕一个真实工程场景展开:发邮件接口超时后,客户端无法判断邮件是否已发出,重试会重发,不重试可能漏发。文章介绍了一种基于数据库唯一约束的幂等键方案——在业务逻辑执行前先插入 `org+key+endpoint` 唯一记录以"抢占"执行权,处理中的重试返回 409,完成后的重试返回缓存响应。然而该方案无法处理进程在调用外部服务途中崩溃的情形:幂等键被卡住直至 TTL 过期。短租约续约机制虽可加速恢复,却引入了存活误判导致双重发送的风险。文章最终给出三个缓解方向:借助下游服务商的去重能力、明确业务对"漏发"与"重发"的容错偏好、以及在幂等记录中细化执行阶段状态。
问题的起点:发邮件为什么不是幂等的
在构建 API 时,重试机制看似简单,实则暗藏陷阱。一位 Reddit 开发者分享了他在处理邮件发送接口时遇到的经典难题:发送邮件本身不是幂等操作(idempotent)。只有当邮件服务商接受请求并返回 message id 后,你才知道邮件真的发出去了。
这意味着,如果调用方的请求超时了,它根本无法判断邮件到底发没发——重试可能导致重复发送,不重试又可能漏发。这个矛盾在支付、通知、消息投递等场景中普遍存在,是分布式系统里绕不开的坎。
幂等性(Idempotency)是指对同一操作执行一次和执行多次所产生的效果完全相同。在 HTTP 语义中,GET、PUT、DELETE 被定义为幂等方法,而 POST 通常不是。发邮件属于典型的"有副作用的外部调用"——每次调用都可能触发一个新的邮件投递动作,服务端无法自动识别两次相同内容的请求是重试还是新请求。与之形成对比的是数据库的 INSERT ... ON CONFLICT DO NOTHING 或支付系统的"同一笔订单只扣款一次"——这类操作通过内部状态检查天然支持幂等。邮件、短信、Webhook 推送等场景之所以棘手,正是因为它们的副作用发生在系统边界之外,调用方无法在不引入额外状态的情况下安全重试。
现有方案:用幂等键“抢占”执行权
这位开发者的做法颇具代表性,值得拆解学习。
插入即“声明”
在真正的业务处理逻辑(handler)运行之前,先为每个 Idempotency-Key 插入一行记录。这张表的唯一约束建立在 org + key + endpoint 三个字段上。这一步插入操作,本质上就是一次“抢占声明”(claim)——谁先插入成功,谁就获得了本次请求的执行权。
三种重试状态的处理
基于这个声明机制,重试请求会被分成清晰的三类处理:
- 处理中重试:如果第一次请求还在跑,重试请求会因为唯一约束冲突而拿到
409 Conflict,明确告知客户端“正在处理,别急”。 - 完成后重试:如果请求已经处理完毕,重试会直接返回之前存储的响应结果,保证了幂等语义。
- 过期清理:这些记录会在 24 小时后自动清除,避免数据无限膨胀。
这套设计简洁而有效,把“防重复”的责任前置到了数据库的唯一约束上,逻辑清晰、易于实现。
尚未解决的核心:死掉的“持有者”
真正棘手的问题,在于进程在调用途中崩溃(dead owner)的情况。
当一个进程成功插入了幂等键、正准备调用邮件服务商时突然挂掉,这个键就被“卡住”了。因为记录已经存在,后续所有重试都会撞上 409,而实际的邮件却可能根本没发出去。结果就是:这个 key 会一直被占用,直到 24 小时的 TTL 到期才释放。这段时间里,业务实际上处于停滞状态。
两难的权衡
开发者也提出了一个候选方案:使用更短的租约(lease)配合续约(renewal)机制。让持有者定期续约,一旦续约停止,就认为持有者已死,可以释放锁。
但这引入了新的风险:如果存活检查(liveness check)判断失误——比如原进程只是网络抖动、GC 停顿或短暂卡顿,而非真正死亡——那么锁被提前释放后,新进程接管并再次发送邮件,就会造成双重发送(double send)。
这正是分布式锁领域的经典困境:租约设得太长,故障恢复慢;设得太短,误判风险高。二者难以兼得。
这一困境在学术上被称为"分布式系统的两将军问题"(Two Generals Problem)的变体,也与 FLP 不可能定理相关——在异步网络中,无法可靠区分"节点宕机"与"节点响应慢"。Redis 的 Redlock 算法作者 Antirez 与分布式系统研究者 Martin Kleppmann 之间的著名争论,核心正是短租约在网络分区或进程暂停(如 JVM GC Stop-the-World)情况下是否会导致锁的安全性失效。对于邮件发送这类场景,即便使用 NTP 校准的物理时钟也无法完全规避时钟漂移带来的判断误差,这是租约机制的理论上限,而非实现缺陷。
一些可能的思路
虽然原帖没有给出最终答案,但结合分布式系统的常见实践,这类问题通常有几个方向可以探索:
让下游具备去重能力
如果邮件服务商支持传入客户端指定的幂等键(部分主流服务商确实支持),那么即便发生双重发送,下游也能识别并去重。这相当于把幂等责任下沉一层,从根本上消除重复发送的后果,而不是单纯依赖上游锁的完美性。
Stripe、SendGrid、Postmark 等主流支付和邮件服务商均在 API 层面提供了幂等键支持。以 Stripe 为例,在请求头中传入 Idempotency-Key: <uuid> 后,服务端会在 24 小时内对相同 key 的请求返回缓存的原始响应,而不会重复执行收款操作。SendGrid 虽然没有原生幂等键,但支持通过自定义 Header X-SMTPAPI 传递唯一的 send_at 和批次 ID 来实现有限度的去重。这种"把幂等性下沉到服务商"的思路,是构建可靠消息投递系统时最值得优先评估的选项,因为它把复杂的分布式协调问题转变为了一次 API 文档查阅问题。
明确区分“最多一次”与“最少一次”
对于邮件这类场景,需要先想清楚业务能容忍哪种语义。如果“漏发”比“重发”更不可接受,那么在死亡持有者的判定上应倾向于更激进的重试,并配合下游去重;反之则应保守处理。工程决策要服务于业务的容错偏好。
记录执行阶段状态
可以在幂等记录中增加一个状态字段,标记请求处于“已声明未发送”“已发送待确认”“已完成”等不同阶段。持有者崩溃后,接管进程能根据状态判断是否安全重试,而非一刀切地重发或阻塞。
小结
这个来自实战的问题,浓缩了幂等性设计的精髓与局限。用数据库唯一约束实现“抢占声明”是一种优雅的工程手段,但它无法独自解决进程崩溃这一根本难题。
真正健壮的方案往往不是追求某一层的绝对可靠,而是通过上下游协同——上游做声明与去重、下游做最终去重——把风险分散消化。对于任何构建高可靠 API 的工程师而言,理解并权衡这些取舍,比套用某个现成模式更为重要。
相关推荐
临床AI治理难题:Concurrence如何用Unity Gateway管控万亿Token规模
临床AI几乎没有容错空间。本文解析 Concurrence 如何借助 Unity Gateway 在万亿Token规模下治理医疗AI,实现访问控制、合规审计与可观测性的统一,探讨医疗AI规模化落地的治理路径。
让轮询 Agent 真正 7×24 运行:从会话内定时到外部调度
轮询 Agent 只在笔记本会话开着时才运行?本文解析如何用 cron、systemd timer、Task Scheduler 等外部调度器让 Agent 真正 7×24 运行,并通过硬性超时、错误退避与心跳告警避免静默失败。
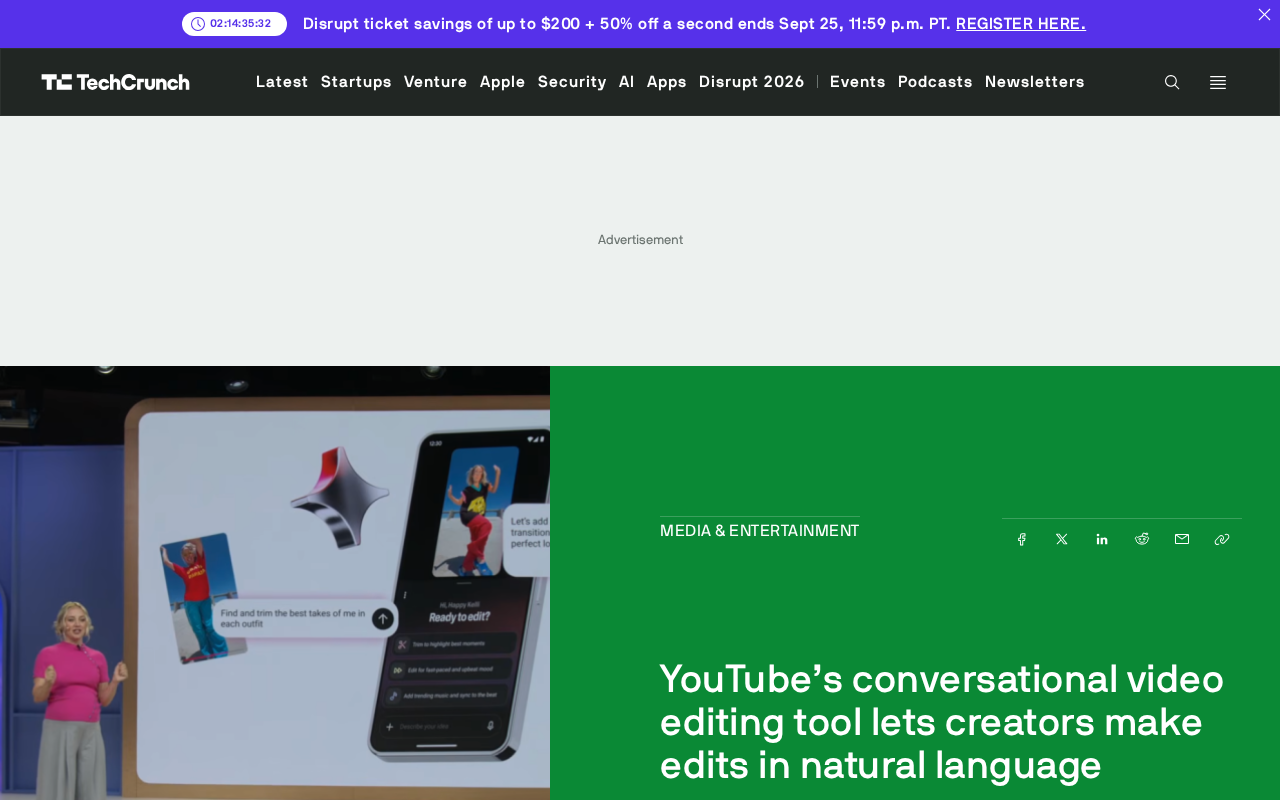
YouTube推出对话式视频编辑工具:用自然语言剪辑视频
YouTube推出对话式AI视频编辑工具,创作者可通过自然语言聊天界面完成视频剪辑,无需复杂的时间轴操作,大幅降低创作门槛并提升效率。