免登录AI编程助手实测:ChatGPT、Duck.ai与Gemini构建4个项目

实测ChatGPT、Duck.ai、Gemini免登录写代码:能用,但有限制与坑。
文章记录了一位创作者在全新无cookie浏览器中,用ChatGPT、Duck.ai和Gemini三个免登录AI聊天机器人完成四个真实编程项目的全过程。免登录模式可用,但存在使用轻量模型、次数限制、无历史记录、长回答易掉线等代价,Copilot和Perplexity则要求先登录。作者总结了给足上下文、先要计划、小步推进、索要完整文件、粘贴精确报错、要求测试并补充边界用例、对比多个机器人等七个习惯,并在贪吃蛇、Python待办、番茄钟和slugify对比四个项目中逐一验证。其中待办项目通过运行测试暴露了机器人写出的坏测试,slugify对比则显示三家对“标点”和重音字符的处理并不一致,各自测试通过不等于行为正确。
免登录AI编程助手:真的能用吗?
无需账号就能让AI帮你写代码、解释代码、甚至调试程序?一位YouTube创作者用三个免登录的AI聊天机器人——ChatGPT、Duck.ai和Gemini——完整做了四个编程项目,全过程真实输入、真实响应、程序在屏幕上真实运行。结果既有惊喜,也有明显的坑。
测试在全新浏览器配置、无cookie的环境下进行。Chat.com可以直接开聊,登录按钮可以无视;Duck.ai来自DuckDuckGo,只需接受一次条款;Gemini.google.com的轻量Flash模型同样支持未登录应答。相比之下,微软Copilot会直接跳转登录页,Perplexity也要求先注册,因此被排除在外。
据该创作者在视频中的演示,免登录模式并非没有代价:使用的是更轻量的模型、有使用次数限制、没有历史记录保存,长回答偶尔会失败——ChatGPT在测试中多次出现“无法连接”,按重试可恢复。
免登录模式的实际限制与安全提醒
免登录带来便利,但限制也很明确。没有账号意味着没有对话历史,任何想保留的代码都要立即复制出来。轻量模型在长回答上更容易中断,视频中ChatGPT的长回答多次中途掉线,需要重试一到两次才能完整收到。
安全方面,创作者反复强调:永远不要把密码、API密钥、公司私有代码或个人数据粘贴进任何聊天机器人。同时要阅读各站点的条款——ChatGPT明确表示对话可能被审查并用于改进模型,而Duck.ai声称对话经过匿名化处理且不用于训练。两者的数据处理方式差异,值得用户在选择工具时纳入考量。
七个提升效率的使用习惯
视频总结了一套让聊天机器人写代码更好用的习惯:
- 给足上下文:语言、版本、依赖库、运行环境。
- 先要计划再要代码:让机器人先给出结构方案。
- 小步推进:一次只加一个功能。
- 索要完整文件:每次更新都要求输出完整文件,避免手动拼接出错。
- 粘贴精确报错:出错时把完整错误信息原样贴回去。
- 要求测试并自己补充:让机器人写单元测试,再自己加边界用例。
- 让机器人解释代码,以及在关键问题上对比两三个机器人。
这些习惯在后面四个项目中逐一得到验证。
项目一:单文件HTML贪吃蛇(Duck.ai)
第一个项目用Duck.ai做一个纯JavaScript、Canvas、无第三方库的单文件贪吃蛇。创作者先声明自己是初学者,要求先给简短计划、暂不写代码。计划列出蛇身用网格单元格列表、游戏循环、方向键控制、食物、碰撞检测、带重启的游戏结束。
随后要求按计划输出完整文件:20x20网格、方向键与WASD、计分、每吃一个食物加速、游戏结束提示、空格重启,全部放在一个代码块里。约200行返回,函数命名清晰(startGame、placeFood、moveSnake、draw),速度参数放在文件顶部便于调整。
粘贴保存为snake.html,浏览器打开一次通过:分数增长、蛇身变长、吃食物后移动延迟缩短。随后让Duck.ai用简单语言解释游戏循环与碰撞检测,回答简短准确:调度移动、执行移动、再调度下一次;碰撞检测判断新蛇头是否越界或落在蛇身上。
Canvas 是 HTML5 提供的位图画布元素,通过 JavaScript 的 2D 渲染上下文(getContext('2d'))绘制图形。贪吃蛇这类游戏通常用 fillRect 画蛇身与食物、用 clearRect 擦除上一帧,再配合 requestAnimationFrame 或定时器形成动画循环。相比 DOM 元素,Canvas 把所有像素画在同一张画布上,性能更好、坐标控制更直接,适合网格化的小游戏,但无法用 CSS 单独选中画布内的图形。
项目二:Python命令行待办应用(ChatGPT)
第二个项目用未登录的ChatGPT分步构建Python待办应用。上下文给得很具体:Linux、Python 3.12、仅标准库、脚本名todo.py、任务存入tasks.json。
第一步只要add和list命令,用argparse实现。回答聚焦:JSON读写函数、每个命令一个函数、argparse子命令,还附了JSON示例。第二步增加done和remove命令,要求显示完成标记、兼容旧任务文件、并给出完整更新后的文件。
“索要完整文件”这一步很关键——让机器人自己决定每段代码的位置,反而避免了复制粘贴错位。旧格式任务文件仍能正常加载。
随后要求用unittest写测试,并指定用临时文件以免碰真实任务数据。七个测试通过、一个失败:测试期望找到添加消息,却拿到了列表输出。
argparse 是 Python 标准库自带的命令行参数解析模块。它支持定义位置参数和可选参数,并能把命令拆成子命令(subcommand),例如 todo.py add "买牛奶" 与 todo.py list 分别对应不同的处理函数。argparse 还会自动生成 -h/--help 帮助信息,并能在参数缺失或非法时给出错误提示。相比手工解析 sys.argv,它让多命令的 CLI 结构更清晰,也便于后续扩展 done、remove 等命令。
调试环节:把精确报错贴回去
创作者把失败信息从fail行到断言错误整段粘贴回ChatGPT,问“bug在todo.py还是测试里”。这里再次出现长回答掉线,重试两次后才完整收到答案。结论是bug在测试本身:测试调用了add_task却去捕获list_tasks的输出。修正后的测试重新运行,八个测试全部通过。
这个环节的启示很直接:机器人写出的bug,也能由机器人定位和修复,但真正抓住问题的是运行测试这个动作。
项目三:番茄钟计时器(Gemini)
第三个项目用Gemini的Flash模型,一条提示词给出完整功能清单:大号倒计时、开始/暂停/重置、专注与休息模式、深色主题、Web Audio API提示音、支持0.1这样的小数分钟以便快速测试。
Gemini回答很快,一个代码块加两句使用说明。代码里有深色主题CSS、setMode函数切换两种模式、toggleTimer控制开始暂停、基于振荡器的beep函数。粘贴保存为pomodoro.html,打开即用:休息切到5分钟、专注回到25分钟、开始后按钮变为暂停、重置恢复完整时长。输入0.1分钟(6秒)测试,倒计时归零停止并触发提示音。
项目四:三款机器人对比写slugify函数
最后一个项目把同一条提示词发给三个机器人:写一个把博客标题转成URL slug的函数,转小写、空格与标点合并为一个连字符、首尾不留连字符,附三个assert测试,通过则打印OK。
ChatGPT用一个正则表达式处理非单词字符与下划线,再去掉首尾连字符,还附了docstring。Duck.ai基于Python的空白与标点列表构造字符类,测试里用了带大量点和问号的标题。Gemini只保留A-Z和数字,其余全部转为连字符,答案最短。三者各自通过了自己的测试。
创作者随后加入自己的边界用例:带重音的“Cafe”、Python中的长破折号。
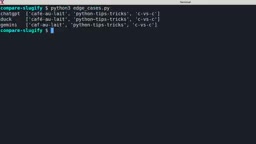
结果出现分歧:Gemini直接丢弃重音字母;Duck.ai保留了长破折号,因为它不在Python的标点列表里。这说明三个机器人对“标点”的定义并不一致,各自的测试通过不等于行为正确。
slugify 是把文章标题等人类可读文本转换成 URL 友好字符串的常见操作,通常要求统一小写、把空格和标点替换为连字符、去除首尾连字符,并避免产生连续连字符。不同实现的关键分歧在于“标点”如何定义、非 ASCII 字符(如带重音的 é)是保留、转写还是丢弃。URL slug 需要稳定、可读且便于分享,因此边界情况处理是否一致,往往比简单用例能否通过更能反映实现质量。
一天实测的结论与边界
创作者给出的公平总结:三个都能免登录工作;ChatGPT回答谨慎、解释充分,但在其网络环境下多次丢失长回答;Duck.ai在200行游戏项目上表现可靠;Gemini最快、代码最短。他强调这只是小样本,不构成基准测试,且这些服务的模型经常变动。
最重要的免责声明同样适用于所有AI编程场景:聊天机器人会犯错——逻辑错误、遗漏边界情况、过时API,甚至写出坏测试。运行代码、测试代码、读代码,再决定是否信任。不要运行自己不理解的命令,尤其是删除文件或需要管理员权限的命令。检查许可证以及学校或公司的规定,最终对代码负责的是你自己。
回顾整套方法:给上下文、先计划、小步走、贴精确报错、要测试和解释、对比多个机器人,以及——把秘密留在聊天框之外。
背景补充
unittest 是 Python 标准库中的单元测试框架,测试以继承 TestCase 的类组织,方法名以 test_ 开头,通过 assertEqual、assertIn 等断言判断结果。它支持 setUp/tearDown 在每个测试前后准备和清理环境。这里用 tempfile 模块创建临时文件模拟 tasks.json,避免测试污染真实的待办数据;测试失败时 unittest 会输出 FAIL: 行及断言差异,把这段完整信息贴回聊天机器人,正是定位问题的关键线索。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。