免费AI工具RIA爆红:一键逆向拆解任何应用

开源项目RIA用AI逆向分析应用、网站和游戏,并显式列出未能解析的部分。
RIA(Reverse Engineer Anything)是近期登顶GitHub趋势榜的开源项目,定位为面向AI的逆向工程工作流封装:用户把应用、网站或游戏交给它,AI会推断其界面构成、数据流动与逻辑组织,并输出可理解的结构描述。它最受关注的设计是显式输出“未能解析”清单,在流程层面约束大模型自信编造的问题。项目支持一条命令部署、免费开源,社区已有重建开源会计应用、复刻街机游戏等案例。但工具本身不判断合法性,使用者需自行确认目标软件是否在允许分析的范围内。文章认为这反映了AI从生成内容走向理解系统的趋势。
GitHub上最近冒出一个登顶趋势榜的开源项目,名字很直白——RIA,全称Reverse Engineer Anything(逆向工程任何东西)。它的定位是给AI配上一套"拆解工具",让模型能够分析一个应用、网站或游戏到底在做什么,并输出可理解的结构与逻辑。更关键的是,它还会明确告诉你哪些部分没能搞明白,而不是一脸自信地胡编。
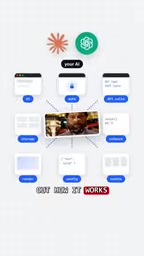
RIA是什么:让AI动手拆应用
从项目描述看,RIA并不是一个传统意义上的反编译工具,而是一个面向AI的工作流封装。你把目标——一个应用、一个网站、甚至一款游戏——交给它,它会让AI去推断这个东西的运行机制:界面由什么构成、数据如何流动、逻辑怎么组织。
据该项目的介绍,它支持一条命令完成部署,使用门槛被压得很低。真正让它在GitHub趋势榜上冲到第一的,是它把"逆向工程"这件原本需要相当专业背景的事,包装成了普通人也能上手的流程。
反编译通常指将编译后的机器码或字节码还原为可读的源代码或中间表示,工具如 IDA Pro、Ghidra、JD-GUI 等,属于静态分析范畴;逆向工程的范围更宽,除了反编译,还包括动态调试、协议抓包、行为观测等手段,目标是理解系统的结构、数据流与设计意图。传统逆向工程高度依赖专家经验,需要熟悉汇编、文件格式、网络协议等底层知识。RIA 的差异在于,它并不直接提供反汇编器或调试器,而是把大模型作为推理引擎,让 AI 基于工具采集到的信息去“推断”系统在做什么,输出偏向高层的结构与逻辑描述。这种路径的优势是门槛低、可读性强,劣势是推断结果可能不精确,因此才需要显式列出“未能解析”的部分。
核心设计:承认"我不知道"
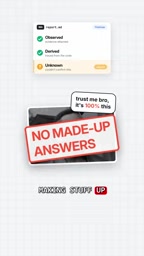
RIA在技术态度上有一个值得单独拿出来说的设计:它会输出一份"未能解析"的清单。
大模型在被要求解释陌生系统时,很容易生成听起来合理但实际错误的内容。RIA把不确定性显式暴露出来,等于在流程层面做了一层防幻觉约束。对做技术分析的人来说,这比一个"什么都敢答"的工具更有实用价值——你知道哪些结论可以直接用,哪些还需要人工验证。
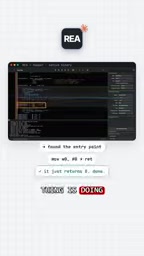
社区已经玩出了什么
项目走红之后,社区里的使用案例开始流传。据视频中提到的例子,有人拿QuickBooks做目标,最终产出了一个自己的开源会计应用;还有人借助它重建了一款老式街机游戏。这些案例的真实性和完整度外界难以逐一核实,但它们指向同一个方向:RIA被当作"理解既有软件并在此基础上重建"的起点,而不是终点。
这类玩法的想象力在于,很多中小团队或个人开发者面对成熟商业软件时,最大的障碍不是写代码,而是搞不清对方的产品结构。RIA试图把这个认知成本降下来。
使用前必须想清楚的事
RIA免费、开源、一条命令即可安装,但视频里有一句提醒相当关键:你需要勾选"你被允许分析"的软件范围。换句话说,工具本身不判断合法性,判断责任在使用者。
逆向工程在不同司法辖区的法律边界差异很大,涉及商业软件时尤其敏感。用于学习、安全研究、互操作性开发,与直接复制他人产品,是完全不同性质的事情。RIA降低了技术门槛,但并没有、也不可能降低法律门槛。
逆向工程的合法性在不同法域差异显著。以美国为例,《数字千年版权法》(DMCA)第 1201 条原则上禁止规避技术保护措施,但设有若干例外,互操作性开发、安全研究、加密研究等在满足条件时可获得豁免;欧盟《软件指令》允许为互操作性目的进行反编译,但须满足特定前提。中国《著作权法》及相关司法解释对反向工程未作专门规定,司法实践中通常结合目的、手段和后果综合判断。总体而言,出于学习、安全研究、互操作性开发等目的,与直接复制他人产品并商业化的性质完全不同。工具本身不内置合法性判断,使用者需要自行确认目标软件的用户协议、许可条款以及当地法律是否允许相关分析行为。
这类工具意味着什么
RIA登上GitHub趋势榜首,反映的是一个更宏观的变化:AI正在从"生成内容"走向"理解系统"。当模型具备了拆解既有软件的能力,软件行业的竞争逻辑可能会部分转移——护城河不再只是代码本身,还包括数据、服务、生态和持续迭代的速度。
对开发者而言,这类工具最现实的价值是学习效率。面对一个陌生的代码库或一个没有文档的老系统,能有一个工具帮你先画出结构草图,再标注出存疑之处,比自己从头猜要省太多时间。至于它能走多远,取决于社区能否把那些"未能解析"的部分持续补上。
背景补充
大模型幻觉指模型在缺乏依据时仍生成看似合理但事实错误的内容,在解释陌生系统时尤为常见,因为模型倾向于用训练数据中的常见模式去填补未知细节。常见的缓解手段包括检索增强生成(RAG)、要求模型引用来源、引入外部验证工具,以及让模型显式表达置信度。RIA 采用的策略属于“不确定性显式化”:与其让模型对每个模块都给出确定结论,不如把无法从采集信息中推断的部分单独列出,交由人工复核。这种做法在工程上相当于把模型的输出分成“有依据的推断”和“待验证的假设”两类,降低了使用者盲目采信的风险,但也要求使用者具备判断哪些结论可信的基本能力。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。