免费机器学习工作坊:从传统ML到图神经网络
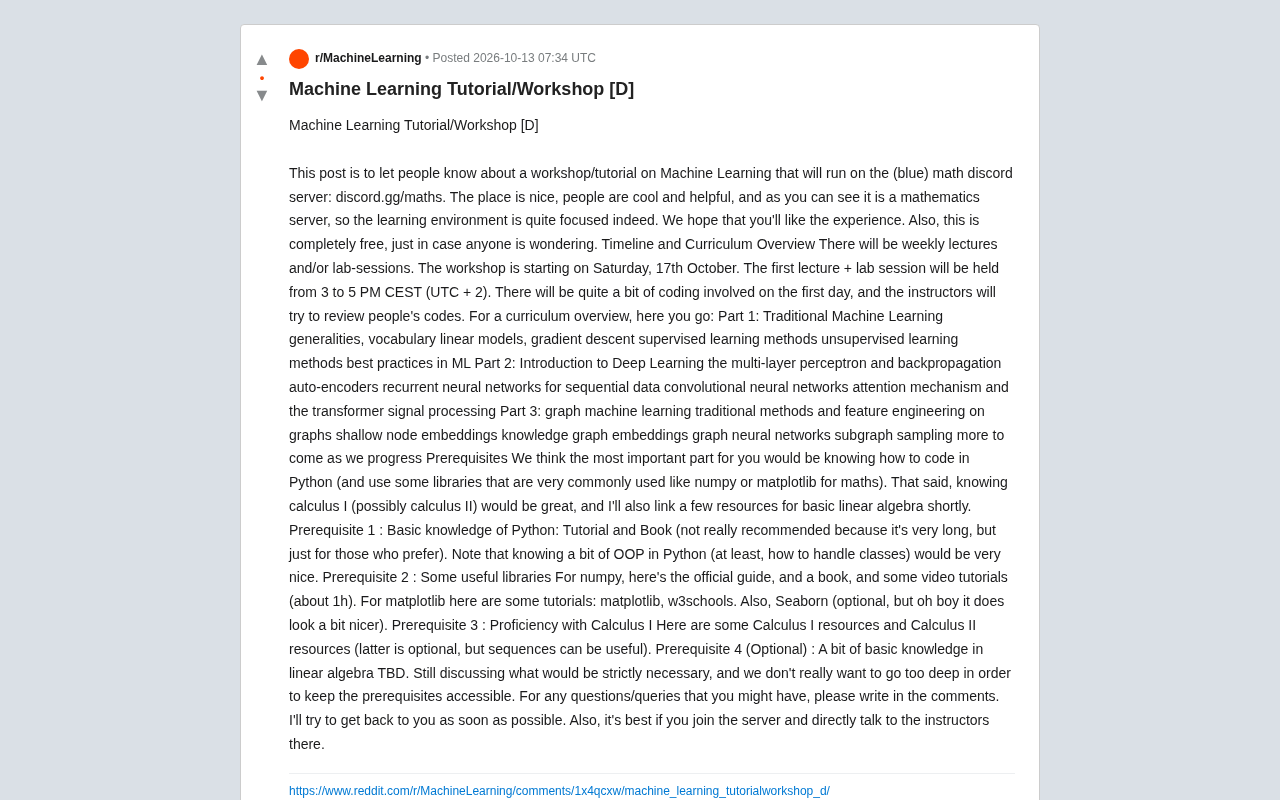
数学Discord服务器免费开办ML工作坊,从传统ML一路讲到Transformer与图神经网络。
一个数学 Discord 服务器正在组织完全免费的机器学习系列工作坊,采用每周讲座加实验课的形式,讲师会逐份 review 学员代码,属于需要动手交作业的训练营模式。课程分三部分:传统机器学习(线性模型、梯度下降、监督与无监督学习)、深度学习入门(多层感知机、自编码器、RNN、CNN、注意力与 Transformer、信号处理)以及图机器学习(图上传统方法、浅层节点嵌入、知识图谱嵌入、GNN 与子图采样)。报名前置要求以 Python 编程为核心,需掌握 numpy 和 matplotlib,了解面向对象编程更佳;数学方面要求微积分 I,线性代数仅需基础。组织者建议直接加入 Discord 与讲师交流,而非仅在帖子下提问。
免费机器学习工作坊:从传统ML到图神经网络
一个数学 Discord 服务器上正在组织一场完全免费的机器学习系列工作坊,课程覆盖从传统机器学习到深度学习和图神经网络的完整知识路径。对于想系统入门 ML 但苦于找不到合适学习小组的人来说,这种有讲师带、有作业改、有社区讨论的环境,可能比独自刷网课效率高得多。
工作坊基本安排
据 Reddit 上发布的招募帖,活动将在名为 maths 的 Discord 服务器(discord.gg/maths)上进行,每周安排讲座和/或实验课。服务器本身是一个数学社区,氛围专注,参与者普遍乐于互助,这对学习 ML 所需的大量数学推导来说是个不小的加成。
参与者需要提前做好准备:课程涉及相当多的编码练习,讲师会尽量逐份review学员提交的代码。这意味着它不是那种只听不练的讲座,而是需要真正动手写代码、交作业的训练营模式。
课程大纲:三个部分覆盖ML全栈知识
根据帖子公布的课程安排,整个工作坊分为三个部分。
Part 1:传统机器学习。 从整体概念和术语讲起,涵盖线性模型与梯度下降、监督学习方法、无监督学习方法,最后落脚到机器学习的最佳实践。这部分解决的是"ML是什么、怎么用"的基础问题。
Part 2:深度学习入门。 包括多层感知机与反向传播、自编码器、处理序列数据的循环神经网络、卷积神经网络、注意力机制与 Transformer,以及信号处理。可以看到,这份大纲把 Transformer 放在了深度学习入门的框架里,而不是作为孤立的高级专题,思路比较清晰。
Part 3:图机器学习。 内容涵盖图上的传统方法与特征工程、浅层节点嵌入、知识图谱嵌入、图神经网络,以及子图采样。帖子也注明后续会随进度持续补充更多内容。图神经网络在推荐系统、分子建模等领域应用越来越广,把这部分单列出来,说明组织者对课程深度有一定追求。
前置要求:Python是硬门槛
帖子对报名者的基础提出了明确要求,总结起来核心是四项。
最关键是 Python 编程能力,尤其是常用科学计算库。需要会用的包括 numpy(官方指南、书籍和约1小时的视频教程都有推荐)和 matplotlib(提供了官方教程和 w3schools 教程),Seaborn 属于可选但"好看很多"的工具。此外,了解一点 Python 面向对象编程(至少知道怎么处理类)会更顺利。
数学方面,微积分 I 是要求之一,微积分 II 可选但对理解序列有帮助;线性代数只要求基础水平。组织者坦言仍在讨论线性代数到底需要多深,但明确表示不想挖太深,以保持入门门槛可接受——这个取舍对于面向大众的工作坊来说是合理的。
门槛不高,但承诺不低
这场工作坊的定位值得一说。免费、开放、以数学社区为依托,但从课程大纲看,它一路讲到了 Transformer 和图神经网络,并非浅尝辄止的科普。组织者用"每周讲座+实验"的节奏推进,还要review代码,这实际上对讲师和学员都提出了持续投入的要求。
原帖特别提到,有问题最好直接加入服务器和讲师交流,而不是只在帖子评论区提问。这说明整个项目的运转依赖社区内的即时互动——如果你打算参加,做好每周投入固定时间、参与讨论的准备会比单纯旁听收获大得多。
背景补充
Transformer 与注意力机制:注意力机制的核心思想是让模型在处理某个位置的信息时,能够「关注」序列中其他位置的内容,并按相关性分配不同权重。其基本形式是缩放点积注意力:将输入映射为 Query、Key、Value 三组向量,用 Q 与 K 的点积衡量相似度,经 softmax 归一化后对 V 加权求和。Transformer 则完全抛弃了循环结构,仅依靠这种注意力加上前馈网络、残差连接和层归一化来建模序列,从而支持高度并行计算,成为 BERT、GPT 等现代大模型的基础架构。理解这一部分是读懂当下主流 NLP 与多模态模型的前提。
图神经网络(GNN):传统神经网络假设数据是规则网格或独立样本,而图数据由节点和边构成,每个节点的邻居数量不固定、顺序无意义。GNN 通过「消息传递」机制解决这一问题:每一层中,节点先聚合邻居的特征信息,再与自身表示结合并经过非线性变换更新。经过多层堆叠,每个节点就能捕捉到多跳邻域的结构信息。常见变体包括 GCN(基于谱近似简化)、GraphSAGE(采样聚合,适合大图)和 GAT(引入注意力加权邻居)。GNN 广泛用于推荐系统、分子性质预测、知识图谱推理等场景,是当前图机器学习的核心方法。
相关推荐

Product Hunt 推出可视化发布编辑器,告别繁琐填写
Product Hunt 推出可视化发布编辑器,支持点击原位编辑名称、标语、画廊和 maker 信息,自动保存草稿,并用检查清单引导创作者完成发布。本文解析其编辑逻辑与对发布体验的影响。

泽连斯基亲述:俄军2000万人压境,我们如何守住基辅
泽连斯基访谈回顾俄乌战争初期:俄军200,000兵力直扑基辅,乌军主力却在东部。他讲述动员如何将军队从200,000扩张到800,000,以及基辅州、切尔尼戈夫州如何被收复。

Ovren Live Preview:用自然语言实时预览产品改动
Ovren Live Preview 是一款用自然语言描述改动、在真实页面上实时预览的 AI 开发工具。了解其核心功能、工作流、市场定位与潜在挑战。