免费LLM API真相:无账号可用,但限额远超想象

2026年免费LLM API大幅收缩,代理式使用让有限配额迅速耗尽,需动态核实与灵活切换。
文章基于2026年10月的实测与官方文档,梳理了免费LLM API的现状:GitHub Models、Cerebras免费层、Gemini CLI和QN Code免费登录相继关停,且呈现“先削配额、再发通知、文档悄然更改”的可识别模式。剩余可用选项包括免账号的OpenCode Xen(10-14个轮换模型)、OpenRouter(17个免费模型但每天仅50次请求)、Google AI Studio、Grok和Cloudflare Workers等。文章重点指出,代理式工作流每次小修复约消耗6次请求、4万输入令牌,使“每天50次”仅够6-8个小修复;OpenRouter每个免费模型只有一个主机,主机繁忙即返回429且无故障转移。作者建议避免硬编码模型ID、在限额执行处核实、遇错切换模型而非重试。
免费LLM API的现状:2026年的洗牌
如果你还在参考网上那些"每天1000次免费请求"的列表,是时候更新认知了。据YouTube频道Big Iron在2026年10月19日发布的指南,多个曾承诺慷慨免费额度的服务已经关停或大幅收缩,而大多数在线列表并未跟上这一变化。
这一年的免费层级经历了显著收缩:GitHub Models于7月退役,Cerebras在8月结束了免费层级,Gemini CLI和QN Code背后的免费登录也在6月和4月先后关闭。作者在视频中明确指出,这些关停并非毫无征兆——先削减配额,再发布弃用通知,最后文档悄然更改,形成了一套可识别的模式。
剩余选项仍然有用,但运作方式已经不同。作者强调,所有数据均来自各提供商当周的官方页面,由于作者没有创建账号,限额是"文档所述"而非"实测所得"。
目前真正可用的免费选项
OpenCode Xen:零门槛的入门选择
最省事的选择是OpenCode内置的Xen提供商,完全不需要账号。作者在全新安装环境下确认,它轮换提供10到14个免费模型,包括Big Pickle、GLM 5.3 Flash和DeepSeq V4.1 Flash。所有模型均标记为"限时免费",未公布明确限额。
实测中,列出的10个模型全部通过了小型编程任务,仅有一个超时。对于想零成本试用编码代理的人来说,这是门槛最低的路径。
OpenRouter:最大目录,但限额需精打细算
OpenRouter提供了最大的免费模型目录。作者在10月19日记录到471个模型中有17个免费,外加一个免费自动路由器。限额为每分钟20次请求、每天50次。
一个值得注意的机制是:一次性购买10美元额度后,每日上限提升至1000美元额度——即使你已经花掉了这些额度。然而,正如后文将分析的,这个"慷慨"的数字对代理式使用来说并不宽裕。
自动路由器(Auto Router) 是 OpenRouter 提供的一项路由机制:用户无需手动指定具体模型,而是由平台根据请求内容、模型可用性和成本等因素自动选择后端模型。对于免费层级而言,自动路由器通常也会优先调用免费模型池,但其行为不透明——用户无法预知本次请求落到哪个模型、该模型是否处于限流状态。这意味着自动路由器虽然省去了选模型的麻烦,却也把 429 风险转嫁给了平台调度逻辑:一旦其选中的单一主机繁忙,请求同样会失败。因此代理式工作流中,显式指定模型并准备备用方案,往往比依赖自动路由更可控。
Google AI Studio:Gemini的免费通道
Google AI Studio覆盖Gemini Flash、Flashlight、2.5 Pro和Gemma 4。但Google不再公布每个模型的免费限额,作者建议查看自己的仪表盘而非旧数据。需要权衡的是:免费层级的内容会被用于改进Google产品。
Grok:速度快,但令牌上限极紧
Grok文档标注的限制是每分钟30次请求、每天1000次、每个模型每天20万令牌。但关键在于每分钟仅8000令牌,且限额按组织计算——多建几个密钥并无帮助。
其他小型选项
Cloudflare Workers每天提供10000个免费神经元(UTC午夜重置),但神经元与令牌之间没有简单换算关系。用户报告约每分钟40次请求,且会被记录日志。Mistral的实验计划据报告允许约每秒一次请求,请求可能被用于训练。Hugging Face则每月提供10美分额度。
免费层级的"墓地":这些推荐已经过时
作者列出了四个已失效的选项,并警告:如果任何指南或视频推荐它们,无论发布时间多近,都已经过时。
- GitHub Models:整个服务已退役
- Cerebras免费层级:运行至8月17日,被一次性5美元额度取代,需要支付方式且30天后过期
- Gemini CLI免费个人登录:6月18日停止
- QN Code免费托管模型:4月15日关闭
这些工具本身仍然存在且开源,结束的是背后的免费模型。现在两者都需要密钥——Gemini可以搭配免费的AI Studio密钥(仅Flash模型,限额低于旧登录),或指向其他提供商。
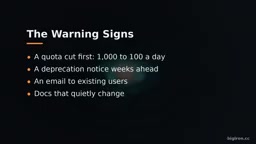
作者总结的关停模式值得记住:先削减配额(QN Code从每天1000次降至100次,然后关闭),提前数周发布弃用通知,向现有用户发送邮件,文档悄然更改。如果依赖的免费层级削减配额或要求绑卡,应在关停通知前就开始迁移。
免费模型目录的"周级"波动
免费列表不仅会消失,还在持续变动。作者在一次性虚拟机上记录了OpenCode的无账号免费列表:UTC 2:04时列出12个免费模型,2:09时变为10个——三个消失,一个新增。随后50分钟内的五次快照完全一致,而前一晚阅读的Zen文档页面列出的是14个。
OpenRouter的变动较慢但方向相同:17个免费模型中最老的3月加入,测试当周新增两个。一位在6月编制免费列表的作者在10月报告,其中无一仍然免费。
由此得出的实践建议很直接:永远不要硬编码免费模型ID,不要围绕某个模型的特性养成习惯,模型重新出现时重新检查数据条款。作者提供了两个无需密钥即可读取当前列表的端点:OpenRouter的公共模型端点(用JQ筛选ID以":free"结尾的模型)和OpenCode的模型列表(筛选其自有提供商)。
代理式使用:为什么"每天50次"远不够用
免费层级宣传两类限制:每分钟速率和每日配额。人们担心速率,但真正卡住的是配额。聊天窗口每条消息一次请求,代理不是。
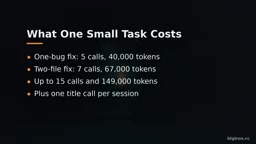
作者统计了OpenCode在10个免费模型上的调用次数:修复一个bug中位数为5次调用、4万输入令牌;两个文件中的两个bug为7次调用、6.7万令牌,最多达15次调用、14.9万令牌。此外OpenCode每个会话还会发起一次小调用生成标题。因此一个小修复约等于6次请求。
即便只是要求模型回复"pong",也消耗了约7700输入令牌——这是每次调用都会发送的代理系统提示和工具定义基线。换句话说,每个代理请求在问题开始前就携带了数千令牌。
将这些数字套入文档限额:OpenRouter每天50次请求约等于6到8个小修复;购买10美元后每天1000次约等于120到160个,除非主机先拒绝。Grok则是令牌先耗尽,每天3到5个修复,且每分钟8000令牌比单次Claude Code请求还小。
这些还都是单文件小任务。真实会话消耗数倍于此,更重的运行框架成本更高:测试虚拟机上Claude Code的首次请求为64.8KB,而OpenCode为31.1KB。提示缓存不节省配额,因为一次请求仍然算一次请求。
429错误:免费模型的真正痛点
关于OpenRouter免费模型最常见的抱怨不是每日上限,而是几乎没怎么用就收到429(请求过多)。一位测试者在9月发现19个免费模型中有4个从测试虚拟机拒绝请求并返回429。
原因在于:OpenRouter上每个免费模型都只有一个主机。作者检查了全部17个。当该主机繁忙时,没有故障转移的余地。前一天的公布正常运行时间从100%到21%不等。因此,把429理解为"该模型不可用",直接切换模型即可。
HTTP 429(Too Many Requests) 是标准的限流状态码,表示客户端在给定时间窗口内发送的请求超过了服务端允许的速率。响应通常附带 Retry-After 头,指示建议的重试等待时间。在 OpenRouter 免费模型的场景中,429 的产生有两种来源:一是用户自身触发了每分钟 20 次的速率限制;二是上游单一主机因全局负载过高而拒绝请求。前者可通过退避重试解决,后者则意味着该模型当前不可用,重试往往无效。区分二者对代理式工作流至关重要:前者应等待,后者应切换模型。许多 SDK 默认对 429 做指数退避重试,在单主机场景下反而会白白耗尽每日配额。
实用策略:如何组合使用免费层级
大多数提供商都支持OpenAI聊天补全API,因此一次请求可以通用:改基础URL、改密钥、改模型即可。作者用故意错误的密钥测试端点——401说明URL正确,404说明错误。OpenCode Zen则完全不需要密钥。
密钥和环境变量应妥善保存,绝不写入提交的脚本。限额存在于实际执行的位置,因此应在那里检查:OpenRouter的速率限制响应头、Grok控制台的页面上限、AI Studio项目、Cloudflare仪表盘。作者建议在信任任何免费层级前,先记录一周的响应头和状态码。
按任务选择工具:想零注册试用编码代理,用OpenCode免费模型;想跨多个模型实验,用OpenRouter(预期429和变动);需要Gemini且接受数据条款,用AI Studio;追求速度,用Grok;涉及隐私或每天都要运行的任务,用本地模型——没有上限、没有变动、没有数据条款。
免费仍然可用,前提是阅读当前列表、在限额被执行的地方核实、并在遇到问题时切换模型而非反复重试。作者同时提醒,名单周周变化,有时在几分钟内就变。
OpenAI 聊天补全 API 兼容性 已成为行业事实标准:大量第三方提供商(OpenRouter、Groq、Mistral、本地 Ollama/vLLM 等)都暴露与 /v1/chat/completions 结构一致的端点,请求体与响应格式基本兼容。这使得“改基础 URL、改密钥、改模型名”即可切换后端,无需重写客户端代码。但兼容并不等于完全一致:各家的错误码语义、限流响应头命名(如 x-ratelimit-remaining-requests 的有无)、流式响应细节、工具调用格式可能存在差异。因此文中建议用错误密钥探测端点(401 表示 URL 正确、404 表示路径错误)并记录一周的响应头,本质上是在验证兼容层的实际行为,而非假设它与会话式 API 完全等价。
背景补充
提示缓存(Prompt Caching) 是多家 LLM 提供商推出的一项优化:当多次请求共享相同的前缀(如系统提示、工具定义、长文档)时,服务端缓存这部分计算结果,后续请求只需处理新增内容,从而降低延迟和计费令牌数。但需要注意,缓存优化的是令牌计费与延迟,并不改变请求次数的统计口径。对于以“每分钟请求数/每天请求数”为限额单位的免费层级,缓存不会让一次代理调用变成半次——代理每发起一轮工具调用、每读取一次文件,仍各算一次请求。这正是文中强调“提示缓存不节省配额”的原因:免费层级的瓶颈在请求次数而非令牌,缓存对此无能为力。
相关推荐

GPT-Image 2.6双版本发布:速度与精度的双重升级
OpenAI发布GPT-Image 2.6,包含Flare和Sunburst两个版本,Flare主打更快生成速度,Sunburst处理复杂提示词与密集信息图。API新增标记编辑、SVG和GIF支持,让图像生成更可迭代、可编辑、可集成。

罗伯特·卡罗:如何让知情人开口,揭开约翰逊金钱政治的隐秘逻辑
普利策奖得主罗伯特·卡罗分享采访约翰·康纳利的经验,揭示如何通过追问约翰逊资金批注细节,让知情人说出本不该说的政治资金运作逻辑。

Sam Altman就RAM言论大转弯:"真让人恼火"
Sam Altman因关于RAM的争议性言论引发社区反弹,随后态度出现180度反转并回应"真让人恼火"。本文梳理事件脉络,分析内存为何成为AI行业的敏感话题,以及高管快速转向背后的公关逻辑与对开发者的实际启示。