MicroSim:对比图神经网络实现二进制代码相似性检测

MicroSim 用微码图与对比孪生 GNN 实现高精度二进制代码相似性检测。
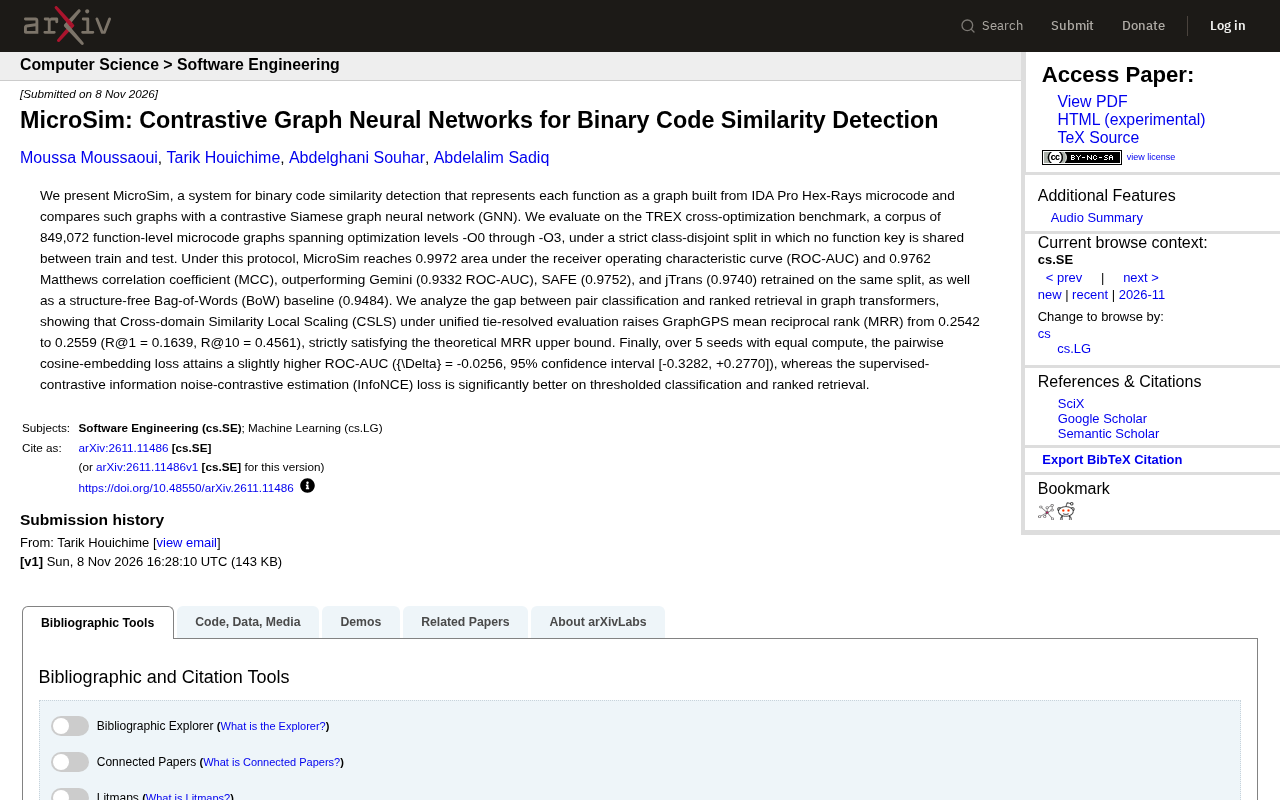
MicroSim 是一种基于对比孪生图神经网络的二进制代码相似性检测系统。它将每个函数通过 IDA Pro Hex-Rays 提取的微码构建为图结构,节点为微码指令,边表示数据流或控制流依赖,从而保留丰富的语义信息并规避原始汇编的复杂性。孪生网络共享权重处理一对函数图,通过对比损失优化嵌入空间。在 TREX 基准的严格类不相交划分下,MicroSim 达到 0.9972 ROC-AUC 和 0.9762 MCC,显著优于 Gemini、SAFE、jTrans 及 Bag-of-Words 基线。论文还分析了排序检索中的性能差距,引入 CSLS 和统一平局处理使 GraphGPS 的 MRR 从 0.2542 提升至 0.2559,并比较了两种损失函数:InfoNCE 在阈值分类和排序检索上显著更优。
引言
二进制代码相似性检测(Binary Code Similarity Detection, BCSD)在漏洞搜索、恶意软件分析、补丁比对等安全场景中扮演着关键角色。传统方法依赖人工特征或简单的统计模型,难以捕捉代码的结构语义。近期,研究者提出 MicroSim,一种基于对比孪生图神经网络(Siamese GNN)的系统,将每个函数表示为从 IDA Pro Hex-Rays 微码构建的图,并通过对比学习进行相似性判断。本文将深入解读 MicroSim 的设计、实验与发现。
核心方法:微码图与对比学习
MicroSim 的核心创新在于将二进制函数转换为微码图,并利用图神经网络学习其嵌入表示。具体而言,每个函数通过 IDA Pro 的 Hex-Rays 反编译器提取微码,构建成图结构,节点代表微码指令,边表示数据流或控制流依赖。这种表示保留了丰富的语义信息,同时避免了直接处理原始汇编的复杂性。
为了有效比较图之间的相似性,MicroSim 采用对比孪生 GNN 架构。孪生网络的两个分支共享权重,分别处理一对函数图,输出嵌入向量,并通过对比损失函数优化:使相似函数的嵌入靠近,不相似函数的嵌入远离。论文中探索了两种损失: pairwise cosine-embedding loss 和 supervised-contrastive InfoNCE loss。
IDA Pro Hex-Rays 微码是 IDA Pro 反编译器在将汇编指令提升为高级类 C 代码之前生成的一种中间表示(IR)。与原始汇编相比,微码将每条指令拆解为更细粒度的操作(如赋值、算术运算、条件跳转、函数调用等),并显式暴露操作数之间的数据依赖关系。这种表示既保留了底层语义(如寄存器与内存访问),又消除了不同编译器、优化级别带来的指令选择差异,因此非常适合作为跨优化场景下的函数表示基础。MicroSim 正是利用微码的这一特性,将每个函数转化为以微码指令为节点、以数据流或控制流依赖为边的图结构。
孪生图神经网络(Siamese GNN) 是一种双分支共享权重的网络架构,两个分支分别接收一个输入图并输出其嵌入向量。由于权重共享,网络对两个输入施加完全相同的映射函数,从而保证嵌入空间中的距离具有可比性。训练时通常配合对比损失:拉近相似样本对的嵌入、推远不相似样本对的嵌入。这种架构天然适合成对相似性判断任务,因为它直接优化“成对比较”的目标,而非独立的分类或回归。MicroSim 将这一架构与微码图结合,使模型能够端到端地学习函数间的结构语义相似度。
实验设置与结果
研究者在 TREX 跨优化基准上评估 MicroSim,该基准包含 849,072 个函数级微码图,覆盖 -O0 到 -O3 优化级别。为确保严谨性,实验采用严格的类不相交划分:训练集和测试集中不共享任何函数键。在这种协议下,MicroSim 达到了 0.9972 的 ROC-AUC 和 0.9762 的 MCC,显著优于多个基线模型:Gemini(0.9332 ROC-AUC)、SAFE(0.9752)、jTrans(0.9740)以及无结构的 Bag-of-Words 基线(0.9484)。这些结果突显了图结构信息与对比学习结合的有效性。
TREX 基准是二进制代码相似性检测领域广泛使用的评测数据集,其函数级微码图覆盖了从 -O0 到 -O3 的多个优化级别,用于检验模型在不同编译优化下的鲁棒性。该基准的关键挑战在于同一源代码函数在不同优化级别下生成的二进制形态差异显著,模型必须学会忽略这些由编译优化引入的噪声。类不相交划分则是一种更严格的评估协议:训练集与测试集中不共享任何函数键(即同一函数的不同编译版本不会同时出现在训练和测试中),从而防止模型通过记忆函数身份而非学习语义相似性来“作弊”。这一协议下的性能更能反映模型在真实未知函数上的泛化能力。
排序检索的深入分析
除了成对分类,论文还分析了图变换器在排序检索任务上的表现。研究发现,成对分类与排序检索之间存在性能差距。通过引入跨域相似度局部缩放(CSLS)和统一的平局处理评估,GraphGPS 的平均倒数排名(MRR)从 0.2542 提升至 0.2559,R@1 达到 0.1639,R@10 为 0.4561。这一提升严格满足理论 MRR 上界。
跨域相似度局部缩放(CSLS) 是一种用于缓解嵌入空间中“枢纽点”(hubness)问题的相似度校正方法。在高维嵌入空间中,某些向量会偶然成为许多查询的最近邻,导致检索结果偏向这些“枢纽”向量。CSLS 通过从原始相似度中减去每个候选向量的平均邻域相似度来进行局部缩放,从而惩罚枢纽点、提升检索的区分度。平均倒数排名(MRR) 是排序检索的常用指标,定义为所有查询的“第一个正确结果排名倒数”的平均值,MRR 越接近 1 表示正确结果排得越靠前;R@k 则表示前 k 个结果中包含正确项的查询比例。这些指标共同刻画了模型在排序检索任务上的实际可用性。
损失函数的比较
在 5 个随机种子和相同计算预算下,pairwise cosine-embedding loss 获得了略高的 ROC-AUC(Δ = -0.0256,95% 置信区间 [-0.3282, +0.2770]),但差异不显著。相比之下,supervised-contrastive InfoNCE loss 在阈值分类和排序检索任务上显著更优。这表明 InfoNCE 损失更适合需要区分决策边界的场景,而 cosine 损失在整体排序上可能略有优势,但需更多实验验证。
结论与展望
MicroSim 通过微码图表示和对比孪生 GNN,在二进制代码相似性检测任务上取得了领先性能。其严格的类不相交评估协议为后续研究树立了标杆。未来工作可探索更高效的图神经网络架构、跨架构泛化能力以及在实际漏洞搜索中的应用。
总之,MicroSim 展示了图神经网络在二进制分析中的潜力,为安全领域提供了新的工具和见解。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。