Microsoft Foundry模型路由器:一次部署智能调度多模型

Microsoft Foundry模型路由器可按任务复杂度自动分配最合适的AI模型,兼顾质量与成本。
Microsoft Foundry的模型路由器(Model Router)旨在解决单一模型难以同时满足速度、成本与推理质量的痛点。它以普通模型端点的形式部署,无需改造现有架构,支持OpenAI、Claude、Grok、Llama、DeepSeek等多家供应商,并提供质量优先、成本优先和平衡三种路由策略。实测表明,轻量的订单代理任务被自动分配给响应极快的GPT-5.6 nano,数学推理题则切换至Grok 4.1 Fast Reasoning,需要事实辨析的问题交给GPT-5.5处理。内置监控面板记录了每次请求的token消耗与路由结果,开发者可据此判断是否需要固定模型或继续依赖动态路由,将模型选型从一次性猜测变为数据驱动的持续优化过程。
从选模型到让模型自己选
在构建AI应用时,开发者往往面临一个两难:为特定任务挑选一个模型,然后不断微调、祈祷它在所有场景下都能胜任。但现实是,单一模型很难同时兼顾速度、成本与推理质量。Microsoft Foundry提供的模型路由器(Model Router)给出了另一种思路——不再让你押注单一模型,而是根据每次请求自动选择最合适的模型。
更重要的是,模型路由器的部署方式与普通模型完全一致。在Foundry的Discover区域进入Model标签页,即可找到并部署它,无需额外的架构改造。这意味着开发者可以像调用一个普通模型端点那样,把智能调度能力接入现有应用。
支持的模型与部署选项
模型路由器覆盖了多家主流供应商的模型,包括OpenAI、Claude、Grok、Llama以及DeepSeek广告。部署时支持全球标准(Global Standard)、标准(Standard)以及数据区域标准(Data Zone Standard)等多种部署类型,开发者需要留意各模型的可用区域限制。
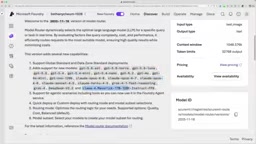
配置的灵活性是这套方案的核心。你可以自定义部署类型,也可以选择路由模式:偏向质量(quality)、偏向成本(cost),或者两者平衡(balanced)。此外,你既可以选择路由到全部模型,也可以只启用其中你信任的几个。
值得关注的一点是,随着大量模型逐步走向弃用(deprecation),模型路由器支持模型更新机制——当有新模型上线时,你可以随时纳入路由池,避免应用因底层模型退役而中断。
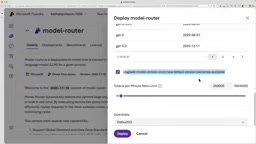
全球标准(Global Standard)、标准(Standard)与数据区域标准(Data Zone Standard)三种部署类型的区别值得说明。全球标准部署将请求动态分发到微软全球数据中心,延迟更低、吞吐量更高,但数据可能跨越地理边界传输;标准部署将模型固定在特定区域,适合对数据驻留有要求的场景;数据区域标准则介于两者之间,数据流转被限制在特定地理分区(如欧盟或美洲)内,兼顾合规与弹性。对于需要满足GDPR或行业监管要求的企业应用,选择正确的部署类型与选择模型本身同等重要。
实测:不同任务如何被自动分流
作者在实测中直接采用了默认配置,一次性部署了全部27个模型,并通过两类场景观察路由行为。
场景一:Cupcake代理
第一个场景是一个持续使用的“蛋糕订购代理”。此前作者一直手动使用GPT-5 mini来处理这类任务。启用平衡模式(兼顾成本与质量)后,当作者尝试下单时,路由器选择了GPT-5.6 nano来响应。多次不同的下单场景下,它依然稳定地选中GPT-5.6 nano。
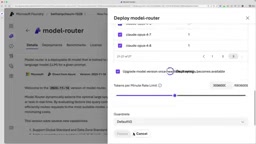
作者认为这个选择相当合理:GPT-5.6 nano响应极快(约两秒),且token消耗表现优秀。基于这一结果,他表示今后处理蛋糕代理这类轻量任务时,可能会直接默认使用GPT-5.6 nano。
场景二:需要推理的通用问题
第二类测试针对更复杂的通用问题。当作者抛出一道需要逐步推理的数学题时,路由器自动切换到了推理型模型——Grok 4.1 Fast Reasoning,让它完成推理后给出答案。
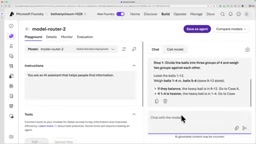
作者还特意设计了一个带有陷阱的问题:询问“内罗毕的首都是哪里”。这类问题需要模型识别出内罗毕本身是一座城市而非国家。路由器将其分配给了GPT-5.5,模型正确指出内罗毕是肯尼亚的首都,而非一个国家。类似地,当问及近期重新变更的首都问题时,它同样路由到GPT-5.5来处理这类需要事实辨析的查询。
监控与持续优化
模型路由器并非“部署即忘”。它提供了监控面板,可以查看token消耗、每次请求的输入输出,以及路由器实际依赖了哪些模型。这些数据能帮助开发者判断:某类任务是否总是被路由到同一个模型?如果是,或许可以直接固定使用该模型;如果路由结果多样,则继续保留路由器让它动态决策。
这种“先用路由器探路、再据数据决策”的方式,实际上把模型选型从一次性的猜测,变成了一个由真实使用数据驱动的持续过程。对于需要在成本与质量之间反复权衡的生产环境来说,这种可观测性尤为关键。
这种基于真实流量反向收敛到固定模型的思路,在工程上被称为"流量驱动的模型选型"(traffic-informed model selection)。其核心逻辑是:在产品早期,需求模式尚不清晰,用路由器收集真实分布数据;当某类请求的路由结果高度集中时,说明任务特征已足够稳定,可以裁撤路由层、直接绑定模型以降低额外延迟和调度成本。反之,若路由结果持续分散,则说明任务本身的复杂度波动较大,路由器的动态决策仍有持续价值。监控面板因此不只是运维工具,更是指导架构演进的数据来源。
小结
模型路由器解决的是一个越来越普遍的工程问题:当可用模型数量爆炸式增长、且各有所长时,如何为每次请求选对模型。它通过统一的部署方式、多供应商支持、可配置的路由策略以及完善的监控能力,把这一决策自动化。对开发者而言,最实际的建议或许就是作者的那句话——去部署它,用不同的问题、场景和任务去测试,看看它究竟会为你选择哪个模型。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。