MID:医学图像分割的无配对分布级评估新指标

MID 提出分布级分割评估指标,无需逐样本配对即可衡量预测整体是否忠实还原标注分布。
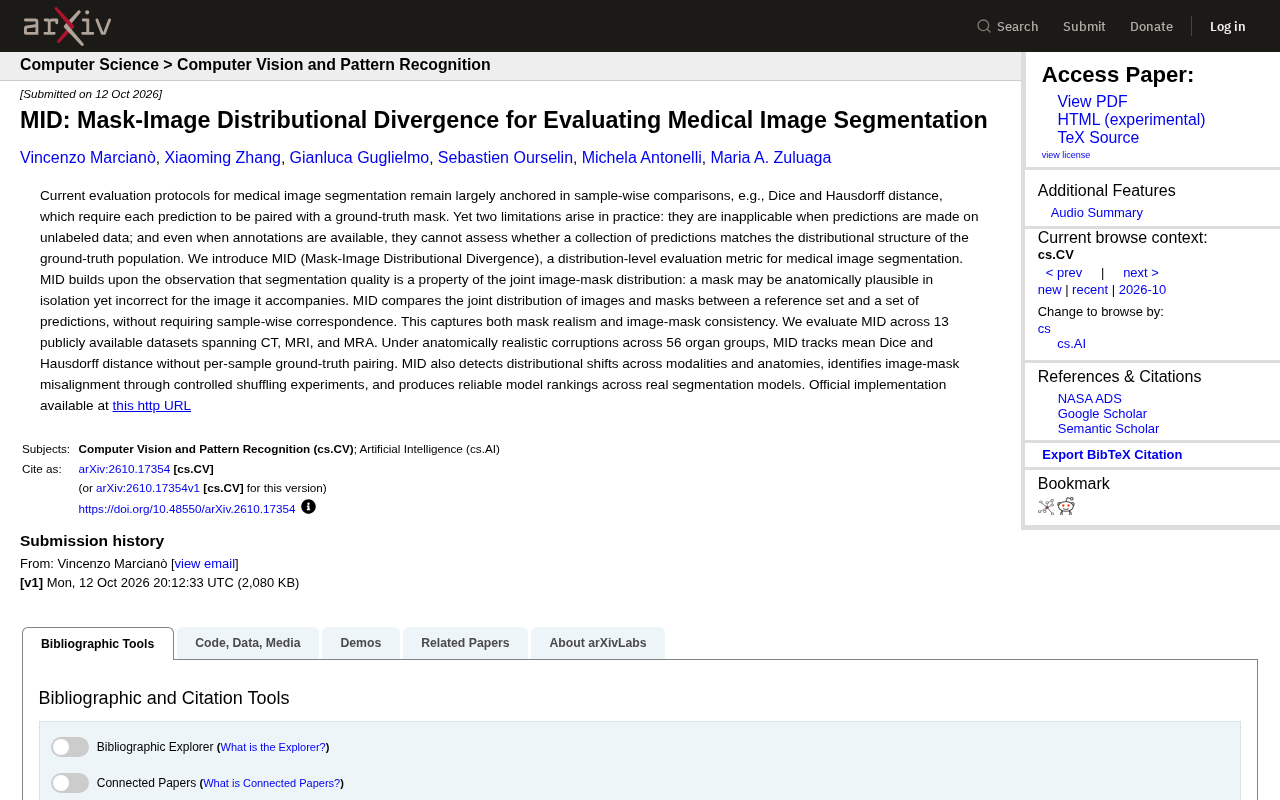
医学图像分割的评估长期依赖 Dice 和 Hausdorff 等逐样本指标,它们要求每张预测掩码都有对应的真实标注配对,在无标注的临床部署场景中直接失效,且无法回答"整批预测是否在分布层面忠实还原真实标注结构"这一宏观问题。Caravel 实验室提出的 MID(Mask-Image Distributional Divergence)直接比较参考集与预测集两个图像-掩码联合分布,无需样本级对应,同时捕获掩码真实性与图像-掩码一致性。研究者在 13 个公开数据集(CT/MRI/MRA)、56 个器官组上验证了 MID 能追踪 Dice 与 Hausdorff 趋势、检测跨模态分布漂移、识别图像-掩码错位并产出可靠的模型排名。官方实现已开源,为标注稀缺的医学影像团队提供了新的评估思路。
当 Dice 不够用时:医学图像分割评估的盲区
医学图像分割的评估长期依赖 Dice 系数和 Hausdorff 距离这类逐样本比较方法。它们要求每一张预测掩码都能与一张人工标注的 ground-truth 一一配对。这个前提在实验室里成立,在真实场景中却经常站不住脚。
一方面,当模型被部署到未标注数据上(这在临床上极为常见),逐样本指标直接失效——没有标注,就无从计算 Dice。另一方面,即便标注可用,逐样本指标也只能告诉你"这一张预测和这一张标注有多像",却无法回答一个更宏观的问题:这一整批预测,是否在分布层面忠实还原了真实标注群体的结构?
来自 Caravel 实验室的研究者提出了 MID(Mask-Image Distributional Divergence),一个面向医学图像分割的分布级评估指标,试图填补这一空白。官方实现已开源于 github.com/erc-caravel/pytorch-mid。
Dice 系数(Dice Similarity Coefficient) 衡量的是预测掩码与真实标注之间的重叠程度,取值 0 到 1,公式为两倍交集除以两者像素(或体素)总数之和。它对大面积区域的重叠敏感,但在小目标或边界区域上容易给出偏乐观的分数。Hausdorff 距离 则取预测边界点集与真实边界点集之间的最大最近距离,对边界最坏情况极其敏感,常用于捕捉形状偏差和离群点。两者都属于逐样本(per-sample)指标:必须先有"这张图对应这张标注"的配对,才能计算。它们的共同局限是把每个样本独立看待,无法刻画一个预测集合整体的分布特性,也无法在无标注数据上直接计算。
核心洞察:分割质量是联合分布的性质
MID 的出发点是一句看似朴素却常被忽略的判断:分割质量是图像-掩码联合分布的性质。
一张掩码单独来看可能解剖学上完全合理——器官形状自然、边界光滑、没有明显伪影——但如果它对应的不是那张图像,它就是错的。传统的逐样本指标在配对存在时能捕捉这种错位,但它的视野被限制在单个样本内,无法度量"整体预测集合"与"真实标注集合"之间的分布差距。
MID 的做法是:直接比较参考集(真实图像-掩码对)和预测集(图像-预测掩码对)两个联合分布,完全不要求样本级对应关系。这使它同时捕获两个维度的信息——掩码本身的真实性(realism),以及图像与掩码之间的一致性(consistency)。换句话说,MID 既惩罚"长得不像器官的掩码",也惩罚"长得像器官但配错了图的掩码"。
联合分布(joint distribution) 描述的是两个随机变量同时取值的概率结构,这里指"图像 X"与"掩码 Y"作为一对共同出现的分布 P(X, Y)。逐样本指标实际上是在给定配对 (x, y) 的条件下比较预测 ŷ 与 y,属于条件层面的度量;而 MID 比较的是参考集的 P_ref(X, Y) 与预测集的 P_pred(X, ŷ) 两个联合分布之间的差异。这意味着 MID 不关心"第 i 张预测是否对应第 i 张标注",只关心两批 (图像, 掩码) 对的整体统计结构是否一致。正是这个视角的转换,使 MID 能同时惩罚掩码不真实(Y 的边缘分布偏离)和图像-掩码不匹配(X 与 Y 的依赖关系被破坏)。
13 个数据集上的系统验证
研究者在 13 个公开数据集上评估了 MID,覆盖 CT、MRI 和 MRA 三种模态。验证设计围绕几个关键问题展开:
追踪能力。 在跨 56 个器官组施加解剖学上合理的扰动(corruption)后,MID 能够在不使用逐样本 ground-truth 配对的前提下,跟踪 mean Dice 和 Hausdorff 距离的变化趋势。这意味着 MID 在无标注场景下可以作为传统指标的代理。
分布漂移检测。 MID 能识别不同模态之间、不同解剖结构之间的分布偏移(distributional shift),这是逐样本指标难以系统刻画的能力。
图像-掩码错位识别。 通过受控的 shuffling 实验(将图像与掩码随机打乱配对),MID 成功检测出图像-掩码错位。这直接验证了它对"联合分布一致性"的敏感度。
模型排名可靠性。 在真实的多个分割模型上,MID 产出的模型排名是可靠的,说明它不仅是一个诊断工具,也能用于模型选择。
分布漂移(distributional shift) 指测试数据或部署数据的分布与训练/参考分布不一致,在医学影像中常表现为扫描仪型号、成像协议、患者群体或解剖结构差异。逐样本指标在存在配对时仍可计算,但不能系统性地刻画"整体偏移了多少"。MID 通过直接度量两个联合分布的距离,天然对这类偏移敏感——即便每个样本的 Dice 尚可,只要预测集合的整体分布偏离参考分布,MID 就会给出警示。shuffling 实验 则是把图像与掩码随机重新配对,构造出"掩码本身真实但与图像无关"的受控场景,用来检验指标能否识别出这种联合一致性被破坏的情况,是验证分布级指标敏感度的常用手段。
为什么这对医学图像分割很重要
医学图像分割的落地场景往往是这样的:模型在一个标注数据集上训练完成,然后被推到大量未标注的临床数据上运行。此时团队最想知道的是——这批预测整体上靠不靠谱?有没有系统性的偏移?
Dice 和 Hausdorff 在这种场景下帮不上忙。MID 提供的思路是把评估从"逐张比对"提升到"分布比对":你不需要知道每张图对应的正确答案,只需要判断整批预测的联合分布是否与参考分布一致。这对于标注稀缺的医学领域尤其有价值——标注成本高、专家资源有限,而无标注数据唾手可得。
另一个值得注意的角度是 MID 对"解剖合理性陷阱"的处理。一个分割模型完全可能生成看起来很像器官的掩码,但在特定图像上位置偏移或形状失配。逐样本 Dice 在配对存在时能发现这种错误,但在分布评估中,如果只看掩码边缘的光滑度或形状统计,就很容易被骗过。MID 通过联合分布比较堵住了这个漏洞。
局限与后续方向
MID 目前验证的数据集以 CT、MRI、MRA 为主,是否适用于超声、病理切片等其他医学影像模态,论文未做说明。此外,分布级指标对参考集的代表性和规模有隐含依赖——参考分布本身如果有偏,评估结论也会随之偏移。这些都是实际应用中需要留意的边界条件。
开源实现放在 github.com/erc-caravel/pytorch-mid,对医学影像 AI 团队来说,值得在评估流水线中试一试。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。