Milliseconds.ai:一个API搞定文本与图像的实时AI决策

Milliseconds.ai推出专注快速决策的小型API模型,以极低成本覆盖分类与结构化提取场景。
Milliseconds.ai选择了一条与主流生成式大模型截然不同的路径:其核心产品`decision-machine-1`专注于毫秒级决策输出,通过统一API接收文本和图像,返回标签、分类及结构化字段,而非自然语言回复。定价极为激进,每百万输入token仅0.04美元且输出免费,每月还提供1.25亿免费额度供开发者测试。典型应用场景包括邮件路由、发票数据提取和退货政策判断——这些高频、规则化任务用通用大模型处理代价高昂。该产品代表了AI应用层的一种细分趋势:专用轻量模型正在以更低延迟和成本,填补通用大模型"过度服务"所留下的市场空间,但其准确率和稳定性仍有待实际数据验证。
从生成到决策:AI推理的另一条赛道
当行业目光都聚焦在大模型的对话与内容生成能力上时,Milliseconds.ai 选择了一条截然不同的路径——专注于快速决策。它的核心产品是一个名为 decision-machine-1 的小型模型,通过一个统一的 API 接收文本和图像输入,输出标签、分类、结构化字段和决策结果。
这种定位背后有着清晰的产品逻辑。对于大量真实业务场景来说,企业需要的并不是一段流畅的自然语言回复,而是一个明确、可执行的判断:这封邮件应该路由到哪个部门?这张发票上的关键字段是什么?这笔退货是否符合退款政策?这些任务本质上是分类与结构化提取,用大型生成式模型来处理往往是杀鸡用牛刀,既慢又贵。
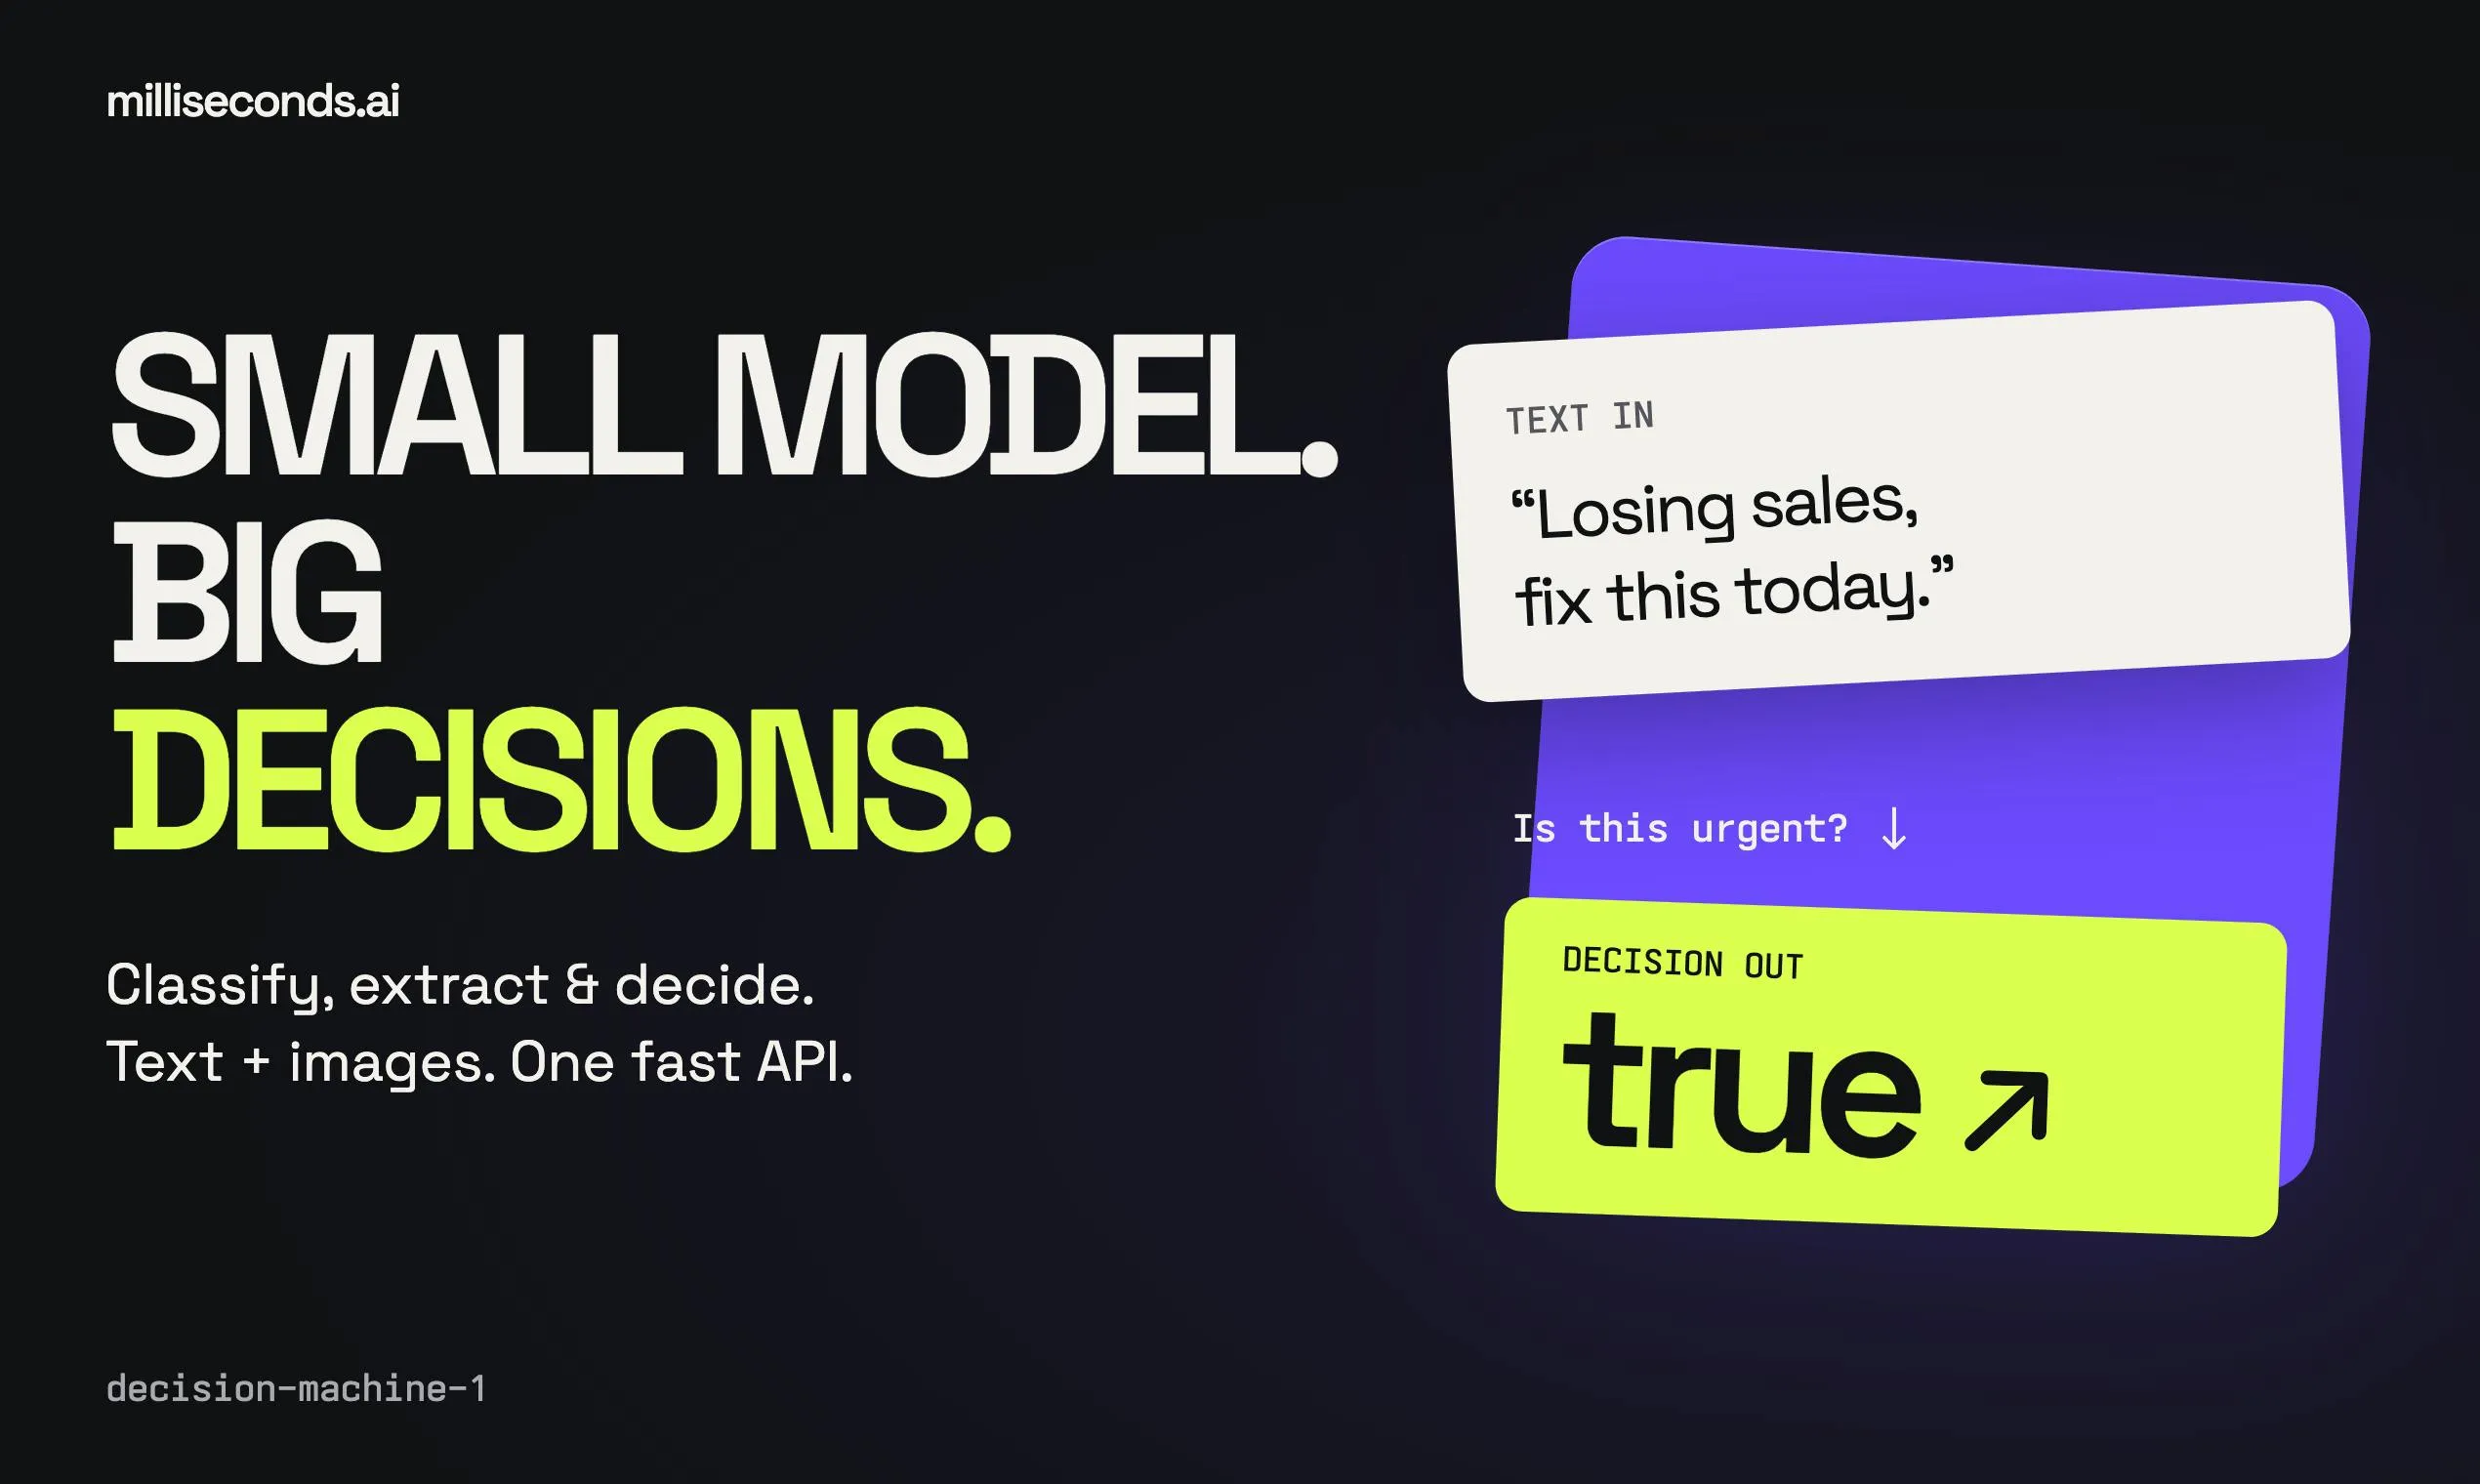
小模型的性能与成本优势
Milliseconds.ai 从产品名称就点明了它的核心卖点——毫秒级响应。低延迟对于需要实时处理的业务流至关重要,比如邮件自动路由、发票数据实时提取、退货政策自动应用等场景,响应速度直接影响用户体验和业务吞吐量。
价格策略同样激进。官方公布的定价为每百万输入 token 仅 0.04 美元,输出 token 完全免费。相比主流生成式大模型动辄数美元的 token 成本,这个价格几乎可以忽略不计。对于需要大规模、高频次调用 AI 判断能力的应用而言,成本结构的差异可能直接决定一个产品能否规模化落地。
更值得关注的是它的免费额度:测试密钥每月提供 1.25 亿个免费输入 token。这个数字对于开发者验证想法、构建原型来说相当慷慨,大幅降低了尝试门槛。
一个API覆盖的典型场景
官方在介绍中列举了几类应用方向,很能说明产品的定位:
- 邮件路由:根据内容自动将邮件分发到对应处理流程
- 发票数据提取:从图像或文本中抽取结构化的财务字段
- 退货政策判断:依据规则自动决定是否符合退款条件
- 图像识别:官方半开玩笑地提到「构建你的热狗识别帝国」,暗示图像分类同样是核心能力之一
这些场景的共同点在于——都是高频、规则化、需要快速给出确定性结果的决策任务,而非开放式生成。
从技术架构角度理解这一价格差异,有助于判断其可持续性。传统大型语言模型(如GPT-4级别)参数量通常在千亿规模,推理时需要多张高端GPU协同计算,单次请求的算力成本较高。而专注于分类与结构化提取的小型模型,参数量可以压缩到数亿甚至更小,配合蒸馏(Knowledge Distillation)和量化(Quantization)等技术,可以在单张普通GPU上实现高并发推理。决策类任务的另一个特点是输出极短——一个标签、一个JSON对象——这意味着生成阶段的计算量远小于对话式模型,这也解释了为何输出token可以免费:其边际成本几乎可以忽略。这种「任务专用化 + 架构精简」的组合,是小模型在延迟和成本上能够碾压通用大模型的根本原因。
面向开发者的定位
Milliseconds.ai 在 Product Hunt 上被归类为 API、开发者工具和人工智能三个类别,上线后获得了 89 票支持并进入当日排名第 14 位。这个成绩反映出开发者社区对「专用小模型 + 统一 API」这一形态的兴趣。
对开发者而言,产品的吸引力在于它把复杂的模型部署和推理优化封装成了一次 API 调用。你不需要自己训练分类模型,不需要处理图像与文本的多模态接入,也不需要为推理性能反复调优——文本和图像输入,结构化决策输出,一切通过单一接口完成。
值得思考的行业信号
Milliseconds.ai 的出现,某种程度上代表了 AI 应用层的一种细分趋势:并非所有任务都需要通用大模型。在生成式 AI 的热潮之外,专门为决策、分类、提取这类高频结构化任务打造的轻量级模型,正在找到自己的市场空间。
它们用更低的延迟、更低的成本,去覆盖那些被通用大模型「过度服务」的场景。对于构建实际业务系统的团队来说,这类工具的价值可能比想象中更实在——毕竟在生产环境里,稳定、便宜、够快,往往比「更聪明」更重要。
不过需要提醒的是,作为一款刚在 Product Hunt 亮相的新产品,其模型的准确率、在复杂任务上的表现、以及规模化使用时的稳定性,仍有待更多实际使用数据来验证。慷慨的免费额度倒是给了开发者一个低风险试水的机会。
这一趋势在学术界有对应的理论支撑。研究表明,对于边界清晰的判别性任务(Discriminative Tasks),经过针对性微调的小模型在准确率上往往能追平甚至超越参数量大十倍以上的通用模型,同时推理速度和成本优势显著。这类模型的局限性也同样明确:一旦任务边界模糊、需要跨领域推理或处理未见过的边缘情况,其泛化能力会迅速下降。因此,选择专用小模型的前提是业务场景足够稳定、标签空间相对封闭。对于决策逻辑频繁变化或需要处理大量长尾异常的场景,通用大模型的灵活性仍然难以替代。这也意味着两类模型在实际生产系统中更可能是互补关系,而非零和竞争。
相关推荐

Devin年收入逼近10亿美元:AI编程热潮背后的真实账本
Cognition旗下Devin AI编程智能体年化收入逼近10亿美元,四个月翻倍,估值达480亿美元。本文解析AI编程热潮背后的真实收入、53倍估值倍数、8亿美元现金消耗与企业客户版图。
n8n实战:从零搭建你的第一个AI Agent工作流
基于n8n in 100 days系列第14集实操,详解如何用n8n搭建第一个AI Agent:从When chat message received触发节点、AI Agent与Chat Model,到Memory记忆模块的作用与设计逻辑。

Aleph Alpha开放Kolibri 78B在线免费试用
Aleph Alpha旗下780亿参数大模型Kolibri 78B现已开放免费在线试用,用户无需部署即可通过网页体验这款欧洲本土AI模型的对话能力。