Mini-AGI:8GB显存从零训练的动态持续学习模型
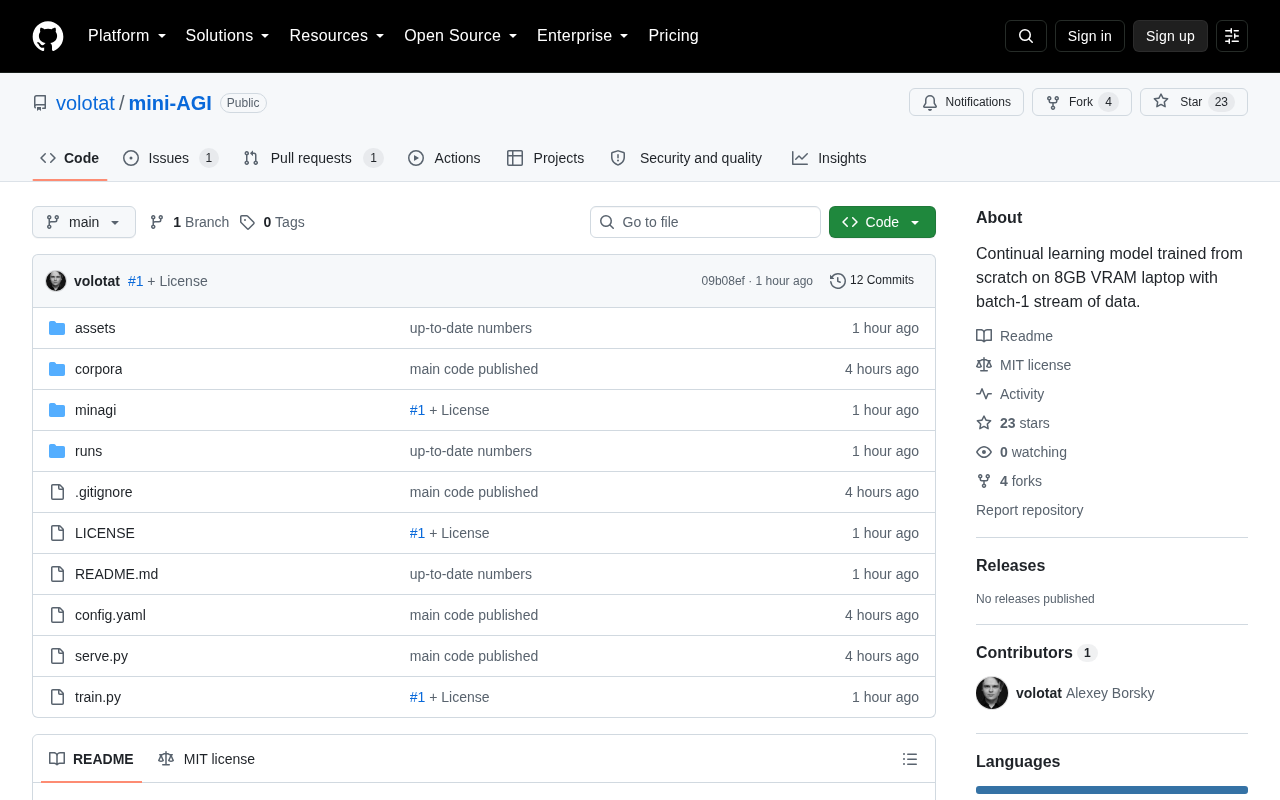
Mini-AGI 尝试在8GB显存消费级GPU上从零训练具备持续学习能力的模型,降低训练门槛。
Mini-AGI 是一个定位明确的开源实验项目,核心目标是在8GB显存的消费级GPU上从零训练一个具备动态持续学习能力的模型。它试图同时解决当前大模型生态的两大痛点:训练门槛过高,以及模型缺乏部署后持续学习的能力。「动态持续学习」的关键挑战在于对抗灾难性遗忘——神经网络在学习新任务时容易覆盖旧知识。项目命名中的「AGI」带有一定营销色彩,应理解为对持续学习这一AGI关键特征的方向性探索,而非宣称实现了通用人工智能。目前该项目社区讨论有限,缺乏公开基准与技术细节,建议理性关注,将其视为有潜力的实验性工作。
一个面向消费级硬件的持续学习实验
近日,一个名为 Mini-AGI 的开源项目在 Hacker News 上引起了小范围讨论。项目定位十分明确:从零开始(trained from scratch),在仅有 8GB 显存的消费级 GPU 上训练一个具备**动态持续学习(dynamic continual learning)**能力的模型。
这个方向之所以值得关注,在于它触及了当前大模型生态中两个长期存在的痛点——训练门槛过高,以及模型缺乏在部署后继续学习的能力。绝大多数主流模型的训练需要动辄数十到数百张高端 GPU,而 8GB 显存是许多游戏本和入门级独显的配置。若能在这样的硬件上完成从零训练,本身就具有相当的探索价值。
什么是动态持续学习
持续学习(Continual Learning),也常被称为终身学习(Lifelong Learning),指模型能够在不断接收新数据的过程中持续更新,而不需要每次都从头重训整个模型。它试图解决的核心难题是灾难性遗忘(Catastrophic Forgetting)——即神经网络在学习新任务时,往往会大幅遗忘此前学到的知识。
与传统训练范式的区别
当前主流的大模型采用的是「预训练 + 微调」的静态范式:模型在一个固定的大规模数据集上完成训练后,参数基本冻结,后续更新需要重新组织数据并进行新一轮训练。而「动态持续学习」强调的是模型在运行过程中就能持续吸收新信息、动态调整自身,更接近人类学习的方式。
从项目命名中的「dynamic」一词可以推测,Mini-AGI 试图在架构或训练机制层面引入某种动态更新能力,让模型不必被固定在一次性训练的结果上。这也是它区别于常规小模型项目的关键卖点。
灾难性遗忘问题在神经网络中由来已久。其根本原因在于,神经网络通过梯度下降更新权重时,新任务的梯度会直接覆盖旧任务所形成的权重分布,导致旧知识被「冲刷」掉。目前学界应对这一问题的主流方法大致分为三类:参数隔离法(为不同任务分配不同的网络子集,如Progressive Neural Networks);正则化约束法(对重要参数施加更新惩罚,如EWC弹性权重巩固算法);以及经验回放法(维护一个小规模历史数据缓冲区,在学习新任务时混入旧数据一并训练)。每种方法都在「稳定性」与「可塑性」之间做出不同的权衡——过于保守则无法有效学习新知识,过于激进则旧知识快速流失。这也是评估 Mini-AGI 持续学习方案是否可行的核心技术维度。
8GB 显存的意义
把训练门槛压到 8GB 显存,意味着这个项目更多面向研究者、学生和独立开发者,而非追求 SOTA 性能的工业级应用。它的价值不在于跑分,而在于可复现、可实验、可教学。
对于想理解模型训练全流程的人来说,能在自己的机器上完整跑一遍「从零训练」的过程,其学习意义远超调用现成 API。这类项目通常会在模型规模、上下文长度、批大小等方面做出取舍,以适配有限的显存预算。
需要理性看待的是,「Mini-AGI」这个名字带有一定的营销色彩。AGI(通用人工智能)是一个宏大且尚未实现的目标,一个 8GB 显存训练的小模型显然与真正意义上的 AGI 相去甚远。这里的命名更应理解为对「具备持续学习这一 AGI 关键特征」的探索方向的一种表达。
在显存预算极为有限的情况下,从零训练一个语言模型通常依赖若干工程技巧来压缩内存占用。常见手段包括:混合精度训练(使用 FP16 或 BF16 代替 FP32,显存占用减半)、梯度检查点(Gradient Checkpointing,以重新计算换空间,可降低约 60-70% 的激活内存)、梯度累积(用多次小批次模拟大批次训练以稳定收敛),以及选用参数量较小的模型架构(通常在 1亿至5亿参数量级)。8GB 显存在这一语境下意味着模型规模和上下文长度都会受到严格约束,但对于验证持续学习算法的可行性而言已经足够,毕竟算法正确性的验证不依赖模型必须达到特定的性能基线。
当前的信息局限与观察建议
截至目前,该项目在 Hacker News 上仅有 5 个点赞和 1 条评论,社区讨论尚不充分,也缺乏公开的性能基准、技术论文或详细的架构说明。因此,对它的实际效果和技术深度还无法给出可靠评价。
对感兴趣的开发者,建议从以下几个角度审慎观察:
- 持续学习的实现方式:是采用参数隔离、正则化约束,还是回放(replay)机制来对抗灾难性遗忘。
- 可复现性:训练脚本、数据配方、依赖环境是否完整开源。
- 实际效果验证:在持续接收新数据后,模型对旧知识的保持率如何。
- 规模与能力边界:8GB 约束下模型能达到的实际能力上限。
小结
Mini-AGI 代表了一类值得鼓励的探索——降低训练门槛、让持续学习在个人硬件上可实验。它的核心看点是「动态持续学习」与「消费级显存从零训练」的结合,而非其略显夸张的项目命名。在缺乏更多技术细节和社区验证之前,建议将其视为一个有潜力的实验性项目,保持关注但不宜过高预期。
相关推荐
实测 GPT-6 Astra 智能体:一句提示词自主完成广告与纠错
实测 GPT-6 Astra 智能体在 Higgsfield 上仅凭一句提示词自主完成广告制作、自我审片纠错、保存技能并诚实开账单,深度解析其计算机操作能力、真实成本与人类角色的变化。
GPT-6 Astra实测:4个提示词造出3A级游戏与3D场景
OpenAI 发布代号 Astra 的 GPT-6,一位开发者实测:4 个提示词做出《使命召唤》级游戏、16 分钟生成桌面应用、PDF 一键转 3D 场景。本文梳理其在 Codex 中的真实表现、自测能力与 Mac Mini 远程方案,并给出冷静解读。
GPT-6 Astra启示:AI工作流从提示词转向系统思维
GPT-6 Astra发布伴随ChatGPT、Claude、Grok连锁宕机引发热议。本文分析Astra带来的端到端工作方式转变:AI从提示词对象变为需管理的对象,创作者的核心技能正从提示工程转向方向感、系统思维与判断力。