MiniMax 3 视频参考替换实战:精准提示词教程
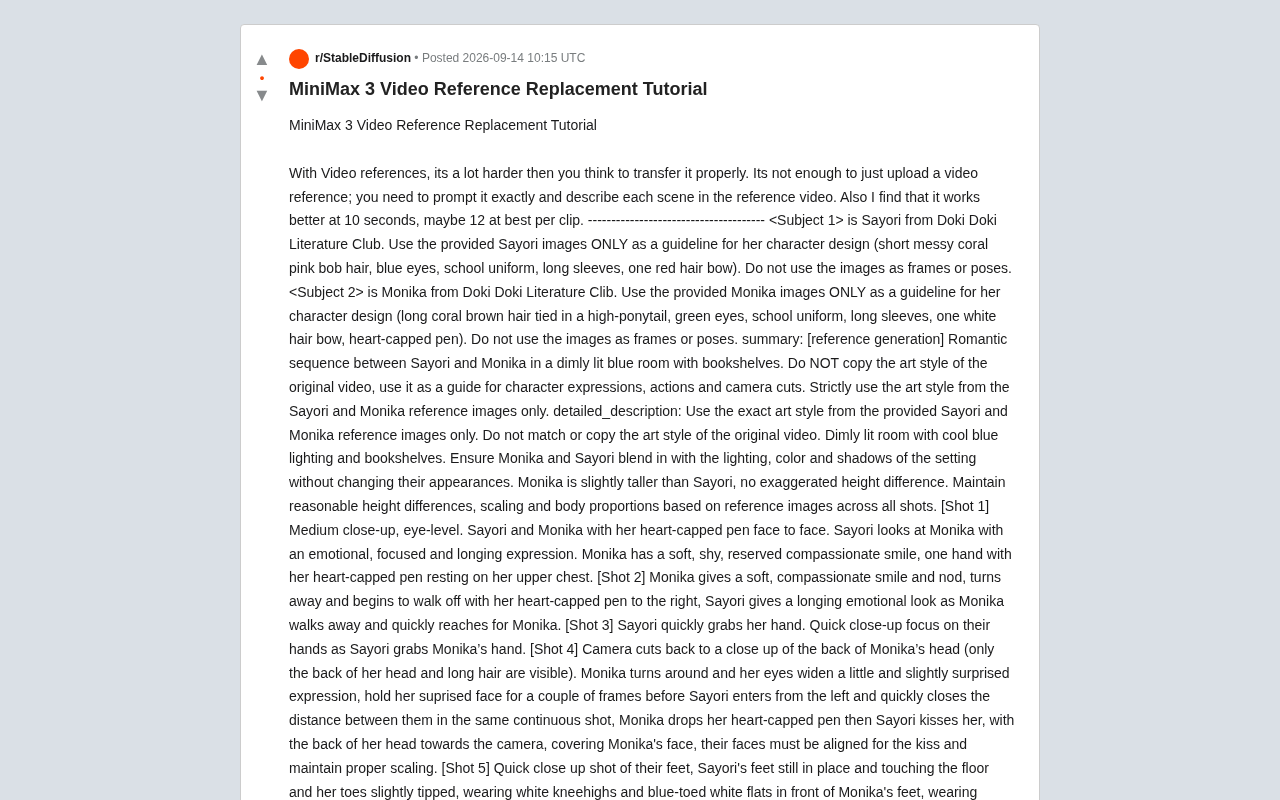
MiniMax H3视频参考功能需配合精确分镜脚本才能实现动作迁移与风格保留的有效分离。
本文基于一位Reddit用户的实战经验,系统拆解了如何正确使用MiniMax H3(MiniMax 3)的视频参考替换功能。核心结论是:仅上传参考视频并不足够,模型不会自动区分需要「迁移」的动作信息和需要「保留」的视觉风格,用户必须通过精确的提示词结构主动划定边界。有效的方法包括:用标签式角色定义锚定外观、在摘要层明确风格归属(参考视频提供运动、参考图提供视觉风格)、按Shot-by-Shot结构逐镜头描述机位与物理细节,以及大量使用否定指令堵住模型偏离方向。视频时长建议控制在10秒左右,最多不超过12秒。
视频参考(Video Reference)功能听起来简单——上传一段参考视频,让模型照着生成即可。但实际操作过 MiniMax 3(也称 Minimax H3)的用户会发现,真正把参考视频里的动作、镜头切换准确迁移到新角色上,比想象中难得多。一位 Reddit 用户分享了完整的实战流程,核心结论只有一句话:光上传参考视频远远不够,你必须像写分镜脚本一样把每一个场景描述清楚。
视频参考替换的核心难点
很多人对视频参考功能的期待是「一键换脸/换角色」,但现实是模型并不会自动理解你想要保留什么、替换什么。原作者指出,如果只是上传一段参考视频,模型很容易把参考视频的画面直接当作帧或姿势来复制,甚至连原视频的美术风格一起搬过来。
要避免这种情况,关键在于给模型明确的边界指令。作者在提示词中反复强调两点:一是「仅将参考图像作为角色设计的指引」(Use the provided images ONLY as a guideline for character design),二是「不要将图像当作帧或姿势」(Do not use the images as frames or poses)。这种限定性表述,本质上是在告诉模型「学动作、别抄画面」。
另一个实用经验是时长控制。作者明确表示,视频参考替换在 10 秒左右效果最好,最多 12 秒。超过这个长度,动作连贯性和角色一致性都会明显下降。这与目前主流视频生成模型在长片段上普遍存在的漂移问题一致。
这种「风格污染」现象背后有技术层面的原因。当前主流视频生成模型(包括 MiniMax H3)通常通过注意力机制同时处理参考帧的外观特征和运动特征,模型并不像人类导演那样天然地区分「我要借鉴这个动作」和「我要保留自己的画风」。参考视频的颜色调色板、笔触风格乃至构图习惯都可能以隐式方式渗入输出结果。因此,所谓「风格指令」本质上是在用语言对注意力权重施加软约束——告诉模型优先从角色参考图而非运动参考视频中汲取视觉风格信息。这也解释了为什么否定指令(Do NOT copy the art style)往往比正向描述更有效:明确排除某类特征,比笼统要求「保持风格一致」给模型更清晰的优化方向。
提示词结构:像分镜脚本一样拆解
这份教程最有价值的部分,是它展示了一套可复用的提示词组织结构。作者把整个提示词拆成了几个清晰的层级:
角色定义(Subject 定义)
开头先用 <Subject 1>、<Subject 2> 的方式为每个角色建立标签,并逐条列出外观特征。例如角色一的描述精确到「凌乱的珊瑚粉色波波头、蓝眼睛、校服、长袖、一个红色发结」。这种颗粒度极细的外观锚定,是保证角色跨镜头一致性的基础。
场景总述与风格约束
在 summary 部分,作者给出整体场景(昏暗蓝光房间、书架背景)和一条至关重要的风格指令:不要复制原视频的美术风格,只把它当作角色表情、动作和镜头切换的参考,严格使用参考图像的美术风格。
这一步是「动作迁移」与「风格保留」分离的关键。视频参考提供的是运动信息(表情、动作、运镜),而角色参考图提供的是视觉风格。把两者的职责分清楚,才能避免风格污染。
逐镜头(Shot-by-Shot)描述
真正体现专业度的是 detailed_description 中的分镜拆解。作者把 10 秒左右的片段拆成了 7 个镜头(Shot 1 到 Shot 7),每个镜头都标注了:
- 景别与机位(如「中近景,平视」「脚部特写」「背面头部特写」)
- 角色的具体动作与表情变化
- 连续镜头(continuous shot)的衔接要求
- 道具与物理细节(如笔落地、脚步后退的时机)
值得学习的是他对物理连贯性的把控,例如明确要求「只有那支笔掉落」「脚步在第一帧后退、随即落地」,甚至规定了两个角色的身高比例和身体比例要「基于参考图像在所有镜头中保持合理」。这种精确到帧的描述,正是让模型输出可控的核心。
将长片段拆成逐镜头描述,还有一个关键的工程原因:视频生成模型在处理较长序列时存在「时序漂移」(temporal drift)问题——随着生成帧数的增加,模型对早期提示词的遵循程度会逐渐衰减,角色外貌和场景细节可能悄悄偏移。逐镜头结构相当于在时间轴上设置多个「锚点」,每个镜头切换都是一次对提示词的重新激活,使模型在整个片段中持续受到描述约束。这也是作者在片段末尾再次复述角色外观的内在逻辑——用显式的文本锚定对抗末尾帧的漂移倾向。
一致性控制的实用技巧
综合这份教程,可以提炼出几条保持角色一致性的通用做法:
首尾呼应的外观复述。 作者在最后一个镜头再次完整复述了两个角色的外观特征(发型、发结、校服、鞋子颜色),以此在片段结尾强化角色识别度,防止长片段末尾出现角色漂移。
环境融合而不改变外观。 提示词要求角色「在光线、色彩和阴影上融入场景,但不改变其外观」。这是一种在写实光照与角色 ID 一致性之间取得平衡的思路。
明确否定项。 大量使用「Do NOT copy...」「Do not use...」这类否定指令,主动堵住模型可能走偏的方向,比单纯的正向描述更有效。
本地部署与云端平台
作者提到这段成片是在 Kinovi AI 平台上生成的,但强调「任何 Minimax H3 都同样适用」。对于没有强力显卡或缺乏技术背景的用户,云端平台是一个可行的替代方案,且据作者说其内容尺度与本地运行相当。
需要提醒的是,以上仅为单一 Reddit 来源的经验分享,具体效果会因平台实现、模型版本和参数设置而异。这份教程的真正价值不在于示例本身,而在于它揭示的方法论:视频参考生成的质量,取决于你能把分镜脚本写得多精确。 与其把它当成一键工具,不如把它当成一个需要详细导演脚本的执行引擎。
相关推荐
涵洞失效的隐性风险:被忽视的基础设施安全隐患
涵洞是深埋于道路下方的隐性排水结构,其失效可能导致路基掏空、局部洪水乃至致命事故。本文梳理涵洞的重要性、失效风险及被忽视的基础设施维护困境。
OzBrain:让每个AI智能体共享同一份知识库
OzBrain 是一款面向多AI智能体时代的共享知识库产品,让每个AI智能体与团队成员读写同一个「大脑」。支持数据加密、不用于训练、可导出Markdown随时离开,解决AI工具间的知识孤岛问题。
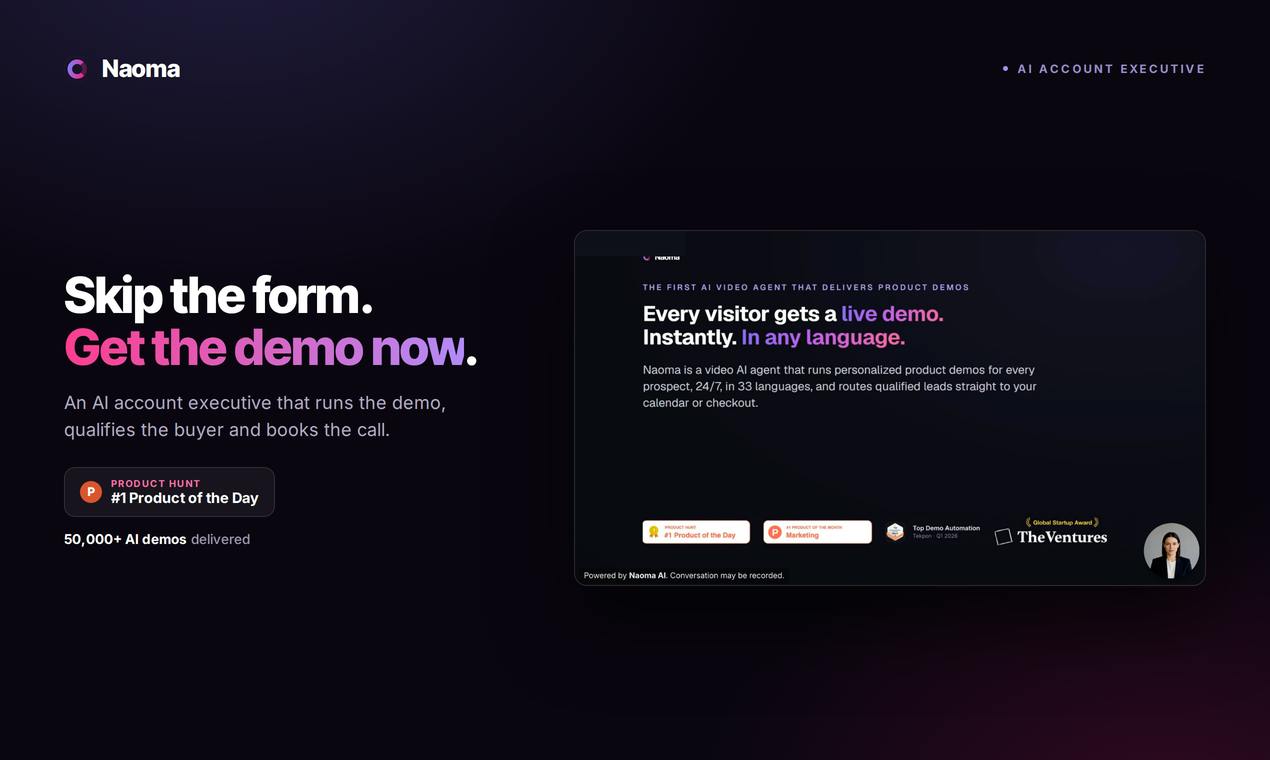
Naoma AI Demo Agent V2:用AI销售把网站流量变成成交会议
Naoma AI Demo Agent V2 用AI销售代表替代传统预约表单,实时为访客演示产品、筛选线索并预约会议,已运行5万+演示并开放自助试用。解析这款登顶Product Hunt的销售自动化工具。