MiniMax H3长视频工作流实测:6G显存跑2分钟高清动画
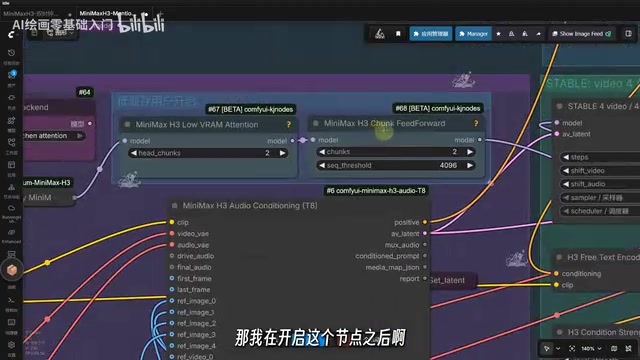
基于ComfyUI的MiniMax H3分段接续工作流,让低显存用户也能本地生成30秒以上长视频。
这套ComfyUI工作流针对MiniMax H3视频生成模型单次约15秒的时长上限,通过「分段接续」而非强行拉长的方式突破天花板,最终可生成30-40秒的连贯长视频。核心机制是Motion Context模块:它继承上一段结尾约1秒的模型内部隐空间状态,而非仅传递末帧像素,从而保证段间运动方向、镜头速度、音画节奏的真正连续。针对低显存用户,工作流引入分块处理节点,块数越多显存需求越低,使6G/8G/12G显卡均可参与生成,代价是成倍增加的处理时间。操作流程分三步:关闭延长模块生成首段并保存latent编号,再开启Motion Context对应编号续接第二段,另有独立首尾帧模块和配合豆包等LLM使用的官方提示词skill文档辅助创作。
如果你的显卡不是4090也不是5090,但又想在本地跑出长视频,MiniMax H3的这套ComfyUI整合工作流值得研究。它的核心价值在于两点:突破模型自带的时长上限,以及让低显存用户也能参与长视频生成。
MiniMax H3的时长瓶颈与破解思路
MiniMax H3本身在视频生成上有明确的时间上限,一般到15秒就基本封顶,再往后拉长,画面质量会明显下滑甚至直接崩坏。这是当前多数视频生成模型的通病——训练时的上下文长度决定了单次生成的稳定区间。
这套工作流基于此前的「双十中采样」工作流改造而来,目标就是把单次15秒的天花板抬高到30秒、40秒乃至更长。它并不是简单地强行拉长单段生成,而是通过分段接续的方式实现,这一点是它能保持画质稳定的关键。
低显存优化:分块处理换时间
对于8G、12G这类显存吃紧的用户,作者专门加入了两个节点,核心逻辑是分块处理(tiled)。
实测数据很有参考价值:在70万像素(0.7)下跑10秒,未开启分块时是跑不动的;开启分块处理、分两块后,可以跑到80万像素、10秒的规模。分块数量可以填2、4、8——分的块数越多,对显存的要求越低,但处理耗时也越长,本质是拿时间换显存。
作者建议在显存允许的情况下分两块即可,速度相对更快。此外还有一个清理CLIP模型占用的节点,用于释放显存,进一步为低配机型腾出空间。这也是标题所说「6G可用」的底气来源——通过分块和显存清理,把资源门槛压到了消费级甚至入门级显卡。
「分块处理(tiled)」在图像生成领域是一种经典的显存优化手段,最早被广泛用于Stable Diffusion的高分辨率放大场景。其原理是将完整的特征图(feature map)在空间维度上切分为若干子块,对每个子块独立进行卷积或注意力计算,再拼合结果。由于每次只需将一个子块及其邻域加载进显存,峰值显存占用随块数增加而线性下降。代价是:分块边界处需要做重叠采样(overlap sampling)以避免拼接缝,且整体计算量实际会略有增加,因此总耗时比不分块更长。视频生成中的tiled处理在时间轴上同样适用——把整段视频按帧组切块后依次处理,显存峰值从「整段视频所需」压缩到「单块所需」,这正是6G显卡得以参与生成的根本原因。
Motion Context:长视频衔接的核心机制
整套工作流最核心的模块是motion context,它决定了分段生成的视频能不能「接得上」。
它的工作逻辑并非简单地把上一段的最后一帧作为下一段的首帧。按作者的解释,motion context会把上一段视频结尾大约一秒左右的模型内部状态直接带入下一段的开头。也就是说,第二段视频不是重新生成,而是接着上一段继续往下演。
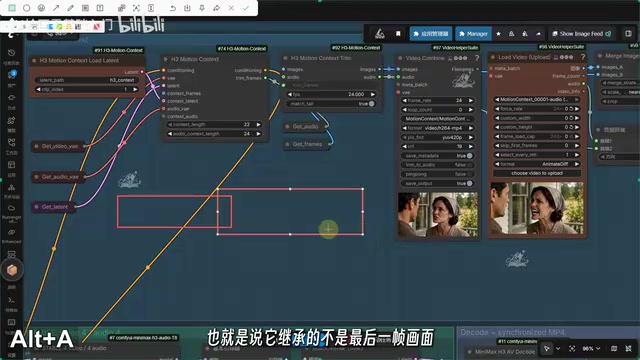
它继承的不只是画面,而是这一小段里的运动方向、镜头速度、人物动作、环境声音和节奏等一系列数据。这些数据被第二阶段的生成过程继承,从而保证了段与段之间在运动和音画上的连续性。从原理上看,这类似于保留隐空间(latent)状态而非仅保留像素帧,能有效避免拼接处的画面突变和结构断裂。
从技术角度理解,「模型内部状态」指的是扩散模型在生成过程中维护的隐空间(latent space)张量,而非解码后的像素图像。传统的「末帧续接」方案只保留最后一帧的RGB像素作为下一段的条件输入,这会导致模型在新段落中重新推断运动趋势,造成速度突变或镜头跳切。Motion Context的做法相当于保留了最后若干步扩散过程的中间表示,让第二段生成从一个已有运动惯性的状态出发,而非从随机噪声重新推演。这在机制上类似于语言模型的KV Cache或RNN的隐状态传递——不丢弃已计算的上下文,而是把它携带到下一次推理中。这也解释了为什么衔接处的音频节奏能保持连贯:声音特征同样编码在隐空间的时序维度里,被一并继承下来。
实际操作流程拆解
工作流的使用分几个清晰步骤,以「兰博基尼高速奔跑」这个图生视频案例演示:
生成第一段视频
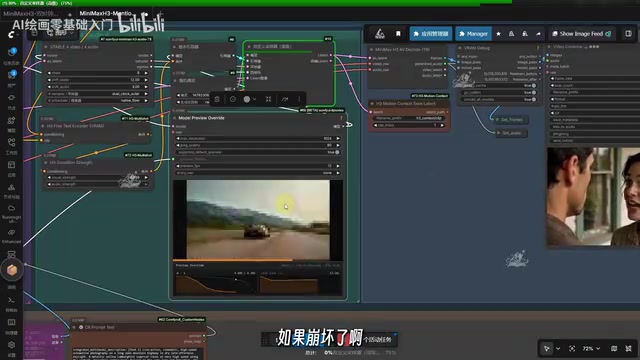
第一段视频不需要视频延长,所以先把motion context模块断开关闭。图生视频选用FL开头的模型,把save latent节点编号设为1,方便记忆和后续加载。填入提示词后运行即可。采样过程节点可以实时观察画面大致样貌——如果发现崩坏就直接取消调参,没崩坏再让它继续生成,这一步能省下不少无效等待时间。
延长生成第二段
生成好第一段后,打开motion context模块,把第一段视频上传进来。关键在于save latent的编号对应关系:第一次生成时保存了编号为1的隐空间数据,延长时就要先加载这个编号1的数据,而第二次生成的输出则对应改成2。填入新的提示词后运行,第二段就会在第一段的运动与音画基础上续接。
首尾帧生成
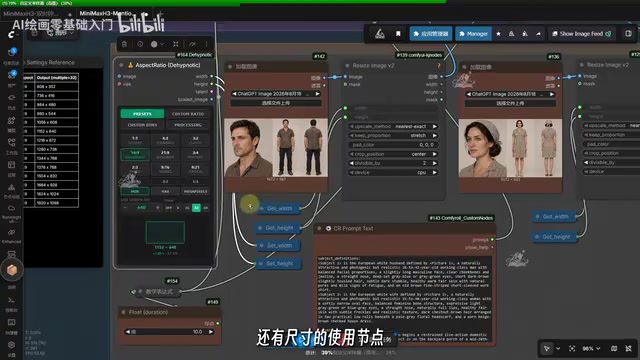
工作流还单独提供了首尾帧模块。只想用首帧生图,就把尾帧关掉;首尾帧都要,就两边都打开。这里配了一个快捷的分辨率与尺寸节点,可以直接选择想要的尺寸,不确定数值时可参考内置尺寸表,最短边和目标秒数都能设定。
提示词的官方Skill技巧
作者提供了一份官方的提示词skill文档。用法很实用:把这份skill文档丢给豆包等任意智能体,再告诉它你的剧情,智能体就会按照官方规范生成符合模型偏好的提示词,复制回工作流粘贴即可运行。这解决了很多用户「不知道怎么写提示词」的痛点,把结构化的提示规范交给LLM来完成。
从最终演示效果看,两段视频的衔接完成度较高,画面没有出现结构性变化,音频也保持了连贯。对于想在本地、用中低端显卡尝试长视频生成的用户,这套思路提供了一个可落地的方案。需要注意的是,分块换时间的策略意味着低显存用户要有一定的耐心,块数越多等待越久。
相关推荐

气态巨行星上的浮空城市:为什么人类终将移居木星云端
SFIA 主持人 Isaac Arthur 重新定义气态巨行星浮空城市:它们不是等待聚变的燃料站,而是散装氢、氦、氮的"质量城市"。本文解析其工程原理、供电方案与从工业前哨到文明家园的演化逻辑。

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。