MiniMax H3实时交互数字人:Intel Arc Pro B70实测
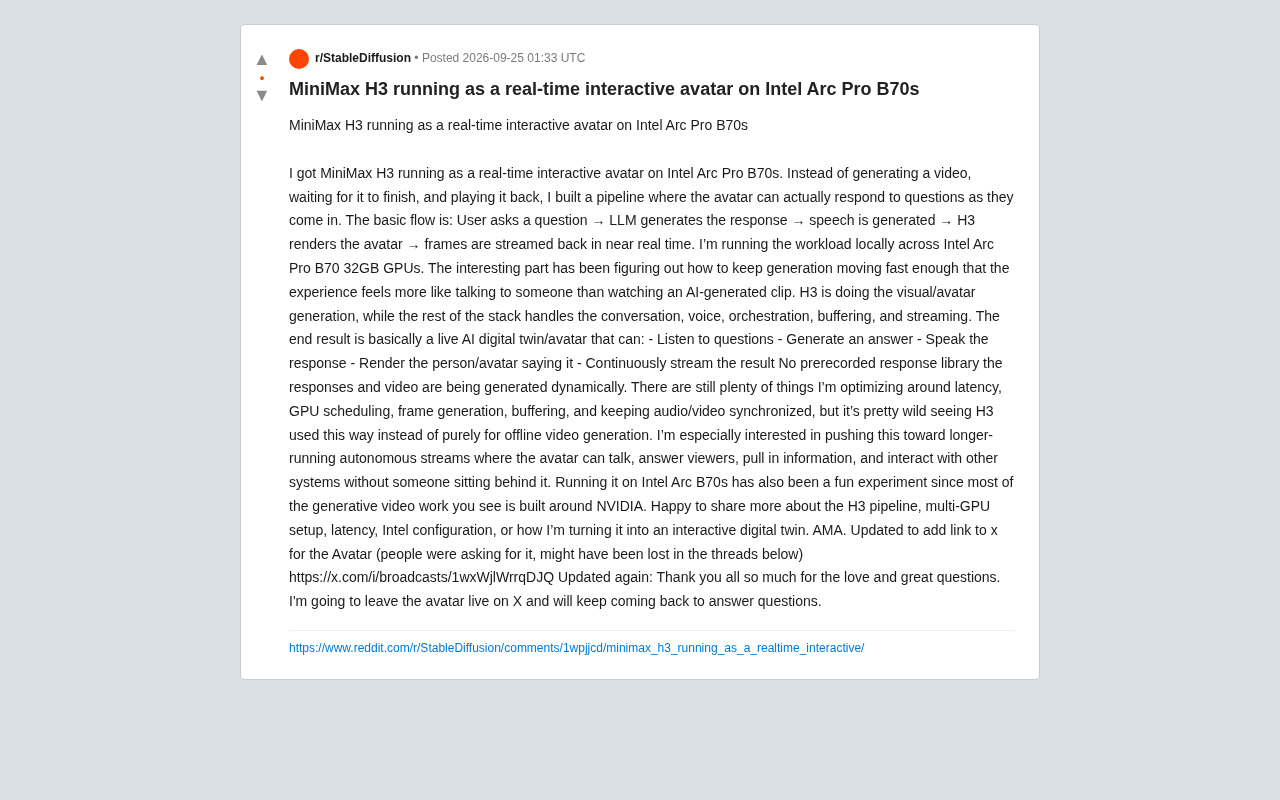
开发者将MiniMax H3改造为实时交互数字人,并在Intel Arc Pro B70上跑通完整流式生成管线。
一位开发者将离线视频生成模型MiniMax H3改造成实时交互数字人系统,构建了"用户提问→LLM回答→语音合成→H3画面渲染→流式传输"的完整管线,所有回答和视频均动态生成,不依赖预录素材。架构上采用模块化解耦,H3仅负责画面生成,对话、语音、编排、缓冲各自独立处理,从而使延迟可分段优化。更值得关注的是,整套系统运行在Intel Arc Pro B70 32GB显卡上,而非主流的NVIDIA GPU,验证了非CUDA生态在生成式视频推理场景下的可行性。开发者下一步目标是实现无需人工干预的长时间自主AI直播,目前已在X平台进行公开演示并开放社区AMA。
一位开发者在Reddit上分享了一个颇具突破性的实践:他把原本用于离线视频生成的MiniMax H3模型,改造成了一个能实时对话的交互式数字人(avatar),而且整套系统跑在Intel Arc Pro B70这样的非NVIDIA显卡上。这个方向之所以值得关注,是因为它挑战了两个既定认知——H3只能做离线视频、生成式视频必须依赖NVIDIA。
从离线渲染到实时对话的转变
传统的AI视频生成流程是:给出提示词,等待模型渲染完成,再回放成品。这个过程往往需要数秒到数分钟,体验上更像是"观看一段AI剪辑",而非"与人交谈"。
这位开发者构建的管线彻底改变了节奏。他的完整流程是:用户提问 → LLM生成回答 → 语音合成 → H3渲染数字人画面 → 帧以近实时方式流式传回。关键区别在于"流式"二字——画面不是等全部生成完再播放,而是边生成边推送,让延迟被摊薄到可以接受的范围内。
他强调,整个系统没有任何预录的回答库,所有的文字回应和视频画面都是动态实时生成的。这意味着数字人理论上可以回答任意问题,而不是从固定素材库里挑选片段。
流式传输(streaming)在这里的技术含义是:模型生成出第一批帧后立即开始向客户端推送,而非等待整段视频完全渲染完毕再传输。这与视频直播中的HLS/RTMP流媒体协议思路相通,核心目标是将"首帧延迟"(time-to-first-frame)压缩到用户可接受的范围,通常认为低于500毫秒时交互感才会较为自然。
对于生成式视频模型来说,实现流式输出并不是默认能力——大多数视频扩散模型在设计上是一次性推理出完整序列再解码,要做到逐帧或逐段输出需要对推理调度做专门改造。这也解释了为什么开发者将"帧生成速度"和"缓冲策略"列为持续打磨的重点:两者直接决定了流式管线能否维持稳定的帧率输出,避免画面卡顿。
H3只负责画面,其余交给编排层
值得拆解的是这套架构的分工。MiniMax H3在其中只承担视觉/数字人生成这一环,而对话逻辑、语音合成、任务编排、缓冲和流式传输,全部由技术栈的其他部分处理。
这种解耦设计是实时数字人能跑起来的核心。把"说什么"(LLM)、"怎么说"(语音)、"长什么样"(H3)拆分成独立模块,每一环都可以单独优化和调度。开发者提到,目前仍在持续打磨的点集中在几个方面:延迟控制、GPU调度、帧生成速度、缓冲策略,以及音视频同步。
音视频同步在实时场景里尤其棘手——语音已经播到某个词,画面里的口型如果对不上,观感会立刻崩塌。这也是为什么他反复提到"buffering"(缓冲)在整个管线里扮演的角色。
音视频同步(lip sync)在实时数字人场景下面临双重挑战:一方面,语音合成(TTS)和视频生成是两条独立的异步管线,各自有不确定的处理延迟;另一方面,视频扩散模型并非天然以音频为条件进行帧生成,需要额外的口型驱动(audio-driven talking head)机制将音频特征映射到面部动作。
业界常见的解决路径包括:使用Wav2Lip、SadTalker等专用口型同步模型在H3输出帧上做二次处理,或在生成阶段直接将音频嵌入扩散模型的条件输入。缓冲层的作用正是在此:通过在播放端维持一个短时间的帧队列,吸收上游生成速率的抖动,确保音频时间戳与对应画面帧在播出时对齐,而非按各自到达顺序随机播放。
押注Intel Arc Pro B70的意义
这个项目最反直觉的地方,是硬件选择。当前绝大多数生成式视频工作都是围绕NVIDIA的CUDA生态构建的,而这位开发者选择在本地多张Intel Arc Pro B70 32GB显卡上跑完整工作负载。
他自己也把这称为"一次有趣的实验"。在Intel Arc上做多GPU的生成式视频推理,本身就意味着要处理一系列生态适配问题——从驱动、框架支持到显存管理。他在帖子里主动表示愿意分享多GPU配置、Intel环境配置的细节,说明这部分踩坑经验对社区有实际价值。
对于关注AI硬件多元化的人来说,这是一个信号:非NVIDIA显卡在生成式AI推理场景下,正在逐步验证其可行性,尤其是32GB大显存这样的规格对本地部署很友好。
Intel Arc Pro B70是Intel于2024-2025年推出的专业级独立显卡,基于Battlemage架构,单卡配备32GB GDDR6显存,这一规格在同价位的专业卡中颇具竞争力。与消费级Arc系列不同,Arc Pro面向工作站和专业推理场景,在驱动稳定性和长时间负载上有更好的保障。
在AI推理生态方面,Intel提供了oneAPI和OpenVINO工具链来适配主流深度学习框架,但相比NVIDIA的CUDA生态,社区积累和框架兼容性仍有明显差距——许多模型默认只提供CUDA优化路径,移植到Intel GPU需要额外的适配工作,这也是该开发者提到"踩坑"的主要来源。32GB显存的优势在于可以在本地装载较大的模型而无需量化降精度,这对视频生成模型这类显存密集型任务尤为关键。
下一步:走向长时间自主直播
开发者透露了他更远的目标——把这个数字人推向长时间运行的自主直播。设想中的形态是:数字人能持续讲话、回答观众提问、主动拉取信息、并与其他系统交互,全程无需真人坐在后台操控。
这实际上勾勒出了一个"AI数字孪生主播"的雏形。如果延迟和稳定性问题得到解决,这类系统在虚拟主播、客服、教育演示等场景都有明确的落地空间。
他已经把这个数字人挂在X平台上做直播演示(原帖附有广播链接),并承诺会持续回来回答社区提问,态度相当开放,愿意就H3管线、多GPU设置、延迟优化和Intel配置等话题做AMA(有问必答)。
为什么这个案例值得关注
这个项目本身还处在优化阶段,作者也坦承延迟、调度、同步等问题都还在打磨。但它的示范意义在于三点:把离线视频模型改造成实时交互系统的工程思路、模块化解耦的架构设计,以及在非主流硬件上验证生成式AI的可能性。
对于想复现类似效果的开发者,核心难点不在单个模型,而在于如何让整条流水线"流动"起来——让每一帧、每一段语音、每一个回答都及时衔接,最终逼近真人对话的自然感。这也是实时生成式AI从"能做"走向"好用"必须跨越的门槛。
相关推荐
SR-71黑鸟侦察机"消失"事件:一则待考证的科技悬案
Hacker News出现《SR-71黑鸟侦察机消失》帖子引发关注。本文梳理SR-71这一传奇侦察机的技术背景,并对该待考证事件保持理性审慎态度。
Qwen Image 2.1 换脸 LoRA 上手:bestfaceswap 实测观察
基于 Qwen Image 2.1 的换脸 LoRA 模型 bestfaceswap(bfs)通过自然语言指令实现多图头部替换。本文梳理其技术定位、LoRA 换脸原理及使用中的效果与合规注意点。
AI设计芯片时代来临?TechCrunch Disrupt聚焦AI硬件闭环
TechCrunch Disrupt 2026上,Ricursive Intelligence创始人Anna Goldie与Azalia Mirhoseini将探讨AI如何设计自己的硬件,闭合AI与芯片开发的循环。解析AI辅助芯片设计的前景与挑战。