MiniMax上调API价格60%-65%,国产大模型价格战迎来拐点

MiniMax宣布API价格大幅上调
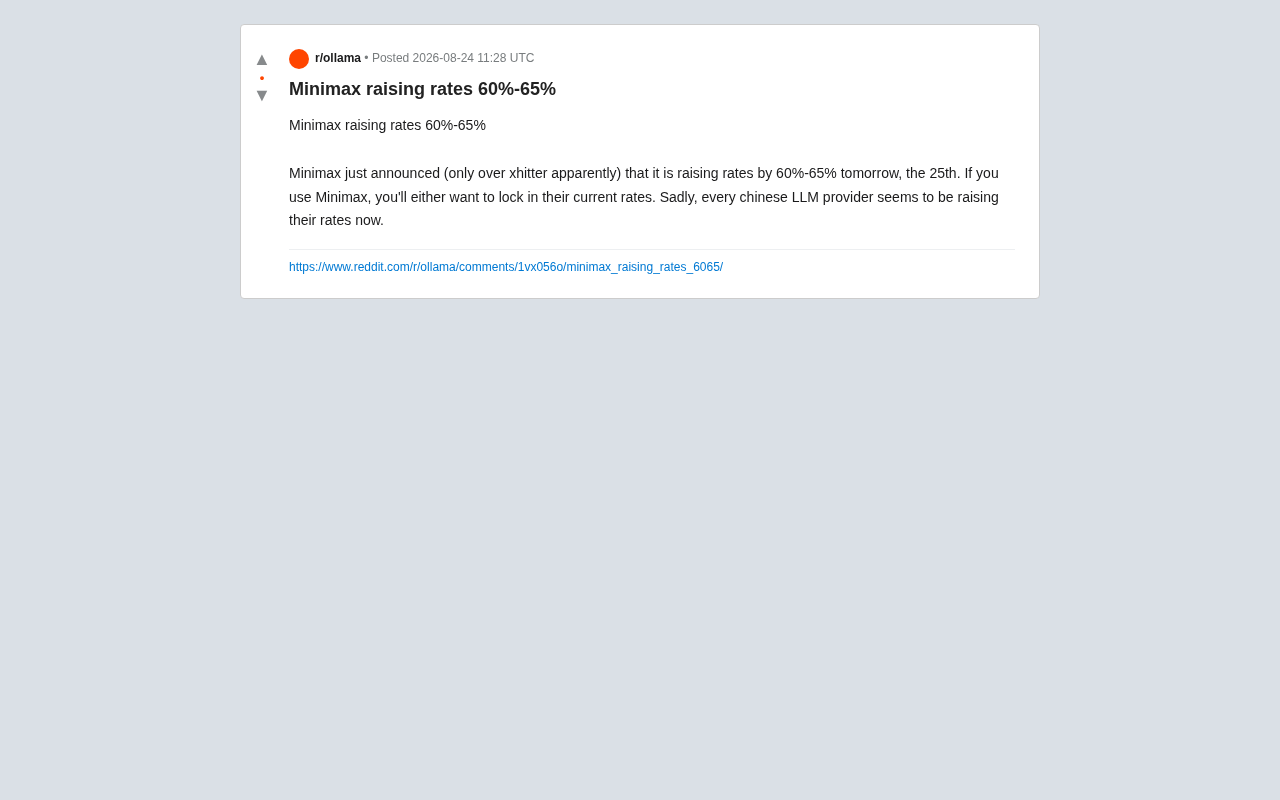
据Reddit社区消息,中国AI公司MiniMax(稀宇科技)近日通过X(原Twitter)平台宣布,将于25日起对其API服务价格上调60%至65%。这一消息目前主要通过其海外社交媒体渠道传播,引发了开发者社区的广泛关注。
MiniMax(稀宇科技)成立于2021年,由前商汤科技副总裁闫俊杰创办,是中国AI大模型赛道的重要玩家之一,常被归入"AI六小龙"之列(与智谱AI、月之暗面、百川智能、零一万物、阶跃星辰并称)。这六家公司在2023-2024年间合计吸引了数百亿元人民币的融资,各自走出了差异化路线:智谱AI侧重通用大模型与企业服务,对标OpenAI的全栈路线;月之暗面(Kimi)以长上下文处理能力和C端产品见长;百川智能聚焦医疗等垂直领域;零一万物由李开复创办,强调多语言能力;阶跃星辰则专注多模态理解与生成。在这一竞争格局中,MiniMax的独特定位在于其多模态全栈能力——公司在文本生成、语音合成、视频生成等多模态领域均有布局,尤其是其语音合成技术(Speech-02模型)在自然度和情感表达方面获得了行业认可,被认为是国产语音合成技术的第一梯队。
其海外产品Talkie(主打AI角色对话)一度在北美市场获得可观的用户量。Talkie所处的AI角色对话赛道是2023-2024年全球AI应用中增长最快的细分市场之一,头部产品Character.AI在巅峰时期月活用户超过2000万。这类产品允许用户与各种AI角色进行沉浸式对话——从虚构人物到历史名人,从心理陪伴到语言学习——其核心技术依赖于大语言模型的角色扮演能力和语音合成的自然度。Talkie凭借MiniMax在语音合成方面的技术优势,在北美市场与Character.AI、Chai等产品形成竞争,一度进入美国App Store娱乐类应用下载榜前列。这一海外C端产品的成功也使得MiniMax成为少数同时运营海外API服务和消费级产品的国产大模型厂商,因此此次涨价对海外开发者生态和其自身产品矩阵的影响尤为直接。
对于依赖MiniMax模型的开发者和企业而言,这次调价幅度不容小觑。有社区用户提醒,如果你目前正在使用MiniMax的服务,可能需要考虑在涨价生效前锁定当前价格,以规避成本上升带来的冲击。
不只是MiniMax:国产大模型集体涨价潮
你可能没注意到,这次涨价并非MiniMax的孤立行为。正如Reddit原帖所指出的,「几乎每一家中国LLM提供商现在似乎都在提高价格」。这标志着此前持续了近两年的国产大模型「价格战」可能正在迎来拐点。
从价格战到理性回归
回顾过去两年,中国大模型市场经历了激烈的价格竞争。多家厂商争相降价,部分模型的API调用价格甚至降至每百万Token几分钱的水平,一度被业界形容为「以亏损换市场」的补贴大战。
这里有必要解释一下API的计费机制:大模型API服务通常按Token数量计费。Token是模型处理文本的基本单位,并非简单的"一个字"或"一个词"——在英文中,一个Token大约对应4个字符或0.75个单词;在中文中,一个汉字通常被编码为1-2个Token(具体取决于模型使用的分词器,如BPE、SentencePiece等不同的Tokenizer实现会有差异)。API定价一般分为输入Token(用户发送的prompt)和输出Token(模型生成的回复)两部分,输出Token的单价通常高于输入Token,因为生成过程需要逐步推理,消耗更多算力。价格上调60%-65%意味着,原本每百万Token花费1元的调用,涨价后将变为1.6至1.65元,对高频调用的应用来说累积效应非常显著。
国产大模型价格战的标志性事件可追溯到2024年5月前后。当时字节跳动旗下的豆包大模型率先将价格打至极低水平(输入价格低至0.8元/百万Token),随后阿里云广告通义千问、百度文心一言、科大讯飞星火等主流厂商纷纷跟进,部分模型甚至宣布免费开放API调用。这场价格战的逻辑与互联网时代的"烧钱获客"如出一辙:先用低价甚至免费策略吸引开发者在自己的平台上构建应用,形成生态锁定效应后再逐步商业化。
这一策略在中国互联网行业有着丰富的先例。2014-2016年的网约车大战中,滴滴和Uber中国合计烧掉数十亿美元补贴乘客和司机;外卖领域美团与饿了么的补贴战同样持续数年。这些案例的共同特征是:互联网服务的边际成本极低——多服务一个用户的增量成本几乎可以忽略不计,因此"烧钱换规模"在数学上是可行的,一旦形成网络效应和用户习惯,就能通过提价或增值服务实现盈利。然而,大模型推理服务有着本质不同:每一次API调用都需要消耗真实的GPU算力——模型的前向推理过程涉及数十亿到数千亿参数的矩阵运算,需要占用昂贵的GPU显存和算力资源。这意味着大模型服务的边际成本不是趋近于零,而是相当可观且与调用量线性相关。当价格战把API定价压到低于推理成本时,每多一个用户、每多一次调用都在加速亏损,这使得"以量换价"的策略在经济上比传统互联网补贴战更加难以持续。
这种打法在短期内快速扩大了用户基础,但从商业可持续性角度看,长期低价乃至亏本经营难以为继。随着资本市场趋于理性、算力成本压力持续存在,厂商开始重新审视定价策略,回归到更能覆盖成本、支撑研发投入的价格水平,是符合商业逻辑的必然选择。
涨价背后的深层原因
算力与运营成本的现实压力
大模型推理服务的核心成本来自GPU算力。在高端AI芯片供应受限、能源与运维开销高企的背景下,长期的低价策略实际上在侵蚀厂商的现金流。
目前全球AI训练和推理的主流硬件仍是NVIDIA的高端GPU(如H100/H200/B200系列)。自2022年起,美国政府对中国实施了多轮AI芯片出口管制,限制了NVIDIA等厂商向中国销售高性能AI芯片。具体而言,这一管制经历了三个关键阶段:2022年10月,美国商务部首次限制向中国出口A100和H100芯片;NVIDIA随即推出了降频版A800和H800以规避管制。2023年10月,管制进一步升级,A800和H800也被禁止出口,NVIDIA不得不再次推出性能更低的H20芯片供中国市场。到2024-2025年,管制范围扩展到更多芯片类型和半导体制造设备,甚至对H20的出口也施加了更严格的限制。这一系列管制的累积效应是:中国AI公司获取顶级训练芯片的渠道被大幅收窄,不得不以更高的价格通过各种渠道采购,或转向国产替代方案。
虽然国产替代方案(如华为昇腾910B/910C)也在加速追赶,但在绝对性能、软件生态成熟度和供应充足性方面,国内厂商仍面临结构性的算力成本压力。华为昇腾芯片在硬件算力上已接近NVIDIA同代产品的70%-80%水平,但其软件栈(CANN/MindSpore)与NVIDIA的CUDA生态相比,在开发者工具链成熟度、第三方库支持和调试便利性方面仍有差距。CUDA生态经过十余年的发展,积累了PyTorch、TensorFlow等主流框架的深度适配,以及cuDNN、TensorRT等高度优化的推理加速库,形成了强大的"软件护城河"。这意味着中国AI公司的单位推理成本可能高于海外同行,长期低价策略的代价也更为沉重。
当融资环境收紧、投资人对盈利路径提出更高要求时,涨价成为改善单位经济模型(unit economics)的直接手段。所谓单位经济模型,是衡量商业可持续性的核心指标,指的是每服务一个用户或完成一笔交易所产生的收入与成本的关系。在大模型API业务中,关键指标包括:每百万Token的收入(API定价)、每百万Token的推理成本(GPU算力、电力、带宽、运维)、以及客户获取成本(CAC)和客户生命周期价值(LTV)的比值。当API定价低于推理成本时,每一次调用实际上都在亏损,厂商需要靠融资"输血"维持运营。涨价的本质就是让单位经济模型转正——确保每一次API调用至少能覆盖其边际成本,并为研发投入和利润留出空间。
从「抢用户」到「留价值用户」
价格战阶段的核心目标是获取尽可能多的用户和调用量。但海量的低价甚至免费调用中,真正具备付费意愿和商业价值的客户占比有限。通过适度涨价,厂商可以筛选出对模型能力有真实刚需、愿意为价值付费的客户,从而优化收入结构。
这一策略在SaaS行业有一个经典概念——「客户质量分层」。在价格极低时,大量用户可能只是抱着"试试看"的心态使用服务,他们的调用模式往往是零散、低频且对模型输出质量要求不高的。这类用户贡献的收入微薄,但同样占用GPU资源和技术支持带宽。相比之下,真正将大模型API深度集成到自身产品中的企业客户——例如将AI客服、智能文档处理、代码辅助等功能嵌入核心业务流程的公司——其调用量大、留存率高、付费意愿强,是支撑平台长期营收的"锚定客户"。适度涨价的效果类似于一个天然的筛选机制:价格敏感型用户可能会流失或转向开源方案,而高价值客户因为迁移成本和对模型特定能力的依赖,通常会选择留下。
这也解释了为何多家厂商会在相近的时间窗口内做出类似决策——这是行业周期性的集体调整,本质上是一种"纳什均衡"的演化:当所有竞争者都意识到持续亏损不可持续,且没有任何一家能通过低价彻底消灭对手时,集体回归理性定价就成为博弈论意义上的稳定策略。
对开发者与企业的实际影响
短期:运营成本上升与迁移压力
60%-65%的涨幅对于调用量较大的应用而言,意味着运营成本的显著增加。对于毛利本就微薄的AI应用创业者来说,这可能直接影响商业模式的可行性。因此,锁定现有价格、评估多供应商组合、优化调用效率(如缓存、批处理、压缩prompt)等策略变得尤为重要。
具体而言,这些优化策略各有侧重:语义缓存(Semantic Caching)是指对相似的用户查询复用之前的模型输出,避免重复调用API。与传统的精确匹配缓存不同,语义缓存使用向量相似度来判断两个查询是否"足够相似"——即使用户用不同的措辞提出了本质相同的问题,也能命中缓存。工具如GPTCache可以实现这一功能,在某些场景下(如FAQ类客服、知识库问答)可将API调用量降低30%-70%。批处理(Batching)是将多个请求合并为一次API调用,减少请求开销并可能享受批量折扣——OpenAI等厂商已提供专门的Batch API端点,价格通常比实时调用低50%,代价是响应延迟从秒级变为小时级,适合离线数据处理、批量内容生成等不需要实时响应的场景。Prompt压缩则是通过精简系统提示词、去除冗余上下文、使用更高效的提示词工程技巧来减少输入Token数量——例如用结构化的JSON格式替代冗长的自然语言指令,或使用LLMLingua等专门的prompt压缩工具,在几乎不损失输出质量的前提下将输入Token数减少2-5倍。此外,还有一些进阶策略,如使用路由机制(Router)根据任务复杂度将请求分发给不同规模的模型——简单任务用小模型、复杂任务才调用大模型——从而在整体层面降低平均调用成本。像Martian、OpenRouter等服务已经提供了这类智能路由功能,开发者也可以基于简单的分类器自行实现。
长期:市场格局走向重塑
涨价潮实际上是行业从「野蛮生长」走向「精耕细作」的信号。对开发者而言,这意味着需要:
- 建立多模型能力:避免对单一供应商的过度依赖,保持技术栈的灵活性。具体做法包括使用抽象层(如LiteLLM、LangChain的模型切换接口)将业务逻辑与底层模型解耦,使得切换供应商只需修改配置而非重写代码;
- 关注性价比而非绝对低价:在能力、延迟、稳定性和价格之间寻找平衡;
- 重视开源模型方案:随着开源模型能力不断提升,自建部署或使用开源模型可能成为控制长期成本的重要选项。
关于开源模型方案,值得展开说明的是,开源大模型能力在2024-2025年经历了飞速提升。Meta的Llama系列(Llama 3/3.1/4)、阿里的Qwen系列(通义千问开源版)、DeepSeek广告的DeepSeek-V3/R1、Mistral AI的系列模型等,都已达到接近甚至部分超越闭源商业模型的水平。开发者可以通过Ollama、vLLM、TGI(Text Generation Inference)等推理框架在自有服务器或云GPU上部署这些开源模型,一次性支付算力租赁费用而无需按Token付费。
这些推理框架各有技术特色:vLLM由UC Berkeley团队开发,其核心创新是PagedAttention技术——借鉴了操作系统虚拟内存管理的分页思想,将KV Cache(模型推理过程中存储注意力键值对的缓存)组织为非连续的内存页,极大提高了GPU显存利用率,使得同一张GPU卡能同时处理更多并发请求,吞吐量相比传统实现提升2-4倍。Ollama则侧重于简化本地部署体验,一行命令即可在个人电脑上运行开源模型,适合开发测试和轻量级应用。HuggingFace的TGI则提供了生产级的推理服务能力,支持连续批处理(Continuous Batching)、张量并行(Tensor Parallelism)等高级特性,适合需要高可用性的企业级部署。
对于调用量大的应用,自建部署的总成本往往显著低于使用商业API。以一个粗略的成本对比为例:在云平台上租用一张NVIDIA A100-80G GPU(约每小时2-3美元),运行Llama 3 70B模型,每秒可处理约30-50个Token的输出,一天可产生约260万-430万Token的输出。按月计算,GPU租赁成本约1500-2200美元,对应的Token产出如果按商业API定价购买,费用可能高出数倍。当然,自建部署也带来了运维复杂度、模型更新迭代、安全合规等额外挑战,需要团队具备相应的工程能力。中小团队可以考虑使用Replicate、Together AI、Fireworks AI等"开源模型托管平台"作为折中方案——它们提供开源模型的API化服务,价格通常低于闭源商业API,同时免去了自建运维的负担。
结语:价格战终局的开端
MiniMax的这次涨价,或许可以看作国产大模型市场进入新阶段的一个缩影。当补贴退潮,真正的竞争将回归到模型能力、工程效率和商业价值本身。
对于身处其中的开发者和企业,与其被动承受成本波动,不如主动构建更具韧性的技术架构和成本策略。在AI基础设施走向成熟的过程中,理性定价终将取代恶性补贴,成为行业健康发展的必经之路。
(注:本文基于Reddit社区消息整理,MiniMax具体调价细节以官方公告为准。)
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。