Mistral Large 4(LeChonk):欧洲重返AI开源第一梯队

Mistral发布1万亿参数开源模型,欧洲算力有限却凭主权合规优势重返AI牌桌
法国AI公司Mistral发布了旗舰开源权重模型Mistral Large 4,采用MoE架构,总参数1万亿但每次仅激活490亿,定位为中国以外最强开源权重模型。性能上,其综合排名中规中矩,唯独在网络安全(CTF Speedrun)领域能与前沿闭源模型正面竞争;实测中回答简洁但套话偏多,ChatGPT克隆任务中被Kimi K3超越。模型真正的价值在于"欧洲主权"维度:全程在欧洲数据中心训练、仅用约3800张GPU、符合欧盟AI法案合规要求,使其对处理敏感数据的欧洲企业极具吸引力。权重预计10月31日开放,30亿欧元D轮融资支撑后续路线图,欧洲AI生态整体正在明显升温。
欧洲似乎重新回到了AI竞赛的牌桌上,而Mistral正是这股势头的核心代表。这家法国公司发布了Mistral Large 4,代号"LeChonk"(法语意为"胖子"),据称是中国以外最强的开源权重模型——也就是欧美所有开源模型中最强的那一个。
这个说法听起来很诱人,但需要冷静看待:目前最强的闭源模型仍然来自美国,最强的开源权重模型仍然来自中国。欧洲并非这条战线上的领头羊。不过,对一家欧洲公司而言,这依然是一次相当亮眼的出击。
核心参数与定价
Mistral Large 4采用混合专家(MoE)架构,总参数量达到1万亿,但每次生成token时仅激活约490亿参数。这意味着模型需要占用较大的显存空间来加载全部权重,但实际推理计算量远小于同等规模的稠密模型,因此推理速度更快。
需要提醒的是,虽然它是开源权重模型,但权重尚未开放下载。Hugging Face页面上挂着一个倒计时,预计在10月31日左右正式放出权重。这在开源模型发布中其实很常见——宣布开源不等于当天就能下载。
定价方面,输入每百万token约1.36美元,输出每百万token约4.18美元。考虑到它的实际性能,这个价格并不算便宜,甚至可以说偏贵。
混合专家(MoE,Mixture of Experts)架构是近年大模型领域的主流方案之一。其核心思想是将模型拆分为多个"专家"子网络,每次处理输入时由一个轻量级"路由器"动态选择其中少数几个专家参与计算,而非激活所有参数。这样做的好处是:模型的总参数量(代表知识容量)可以做得很大,但单次推理的实际计算量(FLOPs)却只相当于激活参数的规模。Mistral Large 4的1万亿总参数 vs 490亿激活参数,意味着每次推理的算力消耗大约只有同规模稠密模型的1/20。这一设计使其在推理速度和成本上具有明显优势,但代价是需要将全部1万亿参数的权重同时加载到显存中,对部署硬件的内存容量要求极高。Meta的Llama 3.1系列、Google的Gemini 1.5以及DeepSeek广告系列均采用了类似的MoE设计思路。
基准测试:网络安全是真正的强项
官网上最亮眼的展示是CTF Speedrun——19项网络安全挑战的竞速对比。在加速回放中可以看到,Mistral Large 4是解题最快的模型,并且解出了19题中的18题,比第二名略多。
网络安全几乎是这款模型唯一能与前沿闭源模型(如Opus、GPT系列)正面竞争的领域。在Mistral自家公布的基准中,深度软件工程(Deep Software Engineering)上它不敌Kimi K3,但略胜GLM 5.3;Terminal Bench上高于Kimi K3但低于GLM 5.3;而在Cyber相关基准上,它与GLM 5.3 Flash持平,表现堪称领先。
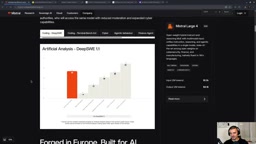
不过,模型发布页上的基准数据往往经过精心挑选,用来凸显模型优势——这是营销的常态,并不代表Mistral造假。更中立的参考是Artificial Analysis平台的数据。在综合智能排名中,Mistral Large 4 Preview定位中规中矩,谈不上惊艳,但确实是中国以外最强的开源权重模型。
值得注意的一点是名字里的"Preview"——它意味着训练尚未完成,强化学习阶段仍在进行中,最终分数理论上还有提升空间。
在Arena AI的盲测ELO排名中(coding与web开发领域),Claude Opus 5.5 Max稳居榜首。Mistral Large 4排名第45位,看似平平,但其性能水平大致相当于Opus 4.8、Sonnet 4.6或GPT-5.6级别——用一个欧洲开源模型达到这个水准,对欧洲的技术主权而言意义重大。
CTF(Capture The Flag,夺旗赛)是网络安全领域的标准竞技形式,参与者需要在规定时间内通过逆向工程、漏洞利用、密码学破解、Web渗透等技术手段找到隐藏的"旗帜"字符串。CTF Speedrun作为基准测试,衡量的是模型在有限时间内独立完成这类安全挑战的能力,能较为直接地反映模型对底层系统知识、代码调试和漏洞分析的综合掌握程度。与代码生成或数学推理等基准不同,CTF题目往往需要多步骤的逻辑链条和对边界情况的精确判断,对模型的实际"动手"能力要求更高。Mistral在此领域的优势,可能与其训练数据中包含大量欧洲网络安全社区的技术资料有关,也可能反映了其在结构化问题拆解上的特定优化方向。
主权意义大于性能本身
不必粉饰:Mistral Large 4不是前沿战线的关键玩家,即便强化学习训练完成,大概率也进不了前10甚至前15。但它的真正价值在于"欧洲主权"这个维度。
这款模型完全在欧洲数据中心训练(硬件仍是美国Nvidia的),而且仅用了约3800张GPU就完成了训练,远少于其他公司所能调动的算力。这反过来证明了Mistral团队的技术实力。
更关键的是合规优势。对于处理敏感数据的欧洲企业,使用一个在欧洲数据中心、依照欧洲监管(如AI法案)训练出来的模型,在合规层面显然是更安全的选择。只要这款模型接近可用水准,欧洲企业就很可能大规模采用它。
此外,Mistral明确表示这只是其30亿欧元D轮融资所支持路线图上的第一个里程碑,意味着后续还会持续扩充算力、推出更多模型。结合近期ALF Alpha(德国Calibri)、Black Forest Labs(Flux 3)、英国11v4等一系列欧洲模型发布,整个欧洲AI生态正在明显升温。
欧盟《人工智能法案》(EU AI Act)于2024年正式生效,是全球首部系统性AI监管法规。该法案按风险等级对AI系统分类管理,对高风险场景(如医疗、执法、关键基础设施)提出数据治理、透明度、人工监督等强制要求,并对在欧盟市场提供服务的通用AI模型(GPAI)规定了额外的合规义务,包括提交技术文档、尊重版权及披露训练数据摘要等。对欧洲企业而言,使用在欧洲数据中心训练、由欧洲公司运营的模型,不仅更容易满足数据主权和跨境传输限制(如GDPR对数据不得转移至第三国的规定),也能在审计和问责链条上保持清晰。这正是Mistral将"欧洲本土训练"作为核心卖点的商业逻辑所在——合规成本的降低本身就是实实在在的竞争优势。
实测体验:废话多,但不冗长
除了基准数据,视频作者还用自建的"Neural Yap Benchmark"(衡量模型"废话程度"的测试,目前仍是0.1 alpha版)做了评估。该测试从四个维度打分:套话短语(如"你说得对""你有理由质疑")、排版符号(AI惯用的破折号等)、格式化程度(Markdown标题、emoji等)、以及回答长度,分数越低越简洁。
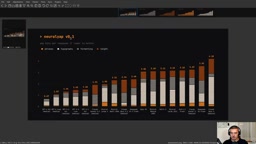
Mistral Large 4整体废话程度较低,明显优于上一代Mistral模型。它的"扣分"主要来自排版符号——用了大量AI式破折号,但这其实是最无伤大雅的一类。在回答长度上,它反而是测试中最简洁的模型之一。
问题出在套话短语上:Mistral Large 4频繁使用"你说得对,我之前的方案过度设计了,让我重新考虑"这类话术,仅次于DeepSeek V4 Flash。作者在实际项目测试(一个关于数据模型变更的误导性问题)中也印证了这一点——模型给出了冗长的分析,并带有明显的迎合式措辞,这是作者个人非常反感的模式。
构建ChatGPT克隆实测
作者还让多个模型用同一套复杂提示构建一个支持多AI供应商、带语音输入和多主题切换的ChatGPT克隆应用,对比对象包括DeepSeek V4、GLM 5.3、GPT-6 Soul、Kimi K3、Mistral Large 4以及Opus 5.5。
结果出人意料:Kimi K3表现最佳,设计出色、语音输入实时可用、各主题(Frutiger Aero、Dorfic、像素风)都还原得不错。而作者最推崇的Opus 5.5这次反而翻车,界面不佳、无法选择模型、连基本对话都没能跑通,语音输入也失效。
Mistral Large 4的成品界面一般——用图标代替文字、麦克风按钮不够美观,Dorfic主题也没做对,整体介于DeepSeek和GLM 5.3之间,优于后者但不及Kimi K3。
结论
综合来看,Mistral Large 4并未重新定义性能天花板,它在排行榜上的位置相当有限。但对欧洲而言,这是一次意义重大的胜利:用更少的算力、完全在欧洲本土训练出了一款达到数月前顶级水准的开源模型,并且在网络安全这一垂直领域真正触及了前沿。
随着权重即将开放、技术报告有望发布,加上背后30亿欧元融资的支撑,Mistral乃至整个欧洲AI生态都值得持续关注。欧洲,至少暂时,重新回到了桌面上。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。