Mistral Large 4:面向网络安全的顶级AI模型?

Mistral宣称Large 4是全球最强网络安全AI之一,以垂直能力和欧洲合规优势差异化竞争,但实力仍待独立评测验证。
法国AI公司Mistral将旗舰模型Large 4定位为全球网络安全能力最强的AI之一,标志着大模型竞争开始向高价值垂直领域延伸。网络安全在威胁检测、漏洞审计、安全运营等场景具备明确商业价值,吸引头部厂商争相布局。Mistral的差异化在于:凭借欧洲本土身份,在数据主权、GDPR合规及欧盟AI法案监管框架下,面向政府、金融等敏感行业具备信任优势。然而,"全球最强之一"目前仍属营销表述,缺乏公开基准数据和第三方评测支撑。后续最值得关注的是其在权威安全基准上的具体成绩、双刃剑滥用风险的防控机制,以及真实企业部署案例的浮现。
Mistral Large 4 剑指网络安全赛道
法国AI公司Mistral近期对外宣称,其旗舰模型 Mistral Large 4 是全球网络安全能力最强的AI模型之一。这一定位标志着大模型竞争正在从通用对话、代码生成等常规场景,向专业化、垂直化的高价值领域延伸。网络安全作为企业与政府机构的刚需场景,正成为头部模型厂商争夺的新战场。
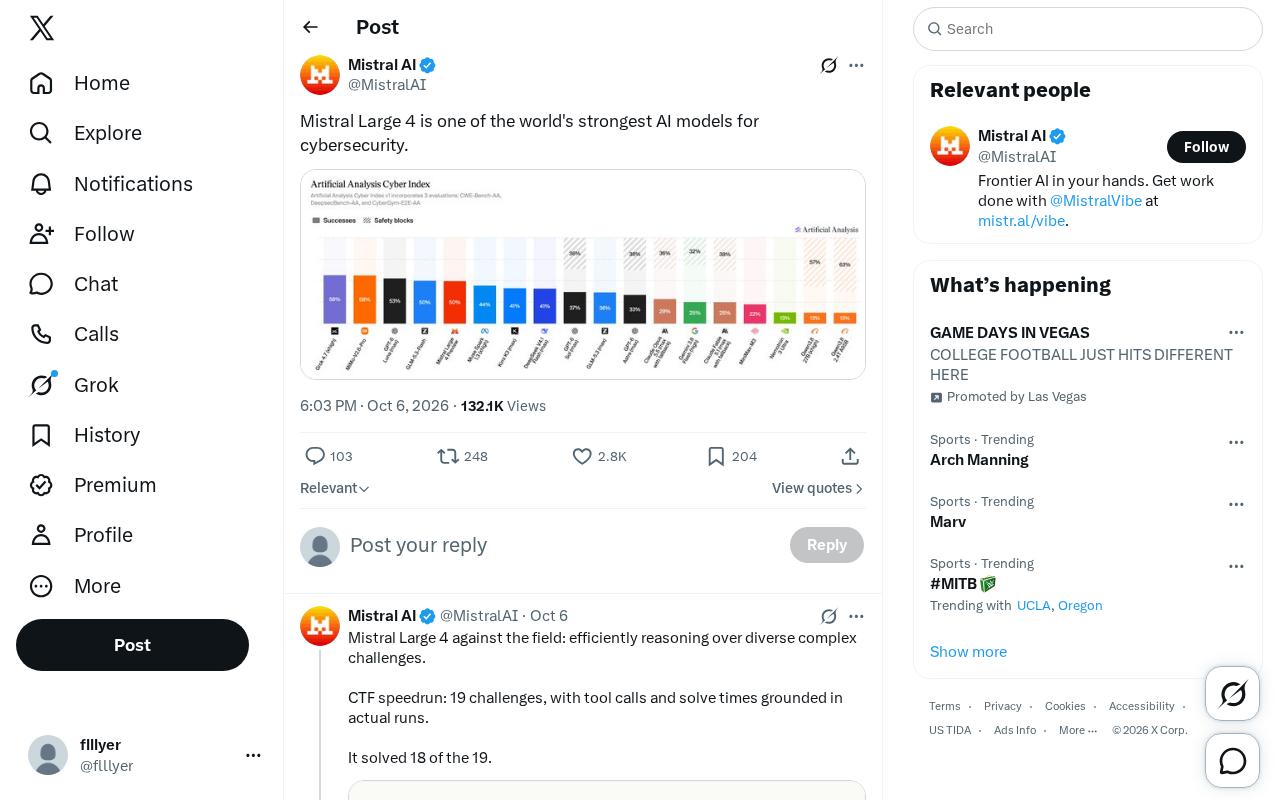
从公开信息看,Mistral 将网络安全作为核心卖点,意在与 OpenAI、Anthropic、Google 等竞争对手形成差异化。相比追逐通用基准测试的高分,强调在特定高门槛领域的专长,往往更能打动有明确采购需求的企业客户。
为什么网络安全成为大模型的新战场
网络安全是一个对准确性、推理能力和实时响应要求极高的领域。AI模型在其中的潜在应用相当广泛,包括:
威胁检测与分析
大模型可以辅助安全分析师快速解读海量日志、识别异常行为模式、关联多源告警信息,从而缩短威胁发现时间。面对日益复杂的攻击手法,这类自动化分析能力正变得越来越重要。
漏洞识别与代码审计
具备强代码理解能力的模型能够扫描源代码、识别潜在漏洞、提出修复建议。这对于开发安全(DevSecOps)流程的整合有直接价值。
DevSecOps(开发、安全、运营一体化)是将安全实践嵌入软件开发全生命周期的工程理念,目标是让安全检查在代码提交阶段就自动触发,而非等到上线前才做集中审计。传统模式下,安全团队与开发团队脱节,漏洞往往在产品发布后才被发现,修复成本极高。AI代码审计工具可以在CI/CD流水线中充当"安全卫兵",对每次代码提交实时扫描SQL注入、缓冲区溢出、硬编码密钥等常见漏洞类型,并以自然语言解释风险成因和修复方案,降低开发者的学习门槛。目前已有GitHub Copilot Autofix、Snyk Code等产品在此方向落地,Mistral若能在代码推理和漏洞语义理解上体现出优势,将直接切入这一已有成熟采购预算的细分市场。
安全运营辅助
从编写检测规则、生成事件响应剧本,到自动化撰写安全报告,模型可以显著降低安全团队的重复性工作负担,让人力聚焦于更高价值的决策环节。
正因为这些场景的商业价值明确,一款在网络安全维度表现突出的模型,天然具备进入企业采购清单的吸引力。
Mistral 的差异化定位意味着什么
作为欧洲最受关注的AI初创公司之一,Mistral 一直以开放权重和高性价比著称。将 Large 4 定位为网络安全领域的顶级模型,反映出其在激烈竞争中选择以垂直能力建立护城河的策略。
对于欧洲市场而言,数据主权与合规要求尤为突出。一家本土厂商提供强网络安全能力的模型,在面向政府、金融、关键基础设施等敏感行业时,可能比海外竞品更具信任优势。这既是技术层面的卖点,也是地缘与监管层面的差异化。
不过提一嘴,仅凭官方宣传的一句定位,还难以全面评估其真实实力。网络安全是一个攻防对抗性极强的领域,模型能力需要通过权威第三方评测、实战红蓝对抗以及真实部署案例来验证。所谓"全球最强之一"的表述,更多是营销语言,具体表现仍有待公开基准数据和独立测试支撑。
欧盟《AI法案》(AI Act)已于2024年正式生效,是全球首部系统性AI监管立法。该法案对"高风险AI系统"(包括关键基础设施安全、执法等领域的应用)提出了透明度、可解释性、数据治理等严格要求,违规最高可处全球营业额7%的罚款。与此同时,《通用数据保护条例》(GDPR)对数据跨境传输的限制,使得欧洲政府和金融机构在选择AI供应商时天然倾向于本土或欧盟内部署的方案。Mistral作为法国公司,其模型训练和推理基础设施位于欧盟境内,可以更直接地满足这些合规要求,这在实际采购决策中往往是一票否决级别的门槛,而非锦上添花的加分项。
值得关注的后续看点
基于目前有限的信息,有几个方向值得持续追踪:
- 评测透明度:Mistral 是否会公开其在网络安全相关基准(如漏洞检测、恶意代码分析等)上的具体成绩。
- 双刃剑风险:强大的网络安全能力同样可能被滥用于攻击端,厂商如何在能力开放与安全防护之间取得平衡。
- 企业落地案例:是否有真实客户在生产环境中部署并取得可量化的安全收益。
总体来看,Mistral Large 4 瞄准网络安全,是大模型走向专业化、场景化的一个缩影。对于关注AI在安全领域应用的从业者来说,这一动向值得保持关注,但更应等待实际数据和独立评测来检验其成色。
网络安全AI能力的评估目前缺乏统一的权威基准,现有的相关评测包括:专注于CTF(夺旗赛)题目自动求解的NYU CTF Bench、测试模型漏洞利用能力的CyberSecEval(由Meta发布)、以及聚焦恶意代码分析的MalwareBench等。这些基准各有侧重,且与真实攻防场景之间仍存在差距——实验室中能解题不等于能应对零日漏洞或APT攻击。Mistral若要坐实"最强网络安全模型"的定位,在这些公开基准上的表现将是首要参照,同时来自SANS、CrowdStrike等安全机构的独立红队测试报告,往往比厂商自测数据更具说服力。
相关推荐

AgentCore 实战:为智能体接入自定义工具与 MCP 服务器
DebuggerCafe 教程演示如何为 Amazon Bedrock AgentCore 智能体接入自定义工具与 MCP 服务器,突破默认工具集限制,并分析工具契约设计、MCP 复用价值及扩展后的工程注意事项。

816B参数只拿39分?开源大模型参数竞赛的性价比真相
Meta 816B Muse Spark Open 在 Artificial Analysis 仅得39分,180B Qwen3.8-Flash-Next 却拿到40分。本文解析11个开源权重模型的参数与分数关系,探讨激活参数、量化体积与部署成本的真实影响。

空中机械臂:无人机从「看」到「改」的下一步
从Reddit讨论出发,分析空中机械臂(Aerial Manipulator)的技术难点、潜在应用场景与落地瓶颈,探讨无人机从环境感知走向物理操作的关键挑战。