Mistral Large 4 实测:开源最强模型的真实编程能力几何

Mistral Large 4实测52.5分:可视化原型能力亮眼,但「跑完回合却不交付」是最大痛点。
这篇文章记录了一位开发者用自制的KingBench3基准,在OpenCode + OpenRouter真实工作流中对Mistral Large 4(Le Chonk)进行的八项编程任务实测,评分只看浏览器中可验证的最终交付物。结果呈现出鲜明的两极分化:电梯模拟(9.5/10)、折叠桌(8.5/10)和本地Gemma微调(10/10)等聚焦型可视化任务表现出色,尤其是端到端完成LoRA训练并自行修复服务器问题令人印象深刻。但隐形眼镜盒和计数题在默认运行中「用完回合却不交付任何文件」直接得零,三维腕表首次加载失败需要人工干预修复。最终综合得分42/80(52.5%),测试者的建议是:用于受控的可视化原型可以放心尝试,但对于需要无人值守运行的长流程工作,目前的可靠性仍不足以作为默认编程模型信任。
Mistral 新发布的 Large 4(代号 Le Chonk)在纸面规格上相当亮眼,但真正值得关心的问题是:它能否稳定完成实际交给它的编程任务?一位 B 站 UP 主用自己的 KingBench3 基准,把这款模型放进 OpenCode + OpenRouter 的真实工作流里跑了一遍,得出的结论比任何官方跑分都更有参考价值。
测试方法:只看交付结果,不看漂亮的解释
这次评测的核心原则很克制——只给最终交付的产物打分,而不是看模型「解释得多好」。测试者为每道题准备全新的空文件夹,复用此前测过其他模型的同一套八个 KingBench3 提示词,每题 10 分满分。
对于浏览器类项目,他会直接在 Chromium 里打开输出结果,检查页面是否正常渲染、主要交互是否真的能用。这个区分很关键:一个模型完全可以在结尾写出一段漂亮的总结,而页面本身却干着完全不同的事。换句话说,这套方法衡量的是「能不能把活干完」,而非「看起来像不像在认真思考」。
KingBench3 是测试者自行设计的私有基准,区别于 HumanEval、MBPP 等标准化代码生成基准的核心在于:它不以「代码是否通过单元测试」为评判标准,而是以「用户能否在真实浏览器/运行环境中实际使用产出物」为唯一依据。OpenCode 是一个开源的 AI 编程 agent 框架,负责在本地环境中接收提示词、调用模型 API、创建文件、执行代码;OpenRouter 则是一个模型 API 聚合中间层,允许用同一套接口调用来自不同提供商的模型。这套组合代表了目前较主流的「本地 agent + 远程模型」工作流,比直接在聊天界面测试更接近开发者实际使用场景,因此暴露的问题(如回合耗尽、文件未创建)也更贴近真实痛点。
擅长的部分:聚焦型可视化任务表现亮眼
当任务范围明确、聚焦于单一可视化目标时,Le Chonk 的表现相当出色。
电梯模拟(9.5/10) 要求三部电梯、每部仅容一人、乘客在不同楼层生成、悬停显示目的地、落单者自动乘下一部电梯。模型交付了干净的建筑视图、三部带开门动画的电梯、乘客计数和生成按钮,队列逻辑真实可用。测试者重置后生成五名乘客运行,等待与乘坐计数都正常归零,浏览器无报错。唯一的小瑕疵是重置时残留旧行程的退出动画,以及等待计数会在乘客实际进入前略微提前变化——不影响主流程,但足以让它与满分失之交臂。
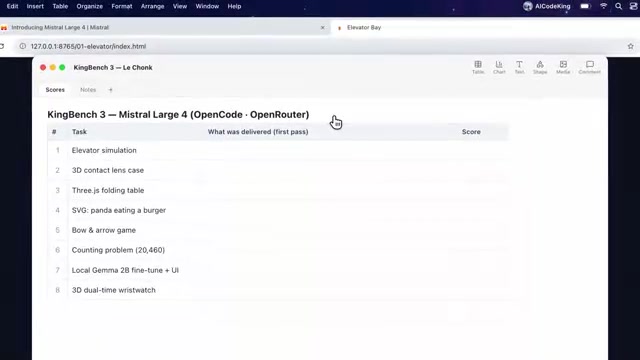
折叠桌(8.5/10) 加载了完整的 Three.js 场景,包含光照、材质、阴影、轨道控制和滑块。拖动滑块可实现从紧凑折叠到完全展开的连续三维控制,两种状态在浏览器中都无报错渲染。中段动画略有瑕疵(桌脚会离地、模型偏小),但核心需求完整实现。
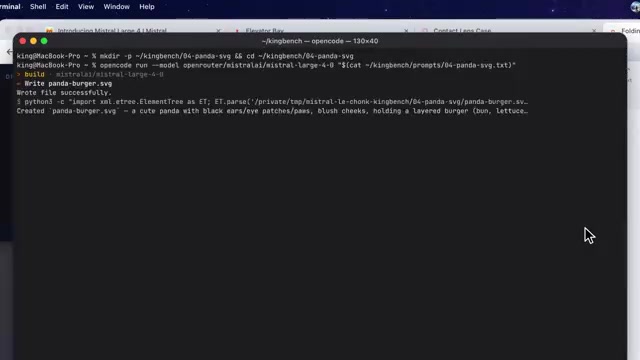
熊猫吃汉堡 SVG(8/10) 生成了渲染清晰的有效 SVG,熊猫、汉堡、爪子和张开的嘴都清晰可辨。弱点在于「吃」这个动作——汉堡紧贴嘴边,却看不出真正的咬合动作,让主题稍显模糊。
最令人印象深刻的是本地微调任务(10/10):生成熊猫知识数据集、本地微调 Gemma 20 亿参数模型、并做一个每次刷新给出新知识的网页。启用缓存模型权限后,Le Chonk 完整走完全流程——生成 510 条样本、训练 400 步 LoRA 适配器、将验证损失从约 7.97 降到 0.31,甚至在自己的端到端测试中发现并修复了服务器线程问题。测试者在 Chromium 中多次刷新,每次都得到不同的熊猫知识且无报错,模型与网页全部本地运行。对于一个涉及如此多环节的任务,这是相当强的结果。
LoRA(Low-Rank Adaptation)是一种参数高效微调方法,其核心思想是冻结预训练模型的绝大部分权重,只训练插入各层的低秩矩阵,从而以极少的可训练参数(通常不足原模型的 1%)实现领域适配。验证损失从 7.97 降至 0.31 表明模型对新数据集的拟合程度显著提升——这一降幅在 400 步训练内完成,说明任务数据量(510 条样本)与模型规模(Gemma 2B)匹配良好。在本地完成此类端到端流程需要正确配置 Python 环境、依赖库(如 Transformers、PEFT)、GPU/CPU 训练参数以及模型权重缓存路径,任一环节出错都会导致流程中断,因此 Le Chonk 能自行发现并修复服务器线程问题、最终跑通全流程,确实展现了对复杂多步骤任务的较强处理能力。
短板暴露:可靠性与「不交付」问题
问题恰恰出在稳定性上。
隐形眼镜盒(默认 0/10) 本应生成带 L/R 分区、点击可开盖的三维盒子。但在默认 OpenCode 运行中,模型用完整个回合推理「这个盒子该怎么做」,最后却没有创建任何文件——没有可打开或点击的产物,直接得零分。测试者强调,他不会把「计划」当成「成品」来打分。有意思的是,换用 OpenCode 的「无推理」模式重跑,模型确实做出了盒子,左右盖能独立打开(虽然飞得太高、部分出框),说明它有能力完成,但默认运行的可靠性缺陷依然应得零分。
计数题(0/10) 正确答案是 20,460。在默认会话中,模型再次耗尽回合却没有给出最终答案,无从评判。
射箭游戏(6/10) 做出了完整的游戏画面——四种靶子、风向指示、箭矢物理、命中追踪、浏览器本地保存的排行榜,运行无 JS 报错。但靶子在桌面尺寸下只有几个像素宽,位置固定导致手机上远靶会移出屏幕,瞄准辅助线也与弹道拖拽不完全匹配。系统都在,但要称得上「好玩」还需再打磨一轮。
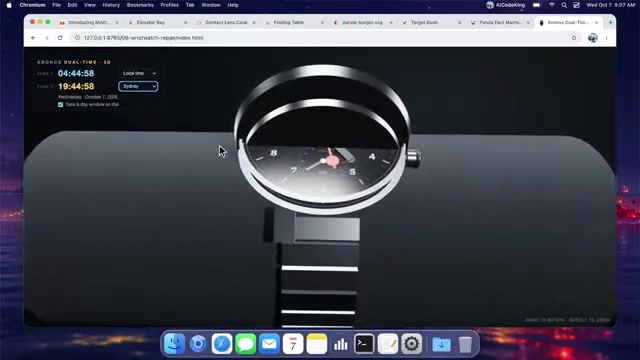
三维腕表(修复后 6/10) 首次检查时页面空白、时间显示仍是占位符横线,根因是 import map 请求了模型从未创建的模块路径——一块永远加载不出来的表当然得零分。但测试者把浏览器报错原封不动交给同一模型,它成功修复了路径,第二次检查得到了可渲染的三维时钟、走动的秒针和可切换的第二时区。这个「自我修复」过程被认为比一张破损截图更有说服力。
「用完回合」是指 agent 框架为单次任务设定的最大交互步数(turn/step limit)耗尽后强制终止。在 OpenCode 这类 agent 中,模型每次工具调用(读写文件、执行命令、搜索文档)都消耗一个步数配额。当模型在规划、反复修改或陷入循环时,配额在实际产出之前就耗尽,导致任务以「什么都没创建」结束。这一问题在推理模型(Reasoning Model)上尤为突出:模型倾向于在内部进行大量链式思考,而这些思考步骤本身也会消耗 agent 的行动配额。「无推理」模式(no-reasoning mode)关闭了这一扩展思考过程,使模型更快进入实际代码生成阶段,因此在隐形眼镜盒重试中反而成功交付了产物。这也提示使用者:对于较复杂的 agent 任务,合理设置步数上限和推理模式是影响成功率的关键配置项。
最终评分与现实判断
修正权限问题后,Le Chonk 的总分是 42/80,即 52.5%,折合 5.25/10。测试者将隐形眼镜盒的重试和腕表的修复排除在总分外(因为是初始输出之后的单独尝试),但微调任务的重跑计入,因为最初的中断源于他自己的 OpenCode 权限设置,归咎于模型并不公平。
真正的洞察在于那种鲜明的反差:当 Le Chonk 完成一个聚焦的可视化任务时,它能做出相当漂亮的东西——电梯真实可用、折叠桌精致、熊猫 SVG 可爱、本地 Gemma 微调证明它能在环境配置正确时走完长流程。但隐形眼镜盒和计数会话以「无可用答案」告终,腕表需要浏览器测试后的修复。这些正是你把任务交给 agent 后去忙别的、回来却发现没干完的「工作流痛点」。
测试者也诚实地提醒:不应把这一次运行变成普适的模型排名,这只是他在特定 OpenCode + OpenRouter 配置下的提示词与可验证结果。他的建议务实而清晰——用于受控的可视化原型,可以放心尝试,但记得把浏览器和测试循环放在手边;对于更长、更不容错的工作,他想先看到它稳定完成,才会信任它作为默认的编程模型。
对实际使用者来说,决定性因素始终是同一个:你能多频繁地把一个任务交给它,然后拿回一个真正能用的东西。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。