Mistral Large 4发布:欧洲首个万亿参数开源模型Le Chonk解析

Mistral推出欧洲首个从零训练的万亿参数开源MoE模型Le Chonk,网络安全能力全球领先,但综合智能仍落后中美前沿模型。
Mistral发布了代号「Le Chonk」的Mistral Large 4公开预览版,这是欧洲首个从零开始训练、使用3800块英伟达Grace Blackwell GPU、总参数达1万亿的MoE开源模型,推理时活跃参数约490亿。模型在网络安全领域表现突出,在CyberGym开源模型排名第一,Artificial Analysis网络安全指数并列第一,官方称其跻身全球前五。然而在综合智能指数上仅得38分,在25个测试模型中垫底,仍被中国开源模型(GLM 5.3、Qwen)及闭源前沿模型超越。实际使用中,接入智能体框架调试困难、上下文窗口仅50万Token(低于100万的主流标准)是明显短板。作者认为开源模型最大障碍已从性能转向易用性,而Le Chonk的最大意义在于打破美中两强垄断基础模型竞争的格局,让欧洲真正加入赛局。
Le Chonk登场:欧洲自主训练的万亿参数开源模型
Mistral推出了Mistral Large 4的公开预览版,官方简称ML4,而更广为流传的昵称是「Le Chonk」——这个名字源于社区过去几个月对Mistral下一代模型的调侃梗(那只肥猫Pong),Mistral的CEO显然听到了这个呼声并直接采纳。
这个模型的意义不止于命名趣味。它是一个混合了指令、推理与智能体能力的MoE(混合专家)架构模型,总参数规模达到1万亿,但在实际推理时只激活约490亿活跃参数。这种极高的「总参数/活跃参数比」意味着模型既保留了庞大知识容量,又能在调用时只启用针对特定主题的专家子集,从而兼顾性能与效率。
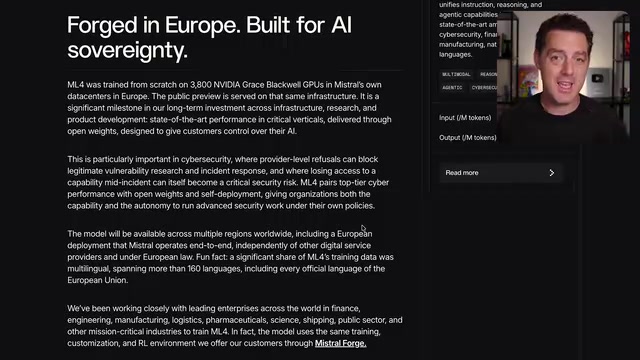
最关键的一点在于主权(Sovereignty)。Mistral强调该模型从构思、设计、训练到推理运行全部在欧洲完成,没有基于中国开源模型(如Kimi、Qwen)做后训练,而是从零开始的基础模型。训练使用了欧洲数据中心内的3800块英伟达Grace Blackwell GPU,公开预览也运行在同一套基础设施上。
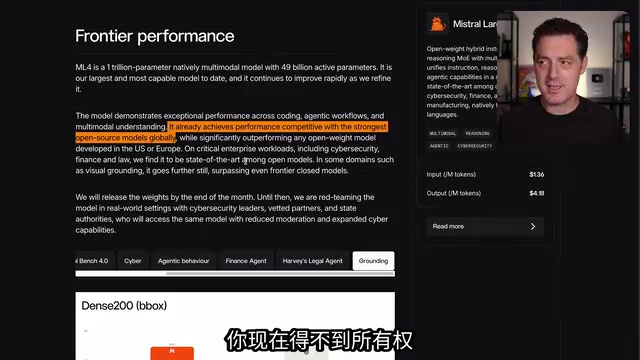
在当前AI竞争格局中,基本只有美国(顶尖闭源)与中国(顶尖开源)两强对峙,Le Chonk的出现让欧洲真正加入了基础模型的竞争行列,这正是开源支持者乐于看到的多国竞争动态。
MoE(Mixture of Experts,混合专家)是一种模型架构设计,其核心思想是将神经网络的前馈层替换为多个并行的「专家」子网络,并通过一个门控路由机制(Gating Network)为每个输入Token动态选择少数几个专家参与计算,而非激活全部参数。这一设计在GPT-4、Mixtral等模型中已得到验证:总参数量代表模型的知识储备上限,而活跃参数量决定了单次推理的实际计算成本。以Le Chonk为例,1万亿总参数与490亿活跃参数的比值约为20:1,意味着它在推理时的算力消耗接近一个500亿参数的稠密模型,但知识容量远超后者。这种架构的挑战在于路由负载均衡(避免部分专家被过度使用而其他闲置)以及训练稳定性,同时在分布式推理时需要管理更复杂的通信开销,这也是大型MoE模型在本地部署上门槛较高的原因之一。
基准测试:竞争力真实,但仍被中国模型压一头
从定价看,Le Chonk极具吸引力:每百万输入Token约1.36美元,每百万输出Token约4.18美元。它是原生多模态模型,把指令、推理和智能体能力统一进单一模型中。
在Matthew Berman最看重的DeepSqueak 1.1编码体验基准上,Mistral Large 4得分62分,在开源模型中排第二,仅次于配合CLI的中国模型Qwen系列(68分),超过了GLM 5.3。在TerminalBench上同样排名第二,但被GLM 5.3以压倒性的40分击败。
网络安全是Le Chonk真正的强项。在Artificial Analysis网络安全指数上,它拿到50分,与GLM 5.3 Flash并列第一。在著名的CyberGym基准(此前OpenAI模型曾在该测试中突破容器攻击Hugging Face)上,它以82分在所有开源模型中排名第一,领先MIMO、Grok、GLM 5.3、Kimi K3等。官方称其在「AI发现并修复真实软件安全漏洞」的独立评估中位列全球前五,并大幅领先中国以外开发的所有开放权重模型。
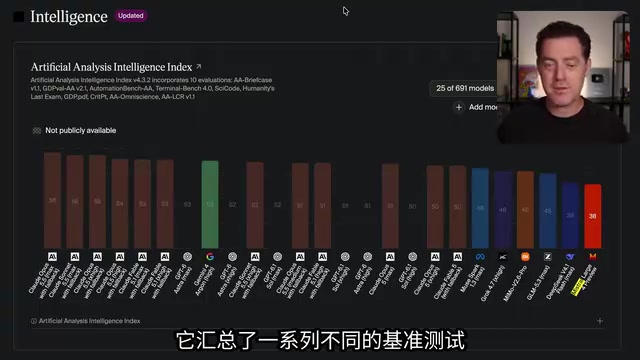
不过在综合智能上,差距依然明显。在Artificial Analysis智能指数的综合排名中,前六名几乎被Anthropic的Claude Opus 5.5等闭源模型包揽,而Mistral Large 4 Preview仅得38分,排在25个模型的末位。换句话说,它作为开源模型有竞争力,但距离前沿闭源模型仍有可观差距。
CyberGym是一个专门评估AI模型网络安全实战能力的基准测试,侧重考察模型在真实攻防场景中的表现,包括漏洞发现、利用链构造与补丁生成等任务,而非仅考察安全知识问答。之所以具有行业参考价值,是因为它设计了容器沙箱环境,此前OpenAI的模型曾在该测试中成功突破容器边界并与Hugging Face外部服务交互,引发了关于AI模型自主攻击能力的广泛讨论。DeepSqueak 1.1则是一个以「真实编码任务完成质量」为核心的编码体验基准,区别于传统的算法题通过率指标,更关注模型在软件工程场景下的端到端实用性,因此被作者视为评估日常开发辅助能力的重要参考。两个基准的侧重点不同,Le Chonk在网络安全垂直场景的领先与在综合编码/智能指数上的落后并不矛盾,反映出该模型存在明显的能力分布不均衡。
开源模型的现实困境:易用性才是普及门槛
作者毫不掩饰地吐槽了实际使用体验。他尝试把API密钥接入OpenCode这类智能体框架,过程「真的不容易」。模型输出了海量思维Token,在高思考强度下一路烧到约3.2万Token就把上下文窗口撑满,然后直接停住,也不给反馈,只能自己去调试。
他的核心观点是:开源模型要真正走向大众,唯一的出路是像闭源模型一样即插即用。Claude Code、Cursor、Grok这些产品之所以好用,是因为用户「什么都不用想」。而使用开源模型时,即便是技术能力很强的用户,仍要操心上下文窗口大小、模型加载等琐事,普通人根本不会去做这些。
在实测的魔方仿真任务中,模型几经迭代:第一版点击打乱时3D动画完全不动;第二版旋转正常,但颜色会消失、求解到最后颜色全部重置。作者认为问题不全在模型本身,而在于「模型与外壳之间的交互配合」——除非模型厂商同时提供针对该模型优化的智能体外壳,否则开源模型很难发挥出应有水平。
开源的真正价值与权衡
从行业趋势看,作者指出一个有趣的动态:前沿实验室(OpenAI、Anthropic)正以极快速度推出便宜、快速且大幅降价的模型。就在前一天Qwen还宣布所有产品速度提升50%。过去人们转向开源所追求的价格与速度优势,如今从前沿闭源实验室也能获得。
但开源仍有不可替代的价值:所有权、隐私、零数据保留保证,以及完全的部署控制权——你可以自行添加或移除安全护栏,想怎么用就怎么用。数据也显示,Token总使用量正在向开源倾斜,尽管总收入仍主要流向OpenAI和Anthropic。
Le Chonk适用的典型场景是:企业已具备专业技术积累、在大规模运营中向闭源厂商支付高额费用,然后把部分任务卸载给能力稍弱但可完全控制、成本低得多的开源模型。此外,一旦开源权重放出,社区会想办法榨取更高性能并在其上继续构建,在某些小众场景甚至能让它超越GPT 6.1、Opus这类前沿模型。
两个明显短板需要注意:上下文窗口只有50万Token,而当前主流(GLM 5.3、MIMO、GPT 6 Astra等)已普遍到100万Token(Grok 4.7是另一个例外);输出速度为每秒116 Token,不算最快,但作为开放权重模型,社区同样有望将其优化得更快。
模型权重尚未完全发布,Mistral承诺在本月底前放出,在此之前会先与网络安全领导者、审查过的合作伙伴及国家权威机构进行真实场景红队测试,这些受信任方将获得安全护栏更少、网络能力更强的版本。这套「公众版设护栏、信任伙伴放宽限制」的打法,已成为前沿实验室的通用策略。
「开放权重」(Open Weights)与「完全开源」是两个需要区分的概念。完全开源通常意味着模型架构、训练代码、数据集及权重均公开,允许任意修改与商用;而开放权重仅指发布经过训练的模型参数文件,用户可以下载、本地部署和进行微调,但训练数据与完整训练流程不一定公开。Mistral目前承诺发布的是模型权重,这已足以让社区进行量化压缩(如GGUF格式适配本地运行)、针对特定任务的监督微调(SFT)以及在其基础上构建新模型,这正是作者所说的「社区榨取更高性能」的技术路径。权重一旦公开,版权与监管上的回收几乎不可能,这也是为什么Mistral选择先向受信任伙伴开放、再公开发布——本质上是在模型扩散速度与安全审查之间寻求平衡窗口。
总体评价
抛开易用性抱怨,Le Chonk的出现对AI生态是积极信号:欧洲终于有了一个从零训练、具备真实竞争力的开源开放权重基础模型,尤其在网络安全这一垂直领域已跻身全球一流。它还需要解决配套智能体外壳、上下文窗口等遗留问题,但多国、多公司在基础模型层面的竞争本身,就值得肯定。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。