Mistral Large 4发布:通用智能体直达成品交付

Mistral Large 4 定位通用智能体旗舰,主打从信息收集到成品交付的端到端工作流,但技术细节尚待披露。
Mistral 发布的 Large 4 模型以「通用型智能体」为核心定位,强调能够在复杂工作流中自主完成从信息收集到成品交付的全链条任务,而非仅停留于对话问答。这一方向折射出行业竞争焦点正从模型参数与基准分数向智能体执行能力演进的整体趋势。「finished deliverables」这一表述尤为关键,意味着模型输出需达到可直接落地使用的标准,对企业用户而言可显著减少多环节人工后处理成本。然而,当前官方公开的信息十分有限,缺乏基准测试数据、上下文长度及工具调用机制等技术细节,「通用智能体」的实际落地能力与营销表述之间是否存在差距,仍需等待后续技术文档与第三方实测验证。
Mistral Large 4:从信息收集到成品交付的通用智能体
Mistral 推出的 Large 4 模型,核心定位是驱动「通用型智能体」(general-purpose agents)。据官方描述,这类智能体能够在复杂工作流中自主收集信息,并最终产出可直接使用的成品交付物(finished deliverables)。这意味着模型的角色从单纯的「对话问答」向「任务闭环执行」转变。
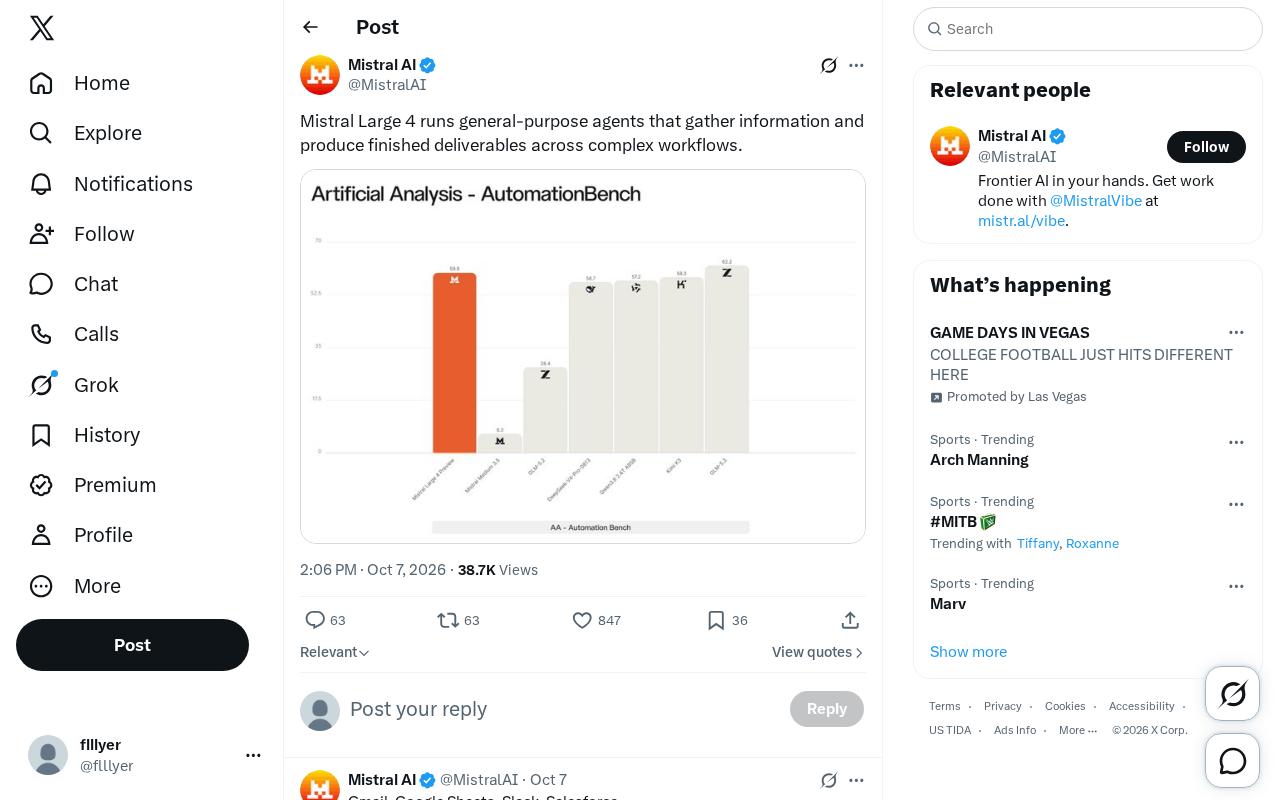
从这条简短但信息密度不低的发布内容看,Mistral 想要强调的不是单点能力,而是端到端的工作流覆盖——即一个智能体可以从接到任务开始,经历调研、整理、生成等多个环节,直到交付一份完整的结果。
为什么「通用智能体」是关键词
从单任务到跨流程
过去一年,大模型厂商的竞争焦点正在从「模型参数与基准分数」转向「智能体执行能力」。所谓通用型智能体,强调的是不局限于某个垂直场景,而是能适配多种复杂工作流。Mistral Large 4 把「information gathering(信息收集)」与「produce finished deliverables(产出成品)」并列,恰好指向了智能体工作的两个关键阶段:输入侧的信息获取与输出侧的成果生成。
智能体执行能力的核心挑战在于「规划-调用-反馈」的闭环:模型需要将一个高层目标分解为子任务,在执行过程中调用外部工具(如搜索、代码解释器、文件读写),并根据中间结果动态调整后续步骤。这与传统的单轮问答有本质区别——单轮问答只需生成一次文本,而智能体工作流可能涉及数十次工具调用和状态判断。当前业界在这一方向上已形成若干技术路线,包括 OpenAI 的 Function Calling、Anthropic 的 Tool Use,以及 ReAct(Reasoning + Acting)等提示范式。Mistral 自 2024 年起也在其 API 中支持函数调用能力,Large 4 的发布暗示其在多步骤任务执行的稳定性上有进一步投入。
「成品交付」意味着更高的标准
值得关注的是「finished deliverables」这一表述。它暗示输出不再是一段半成品文本或零散建议,而是可交付、可落地的结果——例如一份完整报告、一套方案或结构化文档。对企业用户而言,这类能力的实际价值在于减少人工后处理的工作量,让模型承担更长链条的任务。
对开发者与企业的潜在影响
对于希望构建自动化流程的团队来说,一个能够贯通「调研—处理—交付」的模型,可以显著降低多环节拼接的工程成本。传统做法往往需要用多个工具、多次调用来串联工作流,而通用智能体的目标是把这些环节内聚到单一模型驱动的流程中。
Mistral 作为欧洲代表性的开放大模型厂商,其模型迭代一直受到开发者社区关注。Large 系列定位于高性能旗舰,Large 4 若在智能体执行、长流程稳定性上有实质提升,将为企业级 Agent 应用提供新的选择。
需要理性看待的部分
当前可获取的官方信息较为简略,仅给出了功能定位的高层描述,尚未披露具体的基准测试数据、上下文长度、工具调用机制等技术细节。「通用智能体」在营销表述与真实落地之间通常存在差距——复杂工作流的自主执行对模型的规划能力、错误恢复能力和工具协同能力都提出很高要求。这些能力到底表现如何,仍有待更详细的技术文档与第三方实测验证。
评估一个模型的智能体能力通常依赖专项基准,例如 SWE-bench(测试自主代码修复能力)、GAIA(测试现实世界多步骤任务推理)以及 τ-bench(测试工具调用准确性)。这些基准比通用文本生成评测更能反映模型在真实自动化场景中的表现。目前 Mistral 尚未公布 Large 4 在上述基准上的成绩,也未说明其最大上下文窗口大小——而上下文长度对于需要处理大量检索信息的智能体工作流至关重要。建议在官方技术报告或第三方独立评测发布后,重点关注这几项指标。
小结
Mistral Large 4 把发布重点放在「通用智能体」与「成品交付」上,反映了行业从模型能力竞争向智能体应用竞争演进的趋势。它的实际价值将取决于在真实复杂工作流中的稳定性与交付质量,建议开发者结合官方后续发布的技术细节和实测结果再做评估。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。