Mistral开放万亿参数模型,微软披露OpenAI百亿收入

Mistral开放万亿MoE权重,腾讯预告视觉模型,微软披露OpenAI收入,Claude模式将移除。
本期汇总六条AI动态:Mistral开放万亿参数MoE模型Large 4权重,支持图文输入,主打代码与网络安全,但商用需授权;腾讯预告i4与Hi4 Flash,首次加入视觉理解;微软财报披露与OpenAI商业安排带来约100亿美元季度收入,含收入分成但未拆分云服务占比;Claude Opus 4.8快速模式将于11月30日移除,需迁移至Opus 5.5;OpenAI更新Model Spec,承认模型尚未完全达标;英伟达开源Canary 3.5 Transcribe语音转写模型,支持说话人分离,BF16部署需约120GB显存。文章提醒,不少消息是计划或预告,开源许可、API兼容性与硬件成本是开发者需提前核对的变量。
开源阵营再添重量级选手:Mistral Large 4 开放权重
10月29日,Mistral 开放了名为 Large 4 的权重模型(素材中音译为「Maestro」)。这是一款万亿参数级别的混合专家(MoE)架构模型,官方称其在处理每个词元时只调用部分专家网络,兼顾了规模与效率。模型支持图文输入、文本输出,从头在欧洲基础设施上训练,主打代码与网络安全场景,并自称是「编程最强的开放权重模型」——当然,这一判断来自特定评测,实际效果仍需开发者用自己的代码任务独立验证。
需要注意许可限制:该模型采用修改后的许可证,企业商用前需要获得授权。因此下载前先看清许可证条款,再决定是自行部署微调,还是选择托管服务。开放权重不等于无条件商用,这条红线开发者务必留意。
混合专家(MoE)架构:MoE 是一种将模型拆分为多个“专家”子网络的架构,每个词元(token)仅由路由机制选择其中少数专家参与计算。这样模型总参数量可以做得极大,但单次推理的激活参数和算力开销远小于同等总参数量的稠密模型。Mistral Large 4 号称万亿参数级别,正是依靠稀疏激活来平衡规模与推理成本。需要注意的是,“总参数”与“每次激活参数”是两个概念,后者才更直接决定推理显存与延迟。
开放权重(Open Weights):指模型训练完成后的参数文件可被公开下载,开发者能自行部署、微调甚至再分发。它与“开源”并不完全等同——训练数据、代码和训练流程未必公开,且许可证可附加商用限制。因此文章强调“开放权重不等于无条件商用”,企业使用前必须逐条核对许可条款。
腾讯混元预告新模型:首次加入视觉理解
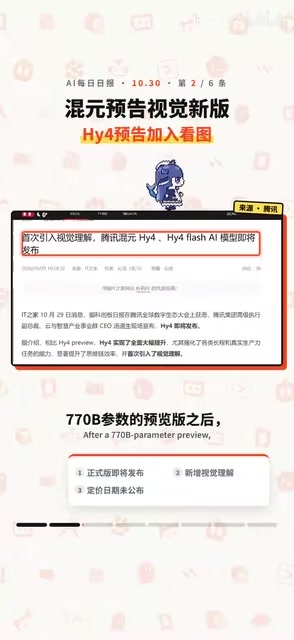
据科创板日报转述,腾讯在开发者大会上预告了新模型 i4,官方称其强化了长程任务和真实生产力任务,并提升了思维链效率。所谓「首次加入视觉理解」,是相对此前的预览版而言,不能扩大解读为腾讯所有模型都未曾具备视觉能力。
同期预告的还有主打性价比的 Hi4 Flash,官方称会继承视觉和智能体能力,走「模型与产品一起设计、持续迭代」的路线。但具体开放日期、收费方式以及视觉测试成绩,两篇报道均未给出,目前能力提升只能按官方说法转述,实际效果还得等正式发布后验证。
微软财报里的OpenAI账本:季度收入约100亿美元
10月28日,据相关财经媒体报道,微软财报文件披露了一组数据:对应截至9月30日的季度,微软与 OpenAI 的商业安排带来约100亿美元收入,其中包含收入分成。但文件没有拆分收入分成与云服务各占多少,因此不能把这100亿美元全部算作云计算收入。
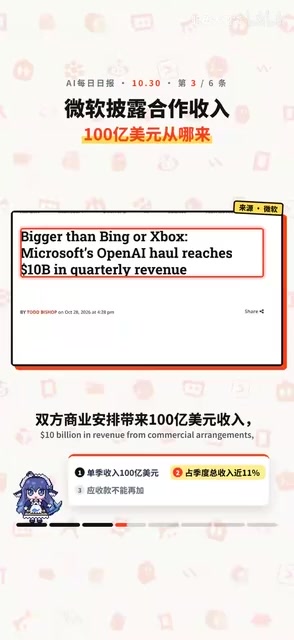
另一个值得关注的数字是营收款:截至9月底为72亿美元,高于6月底的60亿美元。这是已发生交易但尚未收回的钱,不能当作新增收入重复计算。文件同样没有披露这些业务对应的利润,也没说营收款是否已全部收回。看这笔合作账,要把收入、营收款和业务构成分开理解,文件留白之处就是明确的不确定性。
Claude Opus 4.8快速模式将于11月30日移除
9月30日 Cloud 平台更新日志公布了弃用安排:11月30日起,针对 Claude Opus 4.8 快速模式的请求会报错。这意味着现有程序需要核对模型与速度参数,不能只看模型名称是否拼对——如果代码里仍指定该模型并要求快速处理,就会收到错误。官方建议迁移到 Claude Opus 5.5。
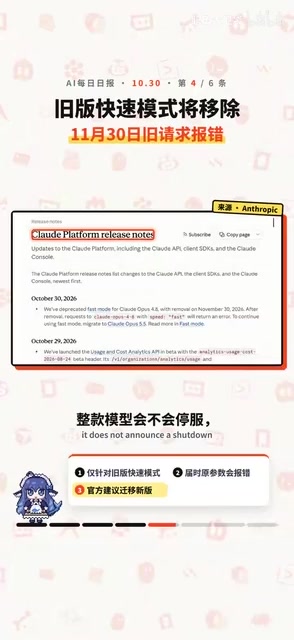
需要厘清的是,这次移除的是「快速模式」,而非整款模型停服。官方公告并未宣布 Opus 4.8 本体下线,依赖该模型的常规请求是否受影响,原文没有进一步说明,建议以官方页面为准。
OpenAI更新Model Spec:承认模型尚未完全达标
10月29日,OpenAI 发布文章更新 Model Spec(模型规范),10月30日媒体报道。官方强调模型应忠实于人的意图,并减少伤害、保持诚实透明、尊重人的自主与关怀。具体做法包括理解用户想完成什么、在指令没写全时依据对话和记忆中的上下文做出合理判断,同时加强对行动负作用的说明。
说个细节,官方撤下了此前偏结构化、说教化的文风指导,改为适应用户偏好,但这不等于用户要求都能照做,安全边界依然存在。官方明确表示,这份规范描述的是努力方向,模型目前还没有完全符合它——它可以当作观察模型行为的公开标尺,而不是效果已经兑现的证明。
Model Spec(模型规范):是 OpenAI 公开发布的、描述模型应如何理解指令、处理冲突优先级和遵守安全边界的文档。它类似一份“行为准则”,用于指导训练与评估,同时向外界提供审视模型行为的公开标尺。规范中通常会定义指令层级(如平台规则高于用户指令)、诚实性与有用性的权衡等原则。官方承认模型尚未完全符合规范,意味着这份文档是努力目标而非现状保证,读者不宜将其当作模型能力已兑现的证明。
英伟达开源语音转写模型:能标注谁在说话
10月28日,英伟达发布开源全重模型 Canary 3.5 Transcribe。官方称其可转写最长一小时录音,返回带时间戳的结果,并支持说话人分离(标注谁在说话),还能按需切换逐字记录、书面整理或翻译等输出风格。模型名中的 30B 指完整总参数量约340亿,结合音频编码器处理声音,每次推理约激活43亿参数。
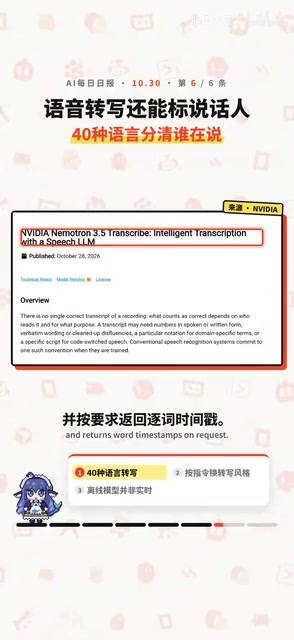
硬件门槛需要算进去:官方列出 BF16 部署配置需要约120GB显存。同时官方明确这是离线模型,不应期待「快等于实时」——用于会议字幕等场景前,先测试噪声、口音、说话人切换和人名识别,成稿仍建议人工复核。
说话人分离(Speaker Diarization):指在多人对话音频中自动判断“谁在什么时间说话”,并将转写文本按说话人分段标注的技术。它通常与语音识别(ASR)串联:先检测语音活动、切分说话人片段,再分别转写并合并时间戳。说话人分离对会议记录、访谈整理等场景尤为关键,但在说话人重叠、口音差异大或背景噪声强时错误率会明显上升,因此文中建议成稿前人工复核。
六件事里的两条主线
这批消息可归为两类:一类是开放模型与产品预告,包括 Mistral Large 4、腾讯 i4 与 Hi4 Flash、英伟达语音模型;另一类是商业与规则变化,包括微软披露的 OpenAI 相关收入、Claude 快速模式移除、OpenAI 规范更新。其中不少是「计划」或「预告」,而非正式落地,具体以官方页面为准。开源模型的商用许可、API 参数兼容性、以及硬件成本,是开发者最需要提前核对的三个变量。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。