MIT学者聚焦AI如何重塑人类社会与高等教育
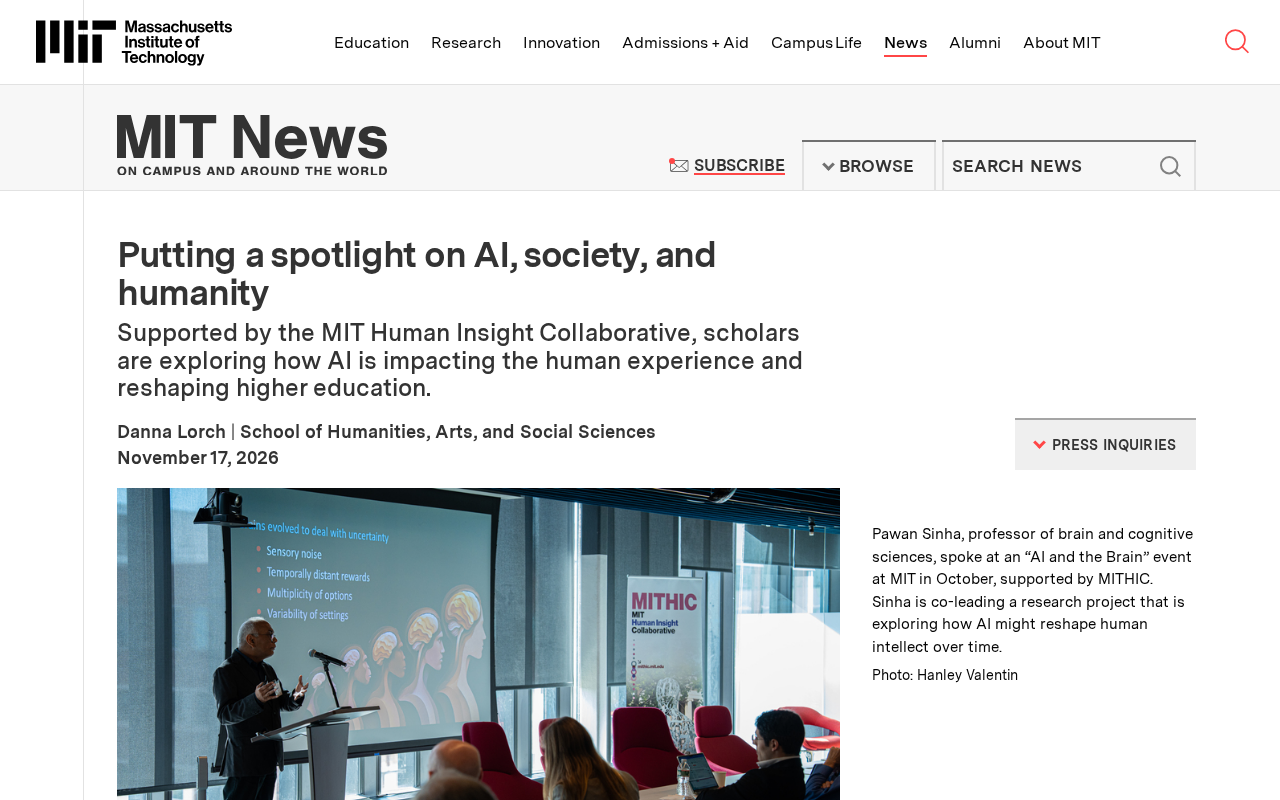
MIT研究计划聚焦AI如何重塑人类经验与高等教育结构。
MIT Human Insight Collaborative 支持的一项研究计划,将目光投向 AI 与人类经验的交叉地带。文章指出,公共讨论多聚焦模型能力与商业落地,而该计划更关心 AI 介入决策、学习与创作后,人的主体性、判断力与情感连接如何变化。高等教育被视为观察 AI 社会后果的关键窗口:课程设计、学术诚信、评估方式与师生关系都在技术冲击下被迫重审。研究强调跨学科协作,把人文社科追问带入技术讨论核心,并提醒衡量进步的标尺不应只有 benchmark 分数,还应包括教育公平、认知多样性与社会信任的长期影响。

人工智能正在从实验室走向社会肌理,它不仅改变着技术流程,也在重新定义"人"的体验与知识的传承方式。MIT Human Insight Collaborative 支持的一项研究计划,正将目光投向这个交叉地带:AI 如何影响人类经验,又如何在高等教育中掀起结构性变化。
AI 与人类经验:不只是效率问题
当公共讨论大多围绕模型能力、参数规模与商业落地时,MIT 的学者们选择了一条更贴近人文的路径。他们关心的不是 AI 能否完成任务,而是当 AI 介入日常决策、学习与创作之后,人的主体性、判断力和情感连接会发生什么变化。
这种视角的价值在于,它把"技术影响"从抽象的性能曲线拉回到具体的生活场景。AI 在教育中的角色尤其典型:它既可能成为个性化学习的助手,也可能削弱师生之间不可替代的言传身教。研究计划并未给出非黑即白的结论,而是试图建立一套理解人机共生关系的分析框架。
Human Insight 在 MIT 的语境中并非泛指“人文关怀”,而是指向一个具体的研究取向:把人类的感知、判断、情感与意义建构视为可被技术影响、也需要被技术设计所尊重的对象。这一取向与认知科学、现象学、教育学中的“具身认知”(embodied cognition)传统相关——该传统认为人的理解并非纯粹的信息处理,而依赖身体经验、情境与社会互动。当 AI 介入学习与创作时,它可能绕过这些具身过程,直接给出结果,从而改变人形成判断的路径。因此研究者关注的“人类经验”问题,实质是在追问:哪些认知与情感过程值得被保留为“人来做”,哪些可以交由机器辅助,以及这种分工如何影响人的能力发展。
高等教育作为AI社会影响的试验场
大学既是 AI 研究的策源地,也是其社会后果最先显现的地方。MIT Human Insight Collaborative 支持的学者们将高等教育视为观察 AI 重塑人类经验的关键窗口——课程设计、学术诚信、评估方式、师生关系,都在技术冲击下被迫重新审视。
一个值得关注的张力是:高校一方面要培养学生使用 AI 的能力,另一方面又要守护那些无法被自动化替代的人类素养。这种张力不是靠一纸政策就能消解的,它需要持续性的跨学科研究来提供依据。MIT 这项计划的意义,正在于把人文社科的追问带入技术讨论的核心,而不是让伦理与社会影响成为事后补丁。
学术诚信与评估方式在生成式 AI 普及后成为高校制度调整的前沿。传统评估假设学生独立完成写作、解题与代码,而大模型使“代笔”难以被常规手段识别,迫使高校从“检测 AI 使用”转向“重新设计评估”——例如增加过程性评价、口头答辩、课堂内写作与项目制考核。这一转变不只是技术应对,更涉及对“学习究竟意味着什么”的重新定义:如果最终产出可由机器生成,那么教育应考核的是提问、判断、整合与反思的能力。MIT 等院校的讨论表明,评估改革往往先于明确的政策共识出现,成为观察 AI 如何重塑学术制度的具体切口。
跨学科协作的研究信号
从目前披露的信息看,该计划强调学者从各自学科出发,共同审视 AI 的社会维度。这意味着研究不会停留在"AI 会不会取代人类"的浅层争论,而是深入到制度、文化与认知层面。对于关注 AI 长期影响的人来说,这是一个值得跟踪的学术动向:它把"人类洞见"(Human Insight)放进项目名称,本身就传递了一种立场——技术发展需要以人的经验为锚点。
在 AI 能力快速迭代的背景下,这类研究提醒我们,衡量进步的标尺不应只有 benchmark 分数,还应包括它对教育公平、认知多样性和社会信任的长期影响。
**Benchmark(基准测试)**是 AI 领域衡量模型能力的标准化评测集,如语言理解、数学推理、代码生成等任务上的得分。它推动了模型间的可比性与快速迭代,但其局限也日益被讨论:benchmark 分数主要反映特定任务上的表现,难以捕捉模型在真实教育场景中对学习者认知、动机与人际关系的影响。文章强调“衡量进步的标尺不应只有 benchmark 分数”,正是提醒读者区分“模型能力指标”与“社会影响指标”——后者需要长期追踪、定性研究与跨学科方法,而非单次评测即可得出。
相关推荐

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。