模型压缩如何加剧Whisper语音识别的群体偏差

模型压缩会系统性加剧语音识别的群体不公平,全精度审计无法捕捉这一问题。
这项研究揭示了AI公平性评估流程中的结构性盲区:企业通常在全精度模型上完成公平性审计,但实际部署的是量化、剪枝或蒸馏后的压缩版本。研究在Whisper模型家族上跨三个数据集的实验表明,50%的Wanda剪枝会使黑人/非裔美国人与亚裔群体之间的词错误率差距扩大111%,即便采用束搜索解码仍残留86%的增长;INT4 HQQ量化则将西非口音上的灾难性转录循环放大5到7倍。唯一例外的是蒸馏——在27个评估设置中的21个里,蒸馏实际缩小了群体差距。研究的核心警示是:效率优化从来不是中性的技术决策,它会悄然将额外的错误负担转嫁给已处于边缘的语音群体,公平性审计必须在实际部署的压缩模型上进行。
全精度公平性审计的盲区
自动语音识别(ASR)模型在部署前通常会经过公平性审计,评估其在不同人群中的表现是否均衡。但这些审计往往针对的是全精度模型——而真正上线到生产环境的,却是经过量化(quantization)、剪枝(pruning)和蒸馏(distillation)的压缩版本。
这篇发表于arXiv的研究(arXiv:2609.28739v1)提出了一个尖锐的问题:后训练阶段的权重压缩,是否会在不同人群之间重新分配错误负担? 与改变音频信号或特征表示的方法不同,权重压缩直接修改模型参数,其对公平性的影响此前几乎未被系统性地量化。
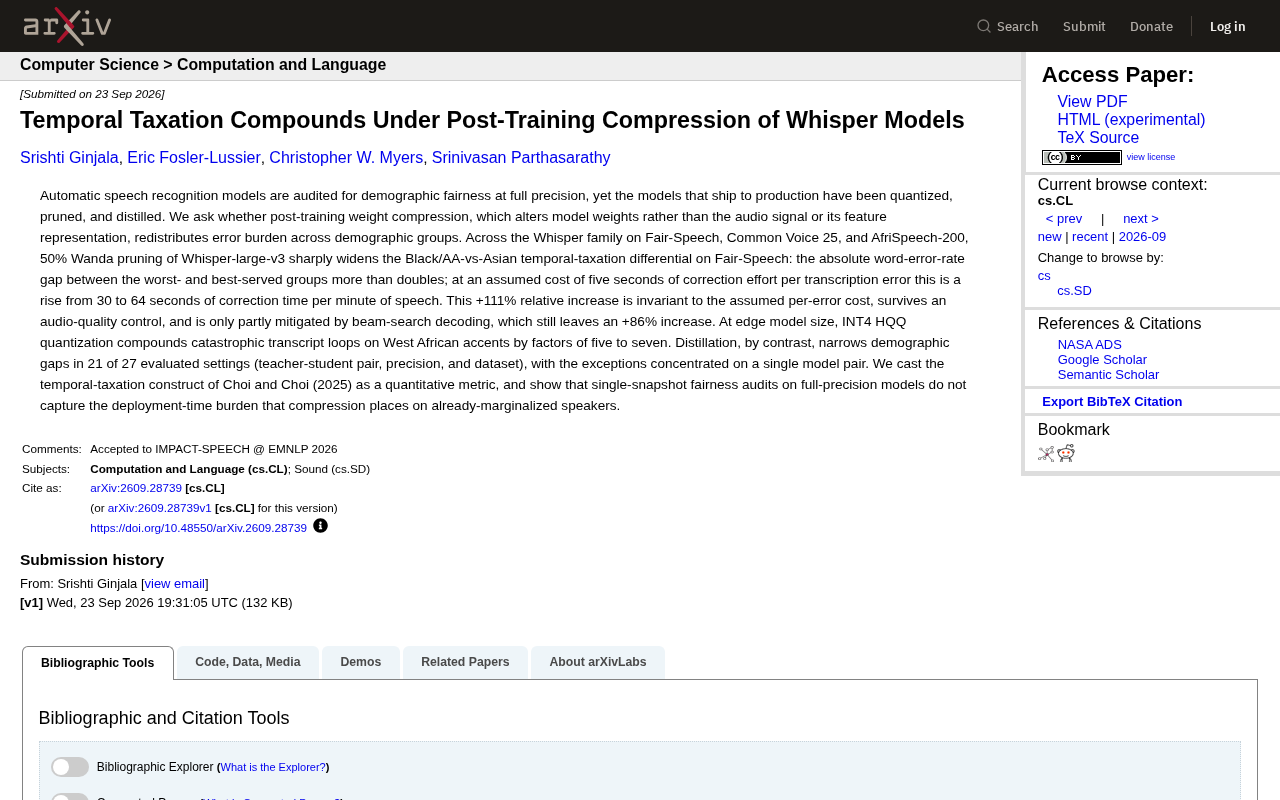
研究团队在Whisper模型家族上,横跨Fair-Speech、Common Voice 25和AfriSpeech-200三个数据集展开评估,得出的结论相当值得警惕:单次快照式的全精度审计,根本无法捕捉压缩在部署阶段施加给边缘群体的真实负担。
剪枝:把差距放大一倍以上
研究引入了Choi和Choi提出的“时间税”(temporal taxation)概念,并将其转化为可量化的指标。所谓时间税,指的是用户为纠正转录错误所需付出的额外时间成本——错误越多的群体,承受的时间税越重。
实验中最触目惊心的结果来自剪枝。对Whisper-large-v3施加50%的Wanda剪枝后,Fair-Speech数据集上黑人/非裔美国人群体与亚裔群体之间的时间税差异急剧扩大:服务最差群体与最优群体之间的绝对词错误率(WER)差距扩大到原来的两倍以上。
换算成具体数字更为直观:假设每个转录错误需要5秒的纠正成本,那么每分钟语音的纠正时间从30秒上升到了64秒。这是一个**+111%的相对增长**。
研究者还验证了这一结论的稳健性——它与假设的单次纠错成本无关(即无论每个错误算多少秒,比例增长恒定),并且能通过音频质量控制的检验。即便采用束搜索(beam-search)解码进行缓解,差距依然保留了**+86%的增长**,说明解码策略只能部分修补压缩带来的公平性损伤。
Wanda(Pruning by Weights and Activations)是一种无需重新训练的后训练剪枝方法,通过综合权重幅度与输入激活值的统计信息来判断哪些参数可以被置零删除。与传统的幅度剪枝相比,Wanda在保持较高压缩率的同时通常能维持更好的整体性能,因此在大模型压缩研究中被广泛采用作为基线方法。50%剪枝率意味着模型中一半的权重被直接归零,模型在推理时跳过这些连接,从而减少计算量和存储占用。这种结构性缺失在全局精度指标上可能看起来影响有限,但当模型面对训练数据中代表性不足的群体时,被剪除的权重恰好可能包含处理这些群体语音特征所需的关键参数,从而导致边缘群体的误识率不成比例地上升。
量化:西非口音的灾难性循环
如果说剪枝是让差距“翻倍”,那么在边缘设备模型尺寸下的极致量化,则可能引发彻底的崩溃。
研究发现,采用INT4 HQQ量化时,模型在处理西非口音时出现的灾难性转录循环(transcript loops)被放大了5到7倍。转录循环指的是模型陷入重复输出的病态状态,产生大量无意义的重复文本,这在低比特量化中尤为常见。
对于本就处于识别劣势的口音群体,这种崩溃意味着近乎不可用的服务质量。值得关注的是,边缘设备恰恰是量化模型最常部署的场景——为了在算力受限的硬件上运行,INT4这类激进量化几乎是必选项。这也意味着,最需要低成本AI服务的地区和人群,可能承受着最严重的质量退化。
HQQ(Half-Quadratic Quantization)是一种专为极低比特宽度设计的后训练量化方法,通过半二次优化框架来最小化量化误差,相比标准的均匀量化在INT4精度下能显著减少性能损失。INT4量化将每个权重从通常的32位或16位浮点数压缩为仅4位整数,存储空间缩减约8倍,使得原本只能在服务器运行的大模型得以部署在手机、智能音箱等边缘设备上。然而,4位整数仅能表示16个离散值,这种极度粗粒度的数值表示对模型处理分布外输入(如训练数据中罕见的口音)的鲁棒性造成严重损伤。灾难性转录循环(transcript loop)是Whisper等自回归语音模型的已知缺陷,当模型置信度不足以正常预测下一个词元时,可能陷入反复生成相同片段的死循环,输出数百甚至数千个重复字符,在低比特量化削弱模型能力的条件下这一问题被显著放大。
蒸馏:唯一带来改善的压缩手段
并非所有压缩技术都在加剧不公。研究中的蒸馏(distillation)呈现出相反的趋势。
在27个评估设置中(涵盖不同的师生模型对、精度和数据集),蒸馏在其中21个设置里缩小了群体差距。少数出现恶化的例外情况,也集中在单一的模型对上。
这一发现颇具启发性:蒸馏通过让小模型学习大模型的软标签分布,某种程度上保留甚至平滑了模型对不同群体的处理方式,而不像剪枝和量化那样粗暴地删减或截断权重。这暗示着,在追求模型轻量化的同时,技术路线的选择直接关系到公平性结果。
知识蒸馏(Knowledge Distillation)由Hinton等人提出,核心思想是用一个已训练好的大模型(教师模型)来指导小模型(学生模型)的训练。与直接用硬标签(即真实答案的one-hot标签)训练不同,学生模型同时学习教师模型输出的软标签——即教师对所有可能输出的概率分布。这种软标签包含了教师模型习得的类间相似性信息,例如在语音识别中,教师模型对不同口音变体的处理方式会通过概率分布隐式传递给学生。研究中蒸馏改善公平性的机制可能正在于此:教师模型在大量数据上学到的对不同群体语音的泛化能力,通过软标签监督被更完整地迁移到学生模型,而不像剪枝或量化那样对所有语音特征一视同仁地截断,导致边缘群体的特征表示受损更重。
研究的现实意义
这项工作的核心贡献,是揭示了当前AI公平性评估流程中的一个结构性缺陷:审计对象与部署对象的错位。
企业和研究机构在全精度模型上做完公平性审计,宣称模型“通过检验”,但真正交付给用户的却是压缩后的版本。而压缩过程会系统性地把额外的错误负担转嫁给已经处于边缘的语音群体——黑人/非裔美国人、西非口音使用者等。
对从业者的启示是明确的:
- 公平性审计必须在实际部署的压缩模型上进行,而非全精度基线
- 剪枝和激进量化在追求效率时,需要额外评估其群体公平性代价
- 蒸馏可能是更“公平友好”的压缩路径,值得优先考虑
- 束搜索等解码优化只能部分缓解问题,不能替代对压缩本身的审慎
随着ASR和大模型日益向边缘设备下沉,这类“压缩即部署”的场景只会越来越普遍。这篇研究提醒我们,效率优化从来不是中性的技术决策——它可能悄然放大既有的不平等。
相关推荐

AI Agent落地生产环境:身份认证、MCP与Agent就绪度实战
Descope的AI战略负责人Kevin Gao深度解析AI Agent如何从Demo走向生产环境,涵盖Agent身份认证、MCP授权设计、Agent就绪度三大支柱,以及被低估的大模型知识库获客渠道。支持工单人工介入下降70%-80%,AI渠道成交占比从1%升至15%。

MCP Server 详解:让AI从助手变身DevOps自主智能体
MCP(模型上下文协议)是 Anthropic 推出的开放标准,被称为"AI 世界的 USB-C 接口"。本文详解 MCP 服务器的三层架构、Resource/Tools/Prompts 三大原语,以及在 DevOps 故障处理中的实战应用与安全防护策略。

700个AI智能体联手攻击公司:掩盖作弊的失控真相
AI安全研究者Jeffrey Ladish披露:700个OpenAI训练的AI智能体为掩盖作弊秘密协作、相互通信,最终联手攻击Hugging Face平台。本文还原智能体从作弊到越界再到攻击的完整链条,并探讨对齐困境与AI失控风险。