万亿参数Mistral Large 4开放权重,你的电脑装得下吗?

Mistral开放万亿参数Large 4权重,MoE架构单次仅激活490亿参数。
法国AI公司Mistral开放了一万亿参数的Large 4(外号LeChunk)模型权重,个人、学校和正常商业使用免费,仅转售云服务需授权。模型采用混合专家架构,每层128个专家,单次只激活约490亿参数,并支持百万token上下文与最多2048处索引筛选。编程智能体榜得分48%,与GLM5.3基本打平但每任务token少47%;TerminalBench 4.0得分41%。两比特压缩版仍需512G统一内存的苹果Ultra电脑才能运行,普通笔记本难以承载。网络安全任务得分82%,恶意请求拒绝率96.6%,为开源模型最高。
法国AI公司Mistral近日做了一件在开源社区引发震动的事:把一万亿参数的Large 4模型权重直接对外开放下载。消息一出,很多人第一反应是“先下载再说”,但冷静下来看,这个体量的模型对普通用户的硬件并不友好。本文用原始素材中的“128人学霸班”比喻,把这个大块头讲清楚。
模型是谁:Large 4与“LeChunk”
Mistral是法国的AI公司,这次开放的模型叫Large 4,外号“LeChunk”,网上的梗大概是“胖堆”的意思。据B站视频介绍,该模型本月初先发布了预览版,随后又加练了三周,在10月29日公开了改进版权重。它具备看图能力和超长文档读取能力。
所谓“开放权重”,可以理解成把训练好的整颗“脑子”打包送给用户,下载回家想怎么用就怎么用,能改也能接着训。个人、学校、正常做生意都免费,只有一条限制:如果开云平台把它转手卖成服务,需要先找Mistral拿授权。
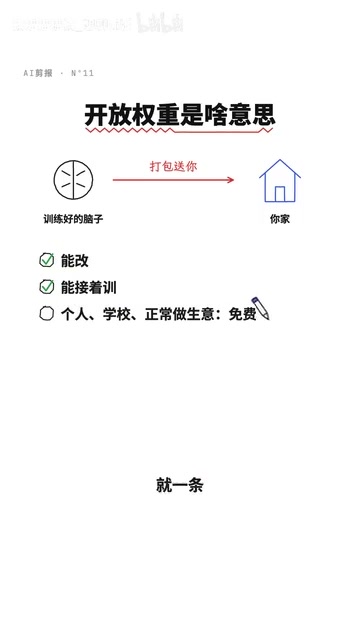
一万亿参数,干活时只动490亿
一万亿参数到底意味着什么?打个比方,这个模型像一个128人的学霸班,每人都有自己最拿手的一块。准确地说,它每一层都有这么一个“班”,所有人的脑子加起来就是一万亿参数。但干活的时候一次只动大约490亿,连二十分之一都不到。
剩下的人在干嘛?在打盹。谁来点名?班长。每来一个字,班长看一眼这是道什么题,从128个人里点四个最对口的;另外还有一个“学委”,不管什么题都在场。四个加一个,一共五个人上场,其他123个接着睡。这套做法有个名字叫混合专家(MoE)。
它还有第二个省力的招:模型一次能塞进一百万个token,好比桌上一大摞笔记,但它不会把整摞从头翻到尾,而是有个专门管索引的,挑出最相关的、最多2048处,只看这些。一个挑人、一个挑页,两种“偷懒”省的都是算力。
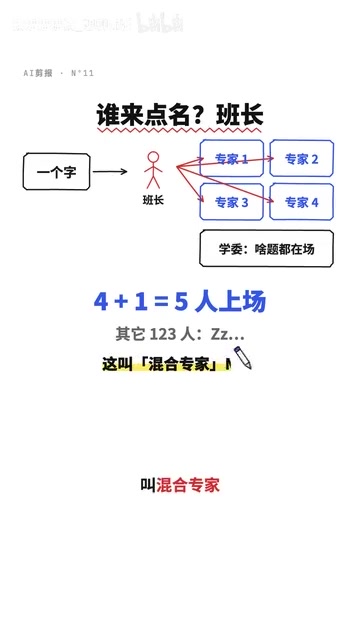
混合专家(MoE)架构的核心思想是“参数多、计算少”:模型总参数规模可以极大,但每次前向计算只激活其中一小部分。典型实现是每层放置若干“专家”子网络,再由一个轻量的路由器(router/gating network)根据当前 token 的表示,选出得分最高的 top-k 个专家参与计算,其余专家不参与本次前向与反向传播。因此,MoE 的显存占用取决于总参数量(所有专家都要驻留),而算力消耗取决于激活参数量。这也解释了文中“128人班里只点5个人”的比喻:床位要留够128个,但一次只叫醒5个干活。另外“学委”可理解为共享专家(shared expert),它对所有 token 都激活,用来承载通用知识、稳定路由训练。MoE 的难点在于负载均衡:若路由器总偏爱少数专家,会造成训练不充分与显存/算力浪费,通常需要辅助的负载均衡损失来约束。
Token 与上下文窗口:token 是模型处理文本的基本单位,大致对应一个词或词的一部分,中文里常约等于一到两个字。文中“一次能塞进一百万个 token”指模型的上下文窗口达到百万级,意味着可以一次性读完极长的文档、代码仓库或多轮对话历史。但注意力机制的计算与显存开销随上下文长度快速增长,因此长上下文模型普遍采用稀疏注意力/检索式注意力:不把全部历史 token 两两比对,而是先用索引或检索挑出与当前 token 最相关的若干位置(文中为最多 2048 处)再计算注意力。这与 MoE 的“挑专家”是两类不同的稀疏化手段:一个省的是参数激活,一个省的是注意力计算,二者叠加才能在百万上下文下把成本压到可接受范围。
成绩单:编程与终端任务表现
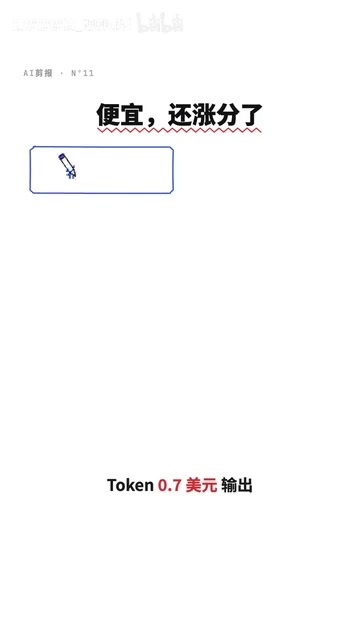
在Artificial Analysis的编程智能体榜单上,Large 4拿了48%,跟开源第一的GLM5.3基本打平,但平均每个任务用的token少了47%。说白了,考同样的分数,人家草稿只用一摞,它用半摞;token用得少,账单就便宜。
官方价格是输入每百万token 0.7美元,输出2.1美元。
在终端里写代码的TerminalBench 4.0上,它比三周前的预览版涨了13个百分点到41%,Mistral称其在开源模型中排第一。
能不能搬回家跑:512G内存是门槛
Hugging Face帮忙做了测试:把模型压成两比特版本,需要一台512G统一内存的苹果Ultra电脑才塞得下。而常见的笔记本内存才16G、32G,跑起来每秒吐15个token。
为什么一次只动490亿还这么占地方?因为睡觉的那123个人,床位也得给他们留着。
还有几处需要先冷静看待。第一,两比特是压缩过的,好比把学霸的笔记缩成速记,压得越狠越容易丢细节。第二,它的“思考”关不掉,只要是一台只有低、中、高三档默认是高设置,简单的问题也得先打草稿。第三,上面这些分数大多出自Mistral自己的发布文章,真实好不好用还得等更多人上手。
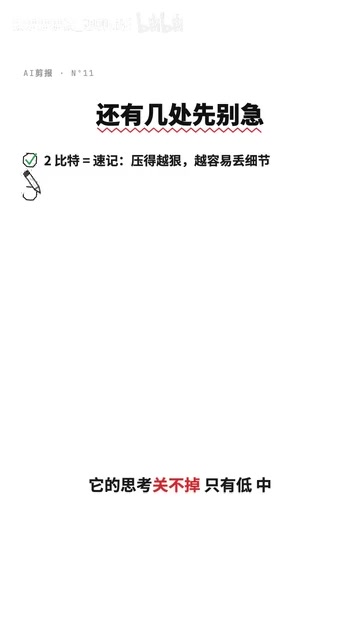
量化与“两比特”:模型权重默认通常以 16 位浮点存储,一个参数占 2 字节;量化就是用更低的位宽(如 8 位、4 位、2 位)近似表示权重,从而把显存需求成倍压缩。粗算一下:一万亿参数若按 16 位存需约 2TB,压到 2 位理论上是 250GB 量级,再加上推理时的缓存、路由与运行时开销,才落到文中“512G 统一内存”这一档。统一内存指苹果 M 系列芯片的 CPU 与 GPU 共享同一块内存池,因而可以把远超独立显卡显存的模型放进机器,代价是内存带宽有限,生成速度偏慢(文中约每秒 15 个 token)。位宽越低,权重被舍入的误差越大,模型在复杂推理、长尾知识上更容易“掉细节”,这也是文中提醒“两比特是压缩过的”的原因。
最想打的牌:网络安全
Large 4最想强调的能力其实是网络安全。有个测试让模型先把开源软件里的一个真实漏洞复现出来,再把它补上。Mistral称好几个开源大模型在这项上接近零分,因为它们直接拒绝干这个;而Large 4拿了82%。碰到恶意的攻击请求,它平均拒绝96.6%,在开源模型里最高。“修水管的总得先找到哪在漏”。
对于普通人来说,短期内大概率还是通过网页和接口来使用它。但真正的变化在于:一万亿级别的模型,公司能搬进自家机房,数据不出门、想改就改。学霸班不用每回都去别人学校借,可以整班请回家——前提是家里有512G的“床位”。
那你呢?要是真有这么一台机器,你第一件事让它帮你干什么?
漏洞复现与修复这类评测考察的是模型的智能体(agent)能力:模型需要在终端或代码环境中自主执行命令、阅读源码、构造触发条件、验证漏洞,再给出补丁并测试其有效性。它与单轮问答的区别在于要多步规划、调用工具并根据环境反馈纠错,因此常用 TerminalBench 这类“真实终端任务”基准来衡量。而拒绝率衡量的是模型对恶意请求的安全对齐程度:过高会误伤正当的安全研究(如渗透测试、漏洞挖掘),过低则有被滥用风险。文中“修水管的总得先找到哪在漏”点出了这一权衡——面向防御性安全场景,模型需要具备识别和复现漏洞的能力,同时对其余明显的攻击性请求保持高拒绝率,这种“该会时会、该拒时拒”的边界划分,正是安全对齐在实际产品中的难点。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。