MoE路由控制什么?专家轨迹因果干预揭示格式与概念的不同命运
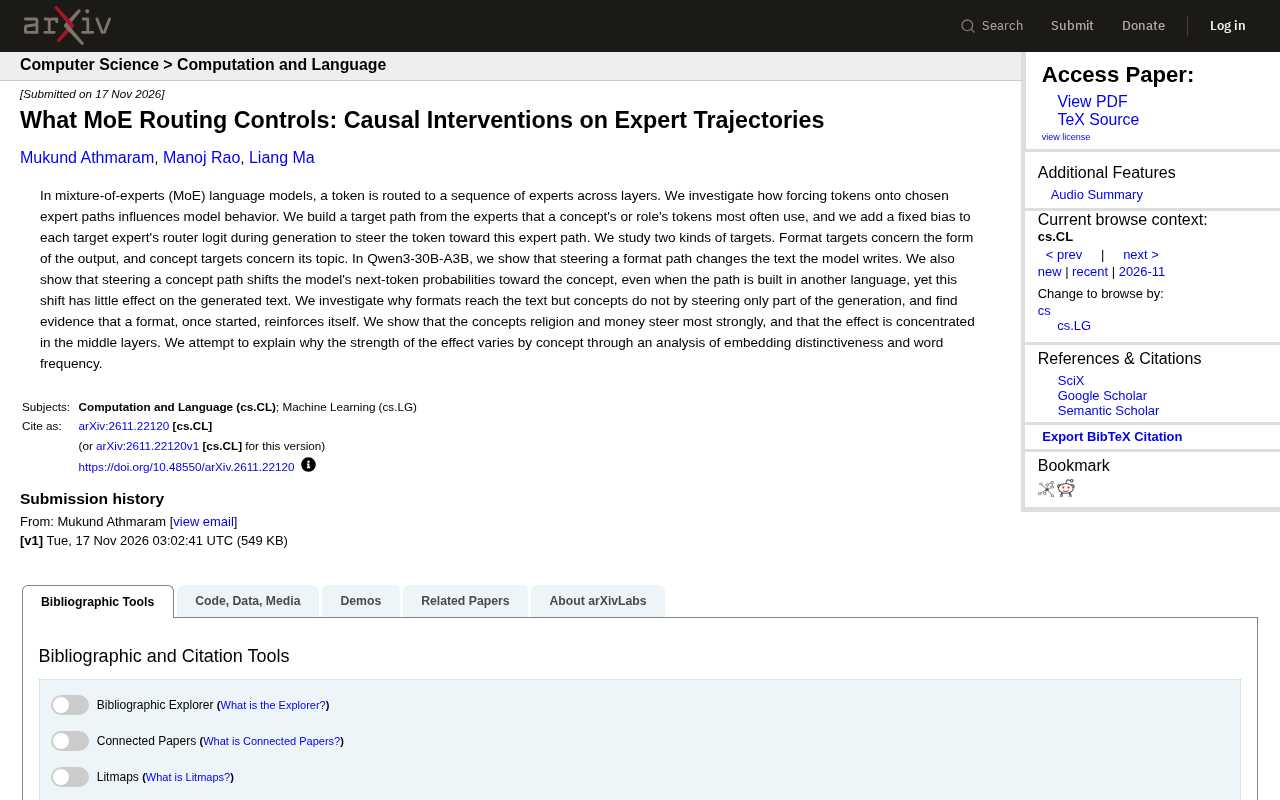
因果干预揭示MoE路由能控制格式却难以控制概念。
研究通过给MoE模型目标专家的路由logit添加偏置,实现对token专家路径的因果干预,并在Qwen3-30B-A3B上检验其效果。结果显示明显的非对称性:将token导向格式相关专家路径时,生成文本的语言与风格会随之改变;而导向“宗教”“金钱”等概念路径时,下一token概率虽向该概念偏移,最终文本却几乎不变。机制上,格式效应因自我强化循环而得以维持,概念效应则集中于中间层,且不同概念的可干预性差异显著。研究结论是路由干预可作为格式控制的有效手段,但对概念控制有限,需结合其他方法。
混合专家(MoE)模型如何将每个token路由到不同专家,一直是理解大模型内部机制的关键问题。一项最新研究通过因果干预实验,揭示了MoE路由对模型行为的控制边界:强制token走向特定专家路径时,格式目标能改变生成文本,而概念目标却几乎无效。这背后隐藏着怎样的机制?
研究背景:MoE路由的可解释性挑战
MoE架构通过稀疏激活专家网络,在保持计算效率的同时扩展模型容量。但路由决策的黑箱性质让研究者难以预测模型行为。以往工作多观察路由模式,而这项研究采用因果干预:在生成过程中,给目标专家的路由logit添加固定偏置,主动将token导向预设的专家路径。
研究聚焦两种目标路径:格式目标关注输出形式(如语言、风格),概念目标关注输出主题(如宗教、金钱)。在Qwen3-30B-A3B模型上的实验,为理解路由与语义的关联提供了新视角。
混合专家(MoE)架构的核心在于用多个并行的前馈网络(即“专家”)替代单一FFN,并通过一个轻量的**路由器(router/gate)**为每个token计算各专家的得分,通常只激活得分最高的Top-K个专家(如Top-2)。这种稀疏激活使得模型总参数量可以远大于单次前向实际使用的参数量,从而在推理成本近似不变的前提下扩大模型容量。路由得分一般由token的隐藏状态与可学习的门控矩阵相乘并做softmax得到。由于每个token的专家组合是离散且动态的,路由决策与语义之间的对应关系并不显式,这正是MoE可解释性研究的难点所在。
**因果干预(causal intervention)**区别于单纯的观察性分析:后者只是统计“某类输入常激活哪些专家”,无法排除混淆因素;前者主动修改系统内部变量(此处是给目标专家的路由logit加偏置),再观察输出如何变化,从而建立“改变路由→改变行为”的因果链条。在本研究中,偏置被加到路由logit上而非直接硬性指定专家,因此干预强度可连续调节,且模型其余部分保持不变。这种设计与神经科学中的激活操控、以及因果推断里的do-算子思想一脉相承,是判断某条内部通路是否对最终输出具有因果效力的关键手段。
核心发现:格式能改变文本,概念却不能
格式路径的干预能显著改变生成文本。例如,当研究者将token引导到与某种语言格式关联的专家路径时,模型输出会相应切换语言风格。这符合直觉:格式特征在路由层面有直接映射。
概念路径的干预则出现分离现象。当研究者将token导向与特定概念(如“宗教”)关联的专家路径时,模型下一token的概率分布确实向该概念偏移,甚至当路径由另一种语言构建时依然有效。然而,这种概率偏移几乎没有影响最终生成的文本。换言之,模型内部“想”到了概念,但“说”出来的内容不变。
这种分离暗示:概念信息在路由中虽可被探测和操纵,但存在下游机制抑制其表达。
机制探索:格式自我强化与概念的中层集中
为了解释格式与概念的不同命运,研究者进行了部分生成干预实验。证据表明,格式一旦启动,会通过自我强化循环巩固自身。例如,当模型开始以某种格式生成时,后续token的路由会倾向于维持该格式,形成正反馈。这解释了格式干预为何能穿透到输出文本。
概念干预的效果则呈现不同模式。研究发现,概念效应在中间层最为集中,并且不同概念的可干预性差异明显:“宗教”和“金钱”概念的路由干预效果最强。研究者尝试从嵌入独特性和词频角度解释这种差异,但具体机制仍待进一步挖掘。
下一token概率分布与最终生成文本之间的“分离”,可从自回归生成的动力学理解。单步概率偏移只影响一步采样,若后续步骤的路由迅速回归常态,则该偏移会被稀释;而格式特征(如语言、标点、句式)具有局部连贯性,一旦出现会持续影响后续token的上下文,从而被放大。概念则往往需要跨越多步、由多个token共同承载才能体现在文本中,单点扰动难以累积成可见的语义改变。这提示“内部表征可被探测”与“该表征能因果地驱动输出”是两个不同层次的命题。
启示与展望:路由干预的边界
这项研究为MoE可解释性提供了重要参考。路由干预并非万能钥匙:格式导向的干预可作为文本控制的有效手段,而概念导向的干预则需谨慎对待。对于需要精确控制输出主题的应用,仅靠路由偏置可能不够,还需结合其他干预方式。
此外,概念效应在中间层集中这一发现,为模型编辑和知识注入提供了潜在切入点。未来研究可探索更精细的干预策略,例如分层、分时段的路由调整,以解锁MoE模型更深层的可控性。
核心要点
- 在Qwen3-30B-A3B上,通过路由logit偏置强制token走向目标专家路径,可实现对模型行为的因果干预。
- 格式路径干预能改变生成文本形式,概念路径干预仅改变下一token概率,对最终文本影响甚微。
- 格式效应存在自我强化机制,概念效应集中于中间层,且“宗教”“金钱”等概念干预效果最强。
- 研究提示:路由干预对格式控制有效,对概念控制有限,需结合其他方法。
背景补充
Qwen3-30B-A3B是通义千问广告Qwen3系列中的MoE版本,命名中的“30B”指总参数量约300亿,“A3B”表示每个token约激活30亿参数(Active 3B),即采用较小的Top-K专家激活比例。选择此类中等规模MoE模型做干预实验,兼顾了专家数量足够多(路由空间大、便于构造目标路径)与实验成本可控两方面。需要注意的是,单模型上的因果结论能否推广到其他MoE架构(不同专家数、不同路由算法、是否共享专家)仍需交叉验证。
相关推荐
计算机科学家为何认为超级智能不会成真
计算机科学家Cal Newport从工程角度反驳超级智能叙事:递归自我改进受限于数据瓶颈与算力约束,超级智能未必可计算,LLM智能体的失控源于架构而非对齐难题。他警告,追逐ASI本身就是一种过失。
Holiday Extras员工把AI助手当“狗”养:Brian与Beast的真实工作日常
Holiday Extras员工将AI助手命名为Beast,每天早晚对话、提前准备会议数据、监控任务进展。本文还原一个真实用户如何把AI嵌入日常工作流,并给出低门槛启动建议。
十亿美元级合作:美国电池市场迎来转机?
Sila与Panasonic Energy签署十亿美元级硅碳负极供应协议,本文分析该交易对美国下一代电池市场、供应链本土化及商业化前景的影响。