MTG-AD:MLLM内联音频描述测评新基准

Google发布MTG-AD数据集与评测框架,首次系统检验MLLM内联音频描述能力。
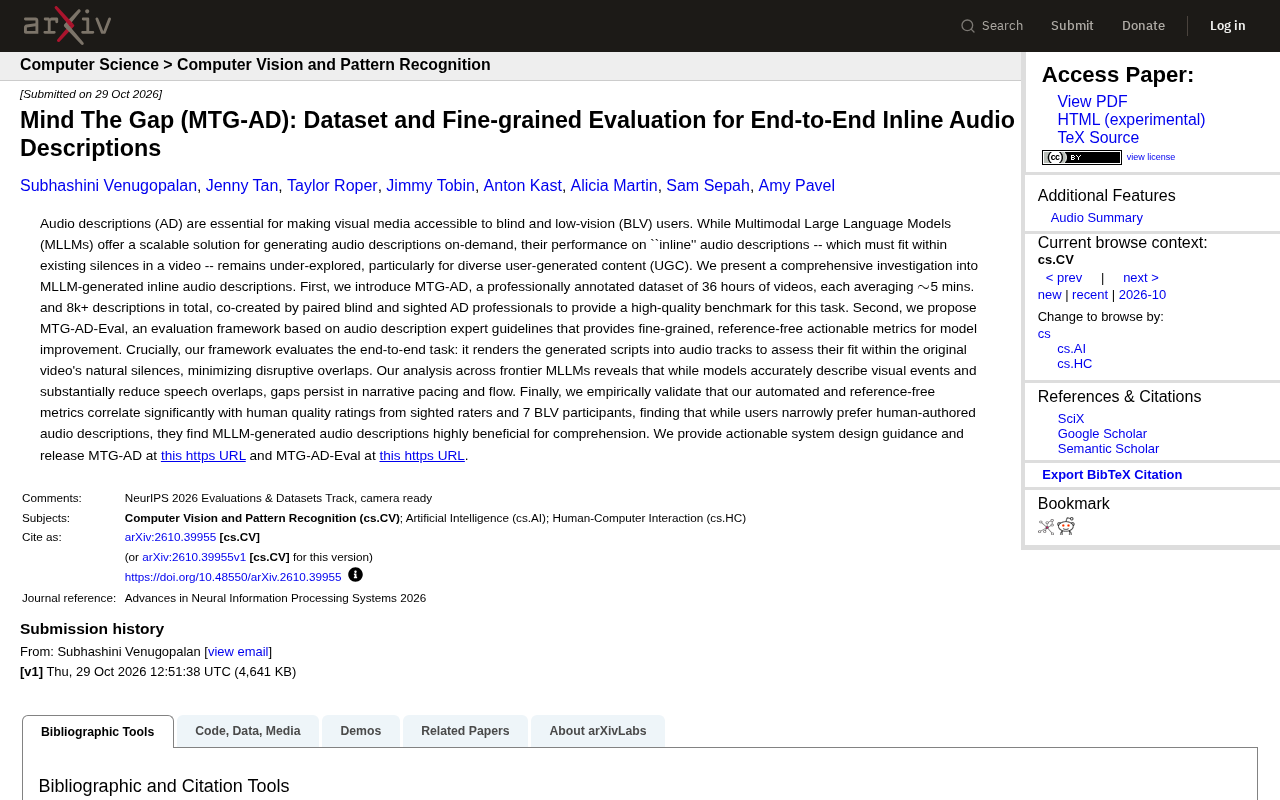
Google团队发布MTG-AD数据集与MTG-AD-Eval评测框架,填补了内联音频描述(旁白须嵌入视频静音缝隙)的评测空白。数据集含36小时视频、8k+条描述,由盲人与明眼专家配对标注。评测框架将生成脚本渲染为音轨放回原时间线,检验是否嵌入静音、避免重叠。前沿MLLM能准确描述视觉事件并大幅减少语音重叠,但叙事节奏与流畅度不足。自动指标与人类评分显著相关,用户略偏好人类描述但认为MLLM内容很有帮助。
给盲人和低视力(BLV)用户"看"视频,靠的是音频描述(Audio Description,AD):在画面之外的语音轨道里,把正在发生的事讲清楚。多模态大模型(MLLM)让按需生成音频描述成为可能,但有一个关键场景长期缺乏严肃评测——内联音频描述(inline AD):旁白必须塞进视频原有的静音缝隙里,不能压住对白和音效。
Google 团队发布的 MTG-AD 数据集与 MTG-AD-Eval 评测框架,补上了这块空白。据其论文,该工作首次系统检验了 MLLM 在端到端内联音频描述任务上的表现,并给出了可直接用于模型改进的细粒度、无参考评测指标。
为什么"内联"是更难的那道题
传统音频描述多为后期制作,描述脚本可以在录制时灵活调整时长。内联描述则受制于视频本身的时间结构:一段话必须恰好落在某段静音里,多一个词就可能与下一句对白撞车。
论文指出,已有的 MLLM 音频描述研究很少覆盖这一约束,对用户生成内容(UGC)场景的探索尤其不足。UGC 视频的静音分布不规则、语速与剪辑节奏差异大,正是内联描述最容易翻车的地方。MTG-AD 瞄准的正是这个"缝隙里做文章"的任务。
MTG-AD:由盲人与明眼专家共同标注的基准
MTG-AD 的规模并不追求"大",而是强调标注质量与任务真实性:
- 36 小时视频,每条平均约 5 分钟;
- 8k+ 条描述,总量可观且逐条对齐时间轴;
- 由盲人与明眼音频描述专家配对协作完成标注。
最后一 点值得展开。音频描述的最终受众是 BLV 用户,但行业内相当一部分标注由明眼人完成。让盲人专家参与共创,意味着标注不仅描述"画面上有什么",还要照顾"听者此刻需要知道什么"——信息取舍与叙述节奏的判断标准因此更贴近真实使用场景。数据集已开源在 Hugging Face(google/mind-the-gap-inline-ad)。
MTG-AD-Eval:把脚本渲染成音轨再打分
MTG-AD-Eval 的设计思路是"评测最终产物,而不是中间文本"。据论文,该框架基于音频描述专家指南构建,提供细粒度、无参考、可操作的指标。
最核心的一步是端到端渲染:把模型生成的描述脚本合成为音频轨道,放回原视频的时间线上,检验它是否真正嵌入了自然静音段、是否造成干扰性重叠。这一步把"文本看起来不错"和"听感上站得住"区分开来,也是多数文本级评测遗漏的环节。
框架与代码已在 GitHub(google/mtg-ad)发布,便于研究者复现与接入自有模型。
无参考指标指不依赖人工撰写的“标准答案”来评估生成质量。在内联音频描述中,这尤为关键:同一段画面可以有许多种合理描述,强行比对参考文本会惩罚创意表达。MTG-AD-Eval 的无参考指标基于音频描述专家指南设计,直接度量描述是否嵌入了静音段、是否与对白重叠、节奏是否连贯等可操作维度,从而更贴近最终听感。
前沿模型的成绩单:讲得对,但讲得不顺
论文对多个前沿 MLLM 的分析给出了一个清晰结论:模型在视觉事件描述的准确性上表现良好,并且大幅减少了语音重叠——后者说明模型确实学会了把话塞进缝隙。
但短板出现在叙事节奏与流畅度上。换句话说,模型知道该说什么、也知道什么时候能说,却不太擅长把碎片化的描述组织成连贯的叙述流。对内联描述而言,这不是小问题:听众接收的是连续语音流,节奏断裂会直接抬高理解成本。
这一发现也解释了后续人评中"有用但不完美"的微妙结果。
**语音重叠(speech overlap)**在此处特指生成的音频描述与视频原有对白、音效在时间上发生交叠,导致听者难以分辨两条语音流。对于 BLV 用户,重叠会直接掩蔽关键对白信息,是内联描述最应避免的失败模式。论文中“大幅减少语音重叠”意味着模型学会了在生成文本时同步考虑时间轴约束,而非仅关注内容正确性。
人评验证:自动指标可信,但人类作者仍略胜一筹
研究团队用明眼评分者和 7 位 BLV 参与者的质量评分,验证了自动化无参考指标的有效性——两者存在显著相关性。这为"用自动指标替代昂贵人工评测"提供了经验支持。
用户偏好方面:参与者略微更偏好人类撰写的音频描述,但同时认为 MLLM 生成的描述对理解视频很有帮助。这个组合结论相当务实:机器描述还达不到专家水准,但已经跨过了"可用"的门槛,足以支撑按需生成的实际部署。
论文据此给出了可操作的系统设计建议,指向也很明确:提升重点不在"看得更准",而在"讲得更顺"。
对行业意味着什么
MTG-AD 的价值不止于一个数据集。它把内联音频描述从"工程细节"提升为可评测的研究任务,并给出了三条可复用的方法论:以真实时间约束定义任务、以渲染后音轨作为评测对象、以 BLV 用户参与验证指标效度。
对做无障碍产品的团队来说,这意味着评价 MLLM 音频描述能力时,该换一套尺子了——文本相似度无法反映旁白是否踩了对白的脚,也测不出听感上的节奏断裂。数据集与评测框架均已开源,接入成本不高。
参考来源:论文 Mind The Gap (MTG-AD): Dataset and Fine-grained Evaluation for End-to-End Inline Audio Descriptions。
背景补充
**用户生成内容(UGC)**指由普通用户而非专业机构制作并上传的视频,典型如 vlog、教程、直播切片。与影视剧不同,UGC 的音频轨道往往包含不规则的静音间隙、即兴口语、环境噪声和突然的剪辑点,且缺乏统一的响度标准。这些特性使得内联音频描述必须依赖精细的语音活动检测来定位可插入旁白的“缝隙”,对模型的时序推理能力提出了更高要求。
相关推荐

Vibe Coding全栈实战:AI编程从入门到企业级落地
从Cursor到Claude Code,这套B站AI编程实战课程以四个递进项目覆盖全栈开发、开源二次开发与团队协作。文章解析AI编程带来的前端岗位震荡、五人选五十人的效率变革,以及企业级项目所需的方法论。

大卫·布莱恩全球寻访真魔术:从南非到日本与印度
大卫·布莱恩在《Do Not Attempt》特辑中走访南非、日本与印度,记录Spinning车手、黑曼巴蛇保护者、居合术大师与苦行者的真实绝技,探讨魔术与人类极限挑战之间的边界。

触屏MacBook要来了?Vergecast爆料苹果高管回应
Vergecast播客披露记者与苹果高管John Ternus的对话,谈及触屏MacBook与Apple Pencil支持问题。Ternus回应称iPad才是手写笔最佳设备,记者则押注MacBook终将支持Apple Pencil。