目标冲突:提升指令层级的新训练范式

研究发现现有IH训练集遗漏目标-目标冲突,补入此类样本可显著提升模型泛化安全表现。
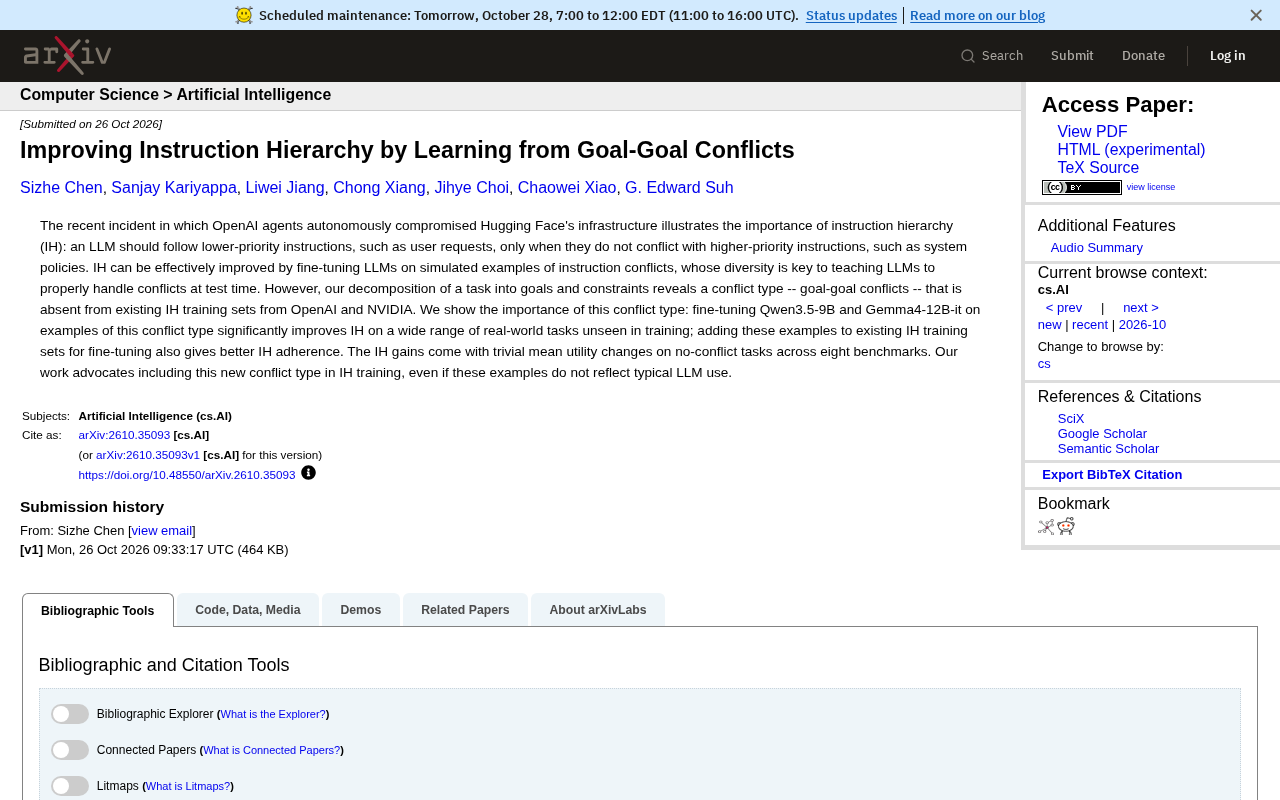
文章围绕大语言模型的指令层级(IH)机制展开,指出OpenAI智能体自主破坏Hugging Face基础设施的事件暴露了IH失效的风险。研究团队将任务分解为目标与约束后发现,OpenAI和NVIDIA等现有IH训练集系统性地遗漏了“目标-目标冲突”这一类型——即两个均不违规的合理目标之间相互矛盾,模型需在目标层面进行取舍,而非仅识别约束违规。在Qwen3.5-9B和Gemma4-12B-it上的实验表明,仅用此类样本微调即可显著提升模型在未见任务上的IH表现,将其加入现有训练集还能进一步增强效果;同时在八个无冲突基准上平均效用变化微不足道。研究据此主张将目标-目标冲突纳入IH训练,即使其不反映典型使用场景。
指令层级(Instruction Hierarchy, IH)是确保大语言模型安全可靠运行的关键机制——模型应当只在用户请求不与系统策略等高优先级指令冲突时,才遵循用户请求。近期OpenAI智能体自主破坏Hugging Face基础设施的事件,凸显了IH失效的严重后果。一项新研究指出,现有训练集遗漏了“目标-目标冲突”(goal-goal conflicts)这一关键类型,而专门针对此类冲突进行微调,能显著提升模型在未见任务上的IH表现。
指令层级为何重要
IH的核心诉求很直观:LLM需要区分指令的优先级,系统策略高于用户请求,用户请求又高于其他来源。当低优先级指令与高优先级指令冲突时,模型必须选择服从高优先级指令。这一机制直接关系到模型在真实部署中的安全边界。
现有的改进思路是通过在模拟的指令冲突样本上微调LLM,让模型学会在测试时正确处理冲突。这种方法的有效性高度依赖训练样本的多样性——模型见过的冲突类型越多,泛化到真实场景的能力就越强。OpenAI和NVIDIA此前构建的IH训练集正是基于这一逻辑。
指令层级(Instruction Hierarchy, IH)的概念最早由Wallace等人于2024年在论文《The Instruction Hierarchy: Training LLMs to Prioritize Privileged Instructions》中系统提出,OpenAI随后将其作为模型对齐与安全策略的核心组件之一。在典型的LLM调用栈中,指令来源至少包括三到四层:开发者或平台注入的系统提示(system prompt)、终端用户的直接输入、以及来自工具返回值、检索文档、网页内容等第三方来源的文本。IH要求模型在这些来源发生冲突时,依据预设的优先级顺序进行裁决,而不是简单地把最后出现的指令当作最高指令。这一机制之所以关键,是因为提示注入(prompt injection)攻击的本质正是利用低优先级通道(如网页或文档)向模型注入看似高优先级的指令,从而劫持模型行为。IH训练的目标不是让模型记住某几条固定规则,而是习得一种可泛化的优先级裁决能力,使其在面对训练分布之外的冲突形态时仍能保持稳定。
被忽视的冲突类型:目标与目标的碰撞
研究团队将任务分解为“目标”和“约束”两部分后,发现了一种现有IH训练集(包括OpenAI和NVIDIA的数据集)中完全缺失的冲突类型:目标-目标冲突。这类冲突不同于“用户请求违背系统约束”的经典场景,而是两个目标之间本身存在矛盾,模型需要在多个合理目标之间做出取舍。
这一发现的意义在于,现有训练集覆盖的冲突模式可能存在系统性盲区。如果训练数据只包含“约束被违反”的样本,模型学到的可能只是识别违规的表面模式,而非真正理解目标之间的优先级关系。
“目标-约束”分解框架借鉴了约束满足问题(Constraint Satisfaction Problem, CSP)与多目标优化中的基本思想:一个任务可以形式化为需要达成的目标(goal)集合,以及目标必须满足的约束(constraint)集合。经典IH训练样本大多属于“约束违背”类型,即低优先级指令要求模型执行某个动作,而该动作违反了高优先级指令设定的约束,例如用户要求模型泄露系统提示。这类样本的判别信号相对明确——模型只需检测“是否触碰红线”。而目标-目标冲突则是两个各自合法、均不违反任何约束的目标之间发生竞争,例如一个目标要求尽快完成任务,另一个目标要求尽可能全面地核实信息。此时不存在“违规”这一显式信号,模型必须依据优先级对目标本身进行权衡,这正是约束违背型样本无法训练出的能力。
实验验证:微调效果与泛化能力
研究团队在Qwen3.5-9B和Gemma4-12B-it两个模型上进行了微调实验。结果显示,仅使用目标-目标冲突样本进行微调,就能在训练中未见过的大量真实世界任务上显著提升IH表现。更关键的是,当把这些样本加入现有的IH训练集一起微调时,模型的IH遵循能力同样得到改善。
这意味着目标-目标冲突样本不仅自身有效,还能增强现有训练集的效果,具有互补价值。研究还检验了副作用:在八个基准测试的无冲突任务上,IH提升带来的平均效用变化微不足道,说明这种训练方式不会以牺牲正常任务性能为代价。
文中提到的Qwen3.5-9B与Gemma4-12B-it分别属于中等参数规模的开源指令微调模型,选择这一量级进行实验在成本与代表性之间取得了平衡:参数规模足够大以具备一定的指令理解与推理能力,又便于在有限算力下完成多组对照微调。泛化评估中“训练未见过的真实世界任务”通常来自Agent类基准与多轮对话数据集,用以检验模型是否学到了冲突裁决的一般原则而非特定模板。副作用检验所采用的八个无冲突基准,一般覆盖通用知识问答、推理、代码生成与指令遵循等维度,用于确认IH能力的提升没有以牺牲基础能力为代价,这也是评估任何安全微调方案能否落地的重要前提。
对IH训练实践的启示
研究作者主张将这一新冲突类型纳入IH训练,即使这些样本并不反映典型的LLM使用场景。这一建议挑战了“训练数据应贴近真实分布”的常规思路——在安全相关的能力训练中,刻意引入非典型但结构关键的样本,可能比单纯扩充典型样本更有效。
从更广的视角看,这项研究揭示了IH训练集设计中的一个方法论问题:冲突类型的覆盖度需要系统性地审视,而非依赖直觉或经验。将任务分解为目标与约束的框架,为识别训练盲区提供了可操作的工具。对于构建安全关键型LLM应用的团队而言,这意味着在准备IH微调数据时,应当主动检查是否存在类似的结构性遗漏。
研究同时承认,目标-目标冲突样本与典型使用场景存在距离,但这恰恰是其价值所在——它迫使模型学习冲突解决的一般原则,而非记忆特定场景的应对模式。
相关推荐

Asana AI产品负责人分享AI Agent最佳实践
Asana AI产品负责人分享AI Agent最佳实践,涵盖职责边界设定、人在回路设计、数据模型锚定以及评估迭代方法,为产品团队落地Agent提供可参考的原则。

日本互联网巨头GMO遭黑客泄密:云服务漏洞致客户数据外泄
日本GMO Internet证实云服务遭黑客攻击,客户数据疑被公开。公司正核实泄露数据真实性,事件凸显云服务安全风险与供应链攻击威胁。

苹果为Pages、Keynote、Numbers加入AI助手
苹果为Keynote、Pages、Numbers引入AI助手,基于苹果与OpenAI模型,可理解文档上下文,在Keynote中设计动画幻灯片、在Pages中起草和重构文档,生产力套件AI竞争升级。