MuEdit:破解大模型多任务编辑的域间冲突难题

MuEdit 揭示多任务编辑失效源于域间零空间错位,并提出冲突指数与两阶段缓解策略。
大语言模型跨领域知识更新时,多任务顺序编辑常因“域间零空间错位”而失效:异质任务导致共同零空间急剧缩小,可用安全更新方向不足。MuEdit 提出冲突指数量化几何干扰,并通过冲突感知排序和动态低秩近似两阶段缓解冲突。在五个功能领域和三个骨干模型上,MuEdit 显著优于基线,保持模型通用能力,且在增量任务到达场景下依然有效,为动态任务流处理提供了新思路。
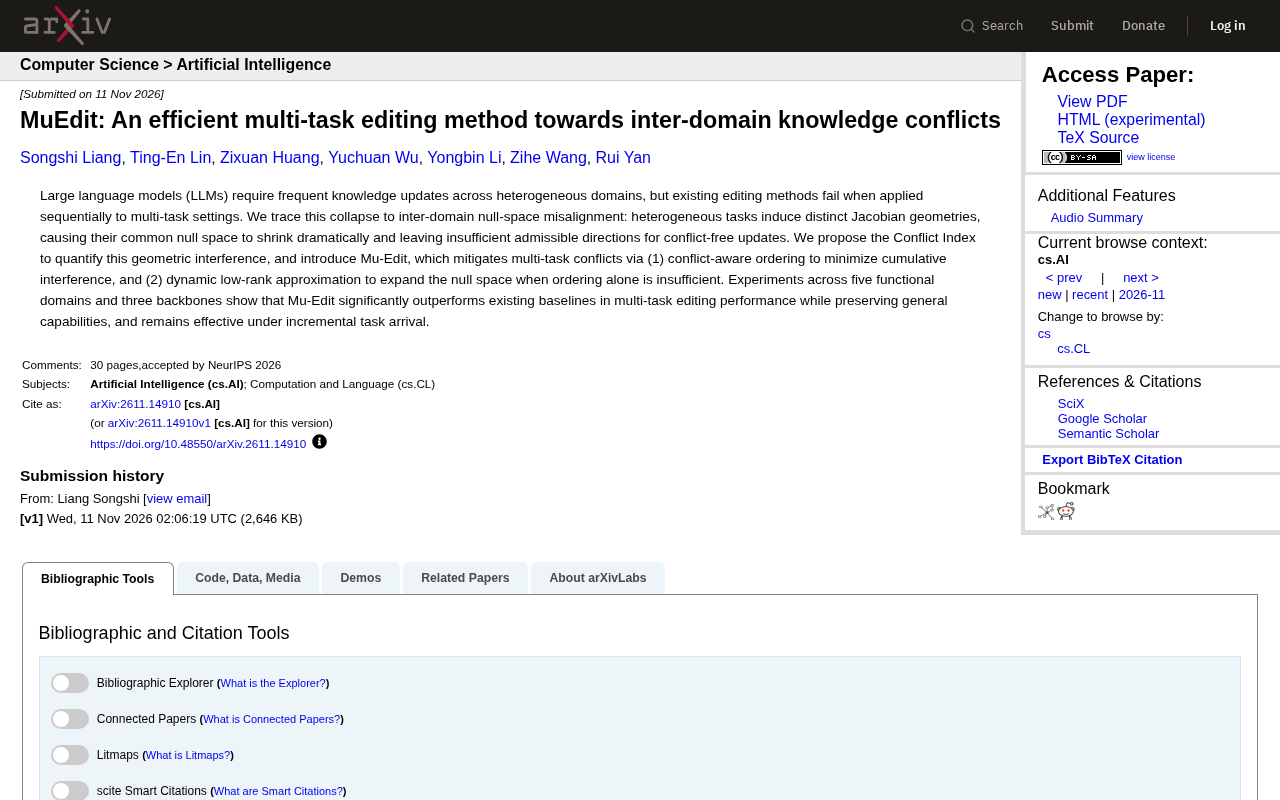
大语言模型(LLM)需要频繁更新跨领域的知识,但现有编辑方法在多任务场景下顺序应用时往往失效。一篇题为《MuEdit: An efficient multi-task editing method towards inter-domain knowledge conflicts》的研究,将这种失效归因于“域间零空间错位”(inter-domain null-space misalignment),并提出了针对性的解决方案。
多任务编辑为何会“崩溃”?
研究指出,异质任务会诱发不同的雅可比几何结构(Jacobian geometries),导致它们的共同零空间急剧缩小。零空间是模型参数更新中不影响原有任务的“安全方向”,当共同零空间被压缩后,可用于无冲突更新的可行方向就变得不足,顺序编辑因此相互干扰,最终造成性能崩溃。
为了量化这种几何干扰,作者提出了“冲突指数”(Conflict Index),将任务间的干扰程度转化为可度量的指标。这一指标不仅解释了失效机制,也为后续的冲突缓解策略提供了依据。
零空间与雅可比几何:在模型编辑中,零空间指参数更新空间中那些不改变模型对原有任务输出的方向。对于单个任务,可以通过计算其输出对参数的雅可比矩阵(即输出对参数的敏感度矩阵)来找到该矩阵的零空间,从而保证编辑不影响旧知识。雅可比几何则描述了不同任务对应的雅可比矩阵在参数空间中的分布关系。当多个异质任务顺序编辑时,它们各自的零空间交集(共同零空间)会因任务间雅可比矩阵的差异而迅速缩小,导致可用的安全更新方向不足,从而引发编辑冲突和性能崩溃。
Mu-Edit 的两阶段缓解策略
Mu-Edit 通过两个互补机制来缓解多任务冲突:
- 冲突感知排序(conflict-aware ordering):通过调整任务的编辑顺序,最小化累积干扰。实验表明,合理的顺序能显著降低冲突指数。
- 动态低秩近似(dynamic low-rank approximation):当仅靠排序不足以解决问题时,该方法动态扩展零空间,为无冲突更新提供更多可行方向。
这种“先排序、再扩展”的思路,兼顾了效率与编辑效果,避免了单一策略的局限性。
低秩近似:在矩阵运算中,低秩近似指用一个秩更低的矩阵来近似原矩阵,以捕捉其主要结构并降低计算复杂度。在 Mu-Edit 中,动态低秩近似用于扩展零空间:当共同零空间不足时,该方法通过低秩分解动态地构造一个近似零空间,为参数更新提供更多可行方向,同时尽量不干扰原有任务。这种方法在保证编辑效果的同时控制了计算开销,是应对多任务冲突的关键技术。
实验验证:覆盖五领域与三骨干模型
研究在五个功能领域和三个骨干模型上进行了实验。结果显示,Mu-Edit 在多任务编辑性能上显著优于现有基线,同时保持了模型的通用能力。此外,在增量任务到达(incremental task arrival)的场景下,Mu-Edit 依然有效,说明其具备应对动态任务流的潜力。
对知识编辑实践的启示
这项工作的价值在于,它没有停留在“打补丁”式的改进,而是从几何角度剖析了多任务编辑冲突的根源,并给出了可量化的诊断工具(冲突指数)和可操作的解决方案(排序+动态低秩)。对于需要持续更新跨领域知识的应用来说,Mu-Edit 提供了一条兼顾编辑效率与模型稳定性的新路径。
不过,研究也留下了一些开放问题:冲突指数的计算开销如何?动态低秩近似在更大规模模型上的表现是否一致?这些都有待后续工作回答。
结语
Mu-Edit 通过揭示域间零空间错位的机制,为多任务知识编辑提供了新的思路。其冲突感知排序和动态低秩近似的组合,在实验中展现出优于基线的性能,并保持了模型的通用能力。对于关注大模型知识更新与编辑的研究者和工程师而言,这是一项值得关注的进展。
相关推荐

普朗克长度是最小距离吗?物理学家为何存疑
普朗克长度常被称为宇宙最小距离,但科普视频指出这一说法从未被实验证实。本文解析普朗克长度的来源、显微镜思想实验的障碍,以及它真正告诉我们的——量子引力变得不可回避的尺度,而非时空像素。

AI代理驱动支出管理,Payhawk获2.8亿美元融资
Payhawk宣布完成2.8亿美元融资,估值达20亿美元。这家成立于2018年的企业财务管理平台以AI代理追踪和管理费用与采购,本文分析其产品定位演进、估值信号及对企业支出管理赛道的影响。

Snapchat开放AI助手构建AR滤镜:支持Claude Code与Cursor
Snapchat 宣布 Lens 创作者可用自然语言描述 AR 滤镜需求,由 Claude Code、Cursor 等 AI 助手完成从构建到完成的整个开发流程,AR 创作门槛大幅降低。