MuonGS:放宽权重范数控制,加速LLM预训练
MuonGS通过放宽权重范数控制加速大模型预训练,理论证明累积有效学习率持续增长。
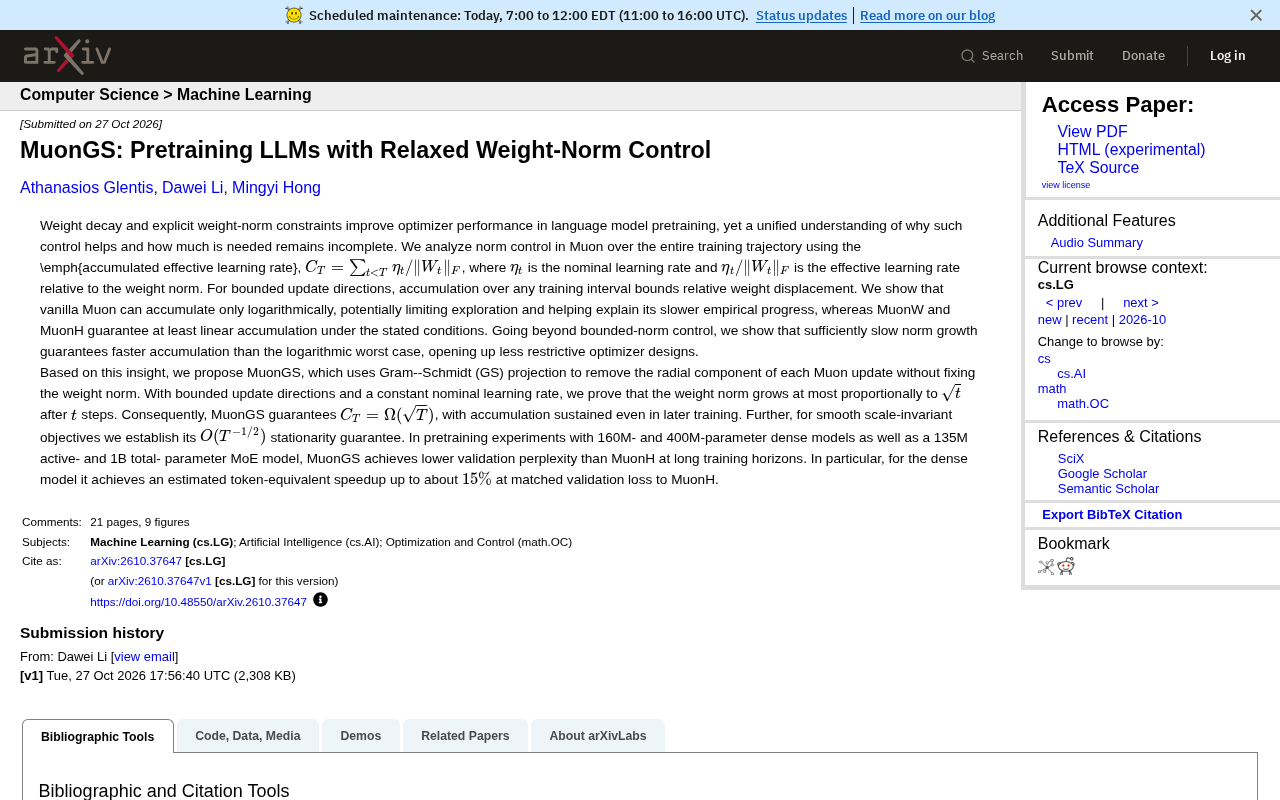
本文分析Muon优化器中权重范数控制的作用,提出累积有效学习率$C_T$作为理论工具,发现原始Muon仅能实现对数级累积,可能限制探索能力。为此提出MuonGS,用Gram-Schmidt投影移除更新中的径向分量,不固定权重范数,理论证明权重范数按√t增长,$C_T=\Omega(\sqrt{T})$。在160M和400M密集模型及135M激活-1B总参数MoE模型上预训练,MuonGS在长训练周期下验证困惑度优于MuonH,密集模型上匹配损失时估计获得约15%的token等效加速。
在语言模型预训练中,权重衰减和显式的权重范数约束被广泛用于提升优化器性能,但为何这种控制有效、需要控制到何种程度,始终缺乏统一的理论解释。近期一篇论文对Muon优化器中的范数控制进行了深入分析,并提出了新方法MuonGS,通过放宽权重范数控制来加速训练。
权重范数控制的理论新视角
研究团队引入“累积有效学习率”$C_T = \sum_{t<T} \eta_t / |W_t|_F$ 作为分析工具,其中$\eta_t$是名义学习率,$\eta_t / |W_t|_F$则是相对于权重范数的有效学习率。对于有界的更新方向,任意训练区间上的累积量可以约束权重的相对位移。这一框架将权重范数控制与优化器的探索能力联系起来:累积有效学习率越大,权重在训练中能够移动的相对幅度就越大,从而可能带来更好的探索。
分析揭示了一个有趣的现象:原始Muon在训练过程中累积有效学习率只能达到对数级增长,这可能限制了模型的探索能力,并有助于解释其在实际训练中进度较慢的原因。相比之下,MuonW和MuonH在给定条件下能够保证至少线性的累积。
进一步地,作者指出,如果权重范数增长足够缓慢,累积有效学习率可以超过对数最坏情况,这为设计限制更少的优化器打开了空间。
累积有效学习率中的“有效学习率”指名义学习率除以权重范数,反映参数在单位范数尺度下的相对更新幅度。由于权重范数会随训练变化,固定名义学习率下,实际探索步长可能被压缩。累积量 $C_T$ 将整个训练过程的相对步长求和,用于刻画权重能够移动的总相对距离。该指标与优化器的探索能力直接相关:$C_T$ 增长越慢,权重相对位移越受限,模型越难跳出当前区域。原始 Muon 仅实现对数级增长,意味着后期有效学习率衰减严重,这为解释其训练进度较慢提供了理论依据。
MuonGS:用Gram-Schmidt投影移除径向分量
基于上述洞察,论文提出了MuonGS。该方法使用Gram-Schmidt(GS)投影移除每个Muon更新中的径向分量,而不固定权重范数。这种设计既保留了权重范数控制的益处,又避免了硬约束带来的限制。
理论分析表明,在有界更新方向和恒定名义学习率下,经过$t$步后权重范数最多按$\sqrt{t}$的比例增长。因此,MuonGS保证了$C_T = \Omega(\sqrt{T})$,即在后期训练中累积有效学习率仍能持续增长。对于平滑的尺度不变目标,作者还建立了$O(T^{-1/2})$的平稳性保证。
Gram-Schmidt(GS)投影在此处用于将 Muon 更新向量中沿当前权重方向的分量剔除。具体而言,给定权重 $W_t$ 和更新方向 $U_t$,GS 投影计算 $U_t$ 在 $W_t$ 方向上的投影并减去,得到与 $W_t$ 正交的更新分量。这样,更新只改变权重的方向而不直接改变其范数,从而避免硬性范数约束。与固定范数方法不同,GS 投影不强制权重范数恒定,允许其缓慢增长。理论分析表明,这种设计使权重范数至多按 $\sqrt{t}$ 增长,从而保证累积有效学习率 $C_T = \Omega(\sqrt{T})$,在后期仍能持续增长。
预训练实验验证
研究在160M和400M参数的密集模型以及一个135M激活参数、1B总参数的MoE模型上进行了预训练实验。结果显示,在长训练周期下,MuonGS在验证困惑度上优于MuonH。特别是在密集模型上,与MuonH相比,在匹配验证损失时估计可获得约15%的token等效加速。
这一加速效果意味着,在相同计算预算下,MuonGS能够更高效地利用数据,或者达到更低的损失。对于大规模预训练而言,这种效率提升具有实际价值。
token 等效加速是衡量优化器效率的常用指标:在达到相同验证损失时,新方法相比基线节省的 token 数量百分比。例如,15% 的 token 等效加速意味着 MuonGS 用约 85% 的 token 就能达到 MuonH 用 100% token 达到的损失水平。这一指标直接反映数据效率的提升,在大规模预训练中具有显著经济价值。实验在 160M 和 400M 密集模型以及 135M 激活参数、1B 总参数的 MoE 模型上进行,覆盖了不同规模与架构,增强了结论的泛化性。
意义与展望
MuonGS的提出不仅提供了一种新的优化器设计思路,也深化了对权重范数控制的理解。通过理论分析和实验验证,作者展示了放宽范数控制可以在不牺牲性能的前提下加速训练。未来,这种方法有望被集成到现有的大模型训练流程中,进一步推动预训练效率的提升。
论文标题:MuonGS: Pretraining LLMs with Relaxed Weight-Norm Control
(本文基于论文摘要撰写,具体细节请参考原文。)
相关推荐
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
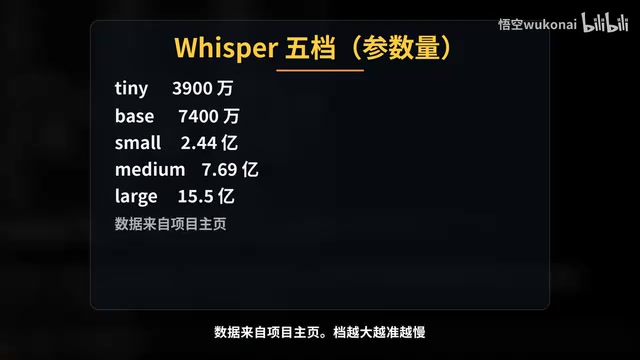
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
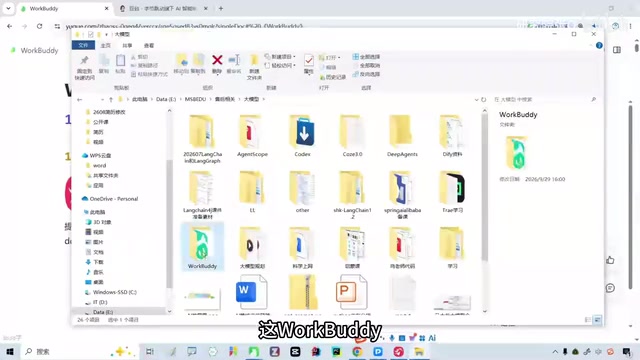
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
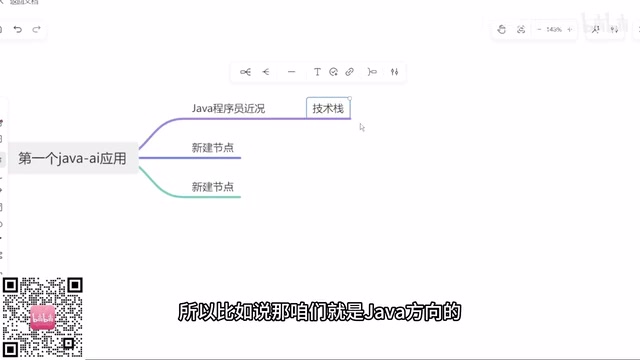
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。