Muse Ember:0.10美元级子代理模型的三方对决
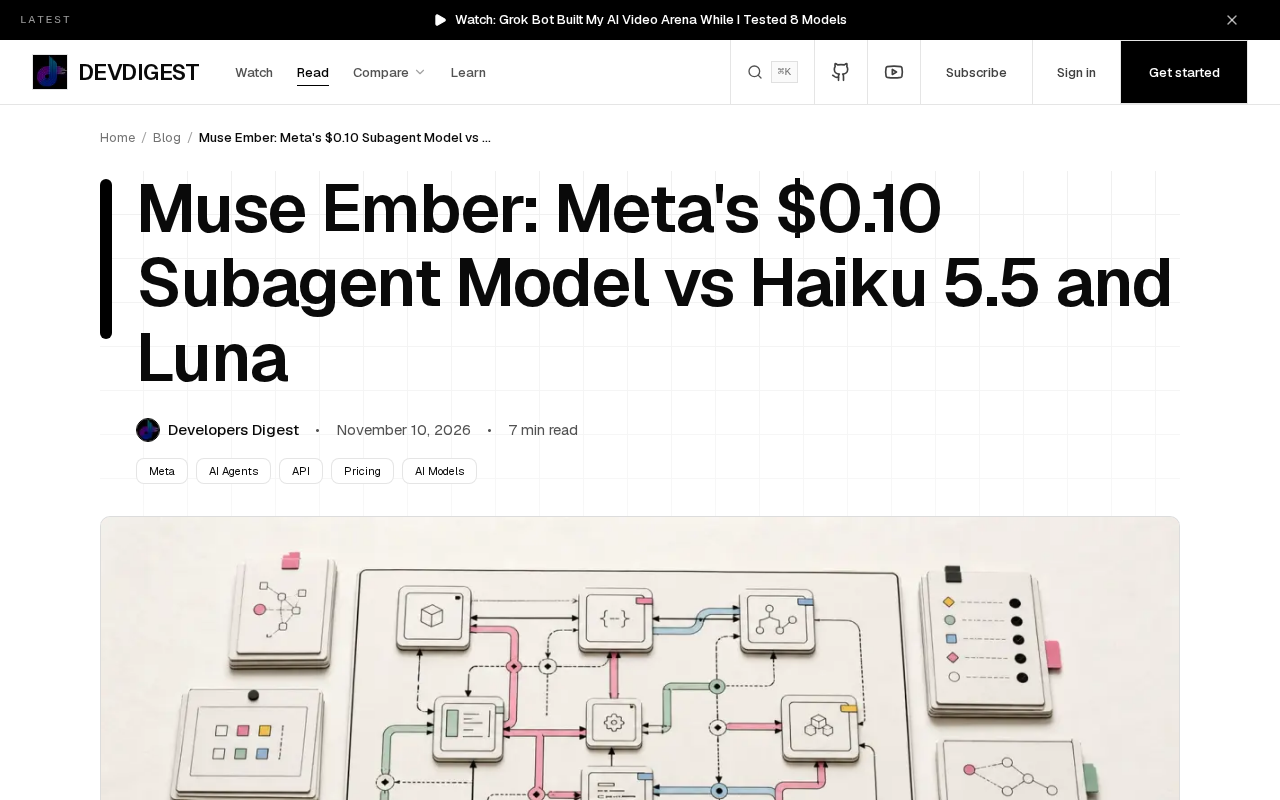
同价模型选子代理,关键不在标价而在任务粒度、返工率与生态协同。
文章对比了定价完全相同的三款低价模型——Meta 的 Muse Ember、Haiku 5.5 和 GPT-6 Luna——在子代理场景下的选型逻辑。三者均为每百万 token 输入 0.10 美元、输出 0.50 美元,但产品哲学不同:Muse Ember 主打与 Meta 工具链的生态协同和并发经济性,Haiku 5.5 延续稳定性与可预测延迟,Luna 则将通用推理能力下放到低价区间。文章指出,子代理选型的真正变量是任务粒度、返工率和调用延迟,而非标价本身;单步任务三者差距很小,多步推理任务则需权衡 Luna 的通用能力与更高返工成本。上下文窗口和工具调用格式也是不可忽视的隐性变量。
引言:同价不同命
当 Meta 的 Muse Ember 以每百万 token 输入 0.10 美元、输出 0.50 美元的价格出现在模型列表时,它几乎立刻被拿来与 Haiku 5.5 和 GPT-6 Luna 比较——因为三者的“标价”完全一致。但价格相同,并不意味着能力相同。对于需要部署子代理(subagent)的开发者来说,真正的问题是:在相同成本下,谁能在任务分解、工具调用和上下文保持上做得更好?
子代理(subagent) 是一种由主代理(main agent)动态创建并调用的辅助模型实例。它不直接面向终端用户,而是承担主代理分解出的子任务,如信息检索、格式转换、代码片段生成或局部推理。子代理架构的核心价值在于将复杂任务拆解为可并行、可隔离的单元,从而提升整体系统的吞吐量和鲁棒性。与单体大模型一次性完成所有工作相比,子代理模式允许主代理根据任务类型选择不同能力/成本的模型,实现“便宜模型干粗活、贵模型做决策”的分层调度。代价是引入了额外的编排开销和上下文传递损耗,因此子代理的单价、延迟和上下文效率会直接放大或抵消主代理的规划收益。
价格标签背后的产品逻辑
Muse Ember 的定价策略很明确:用极低的输入成本换取高频调用场景的渗透。子代理模型通常不直接面对终端用户,而是作为主代理的“执行手”存在,负责检索、格式化、简单推理等重复性工作。这类任务对单次输出质量的要求不高,但对调用次数极其敏感。0.10 美元的输入价格意味着开发者可以更激进地拆分任务,而不必担心成本失控。
Haiku 5.5 和 GPT-6 Luna 同样卡在这个价位,说明低价子代理已经成为行业共识的入口级产品。三者的竞争焦点不在价格,而在“每美元能完成多少有效工作”。
每百万 token 输入/输出定价 是当前大模型 API 的主流计费口径。输入 token 指开发者发送给模型的提示内容(包括系统指令、任务描述、历史对话和工具定义),输出 token 指模型生成的回复。输入价格通常显著低于输出价格,因为输入侧的计算主要发生在预填充阶段,可高度并行;输出侧则是逐 token 自回归生成,对显存带宽和时延更敏感。以 Muse Ember 为例,输入 0.10 美元、输出 0.50 美元的价差意味着:子代理场景中大量携带上下文(输入)的成本相对可控,而模型“说得多”的成本更高。开发者评估实际开销时,需按输入与输出的 token 比例加权计算,而非只看输入单价。
三方能力对比:没有绝对赢家
Muse Ember:Meta 生态的协同优势
Muse Ember 最直接的卖点是与 Meta 现有工具链的整合。如果团队已经在使用 Meta 的模型服务或相关开发框架,Muse Ember 的接入成本几乎为零。它的设计目标不是成为最强的单点模型,而是成为主代理调度中最顺滑的一环。对于任务边界清晰、需要大量并发调用的场景,这种协同性可能比单纯的基准分数更有价值。
Haiku 5.5:稳定性的延续
Haiku 系列一直以响应速度和稳定性著称。5.5 版本在保持低价的同时,延续了该系列在短上下文任务中的可靠表现。对于需要可预测延迟的生产环境,Haiku 5.5 的吸引力在于“不会出意外”——这在子代理层尤其重要,因为一个子代理的失败会向上传导,拖垮整个代理链。
GPT-6 Luna:通用能力的下放
Luna 的定位更像是把 GPT-6 系列的通用推理能力压缩到低价区间。它在复杂指令理解和多步推理上可能保有优势,但代价是输出风格更“重”,在某些简单任务上显得不够轻快。开发者需要判断:子代理的任务复杂度是否真的需要 Luna 的通用能力,还是 Haiku 5.5 或 Muse Ember 的专精路线更划算。
子代理选型的实际考量
任务粒度决定模型选择
如果子代理只负责单步操作——比如从文档中抽取字段、把自然语言转成 SQL、或者做简单的分类判断——三者的差距会被压缩到很小,此时生态整合和调用延迟成为决定性因素。Muse Ember 在这一层有天然优势。
如果子代理需要处理多步推理或模糊指令,Luna 的通用能力可能减少主代理的纠正次数,从而在整体上降低成本。这里的悖论是:单价相同,但“有效成本”取决于返工率。
任务粒度 指主代理将整体目标拆分为子任务时的粗细程度。粗粒度子任务(如“调研并总结某主题”)需要子代理具备多步推理和自主规划能力,更适合通用能力较强的模型;细粒度子任务(如“从这段文本抽取日期字段”)边界清晰、输出格式固定,低价专精模型即可胜任,且并发收益更高。粒度选择还与返工率耦合:子代理输出不合格时,主代理需重新下发任务或自行修正,这部分额外 token 消耗构成“有效成本”。因此,单价相同的模型在粗粒度任务上的真实成本可能相差数倍,开发者应以端到端任务成功率和总 token 消耗作为选型依据,而非孤立比较标价。
上下文窗口与工具调用
原文没有披露三者的上下文窗口和工具调用格式细节,但这是子代理场景中不可忽视的变量。子代理往往需要携带主代理下发的任务描述、历史摘要和工具定义,上下文效率直接影响每次调用的实际消耗。开发者在上手前应重点测试这一项。
上下文窗口(context window) 指模型单次调用可接收的最大 token 总量,涵盖输入与输出。在子代理场景中,上下文窗口的紧张程度直接影响任务设计:若窗口偏小,主代理必须压缩任务描述和历史摘要,可能丢失关键约束;若窗口充裕,则可携带完整工具定义和示例,减少子代理的歧义。工具调用(function calling / tool use) 则指模型以结构化格式(如 JSON)输出工具名与参数,由外部执行并回传结果。不同厂商的工具调用格式、并行调用支持度和错误处理约定存在差异,这些细节会决定子代理链的集成成本与稳定性。原文未披露三者的具体参数,因此实际选型时应以官方文档和端到端压测为准。
结论:价格是起点,不是答案
Muse Ember、Haiku 5.5 和 GPT-6 Luna 站在同一条价格线上,却指向不同的使用哲学。Muse Ember 赌的是生态协同和并发经济性,Haiku 5.5 押注稳定性和可预测性,Luna 则把通用推理下放到低价层。没有哪个模型在所有子代理任务中都占优——选型的核心是明确你的任务粒度、返工容忍度和现有工具链,然后让价格标签退居其次。
相关推荐
AI ഉറങ്ങുമ്പോൾ എന്ത് സംഭവിക്കും? Anthropic Agent Memory #TechMalayalam #AgenticAI #ClaudeAI
从Anthropic的Claude与Agent Memory机制出发,解析AI智能体在会话之间如何加载、整理与丢弃记忆,以及自评估循环、笔记规则对开发者的实际启发。
英伟达CEO绯闻背后:AI基建的"关键人风险"
英伟达CEO黄仁勋绯闻引发董事会独立调查,芯片股大涨而英伟达独自下跌。本文拆解AI基建背后的关键人风险,以及房地产投资者如何用三步核查保护自己的交易。
Claude Code隐藏设置:开启Idle Compaction省大钱
Claude Code 的 Idle Compaction 设置可避免提示缓存过期后整段上下文按全价重发。本文介绍问题根源、开启路径与注意事项,帮助开发者降低长会话的 API 成本。