n8n AI Agent教程:从规则自动化到智能客服机器人

n8n AI Agent教程:用Webhook、Edit Fields和HTTP Request三步构建智能客服机器人。
本文介绍n8n中AI Agent的工作原理与实战搭建方法。传统自动化依赖固定规则,面对混乱输入容易失效;AI Agent由大语言模型驱动,能解释输入、推理并决定下一步行动,带来消除人工审核、理解自然语言、规模化个性化和添加推理四项能力。其运行周期包括触发器、LLM推理、工具动作、记忆上下文和自我纠正。实战部分在n8n Cloud中依次配置Webhook触发器、Edit Fields节点和调用OpenAI的HTTP Request节点,即可让机器人接收问题、理解意图并返回上下文相关的回复,该模式可扩展为工单助手和聊天机器人。
n8n AI Agent教程:从规则自动化到智能客服机器人
传统自动化依赖“如果发生A,就执行B”的固定规则。但当输入变得混乱——比如一封愤怒的客户邮件、一个模糊的请求,或者一份格式混乱的PDF——规则就会失效。AI Agent则不同:它让n8n从规则引擎进化为能够阅读、理解并做出决策的智能层。本文将基于视频教程,带你理解AI Agent在n8n中的工作原理,并一步步构建一个可运行的AI客服机器人。
什么是n8n中的AI Agent?
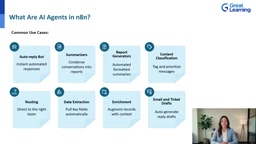
AI Agent是由大语言模型(LLM)驱动的自动化组件。与传统节点不同,它不只是处理数据,而是解释输入、进行推理,并决定下一步行动。在n8n中,Agent接收文本、JSON等输入,向OpenAI等模型发送动态提示,模型返回上下文相关的响应,然后Agent可以触发发送邮件、更新CRM或调用其他API等操作。
这种模式将自动化从“预定义所有条件”转变为“给定目标,让Agent自行 figuring out 细节”。例如,客服团队收到的邮件五花八门:投诉、反馈、密码重置、功能请求。传统工作流需要数十个条件分支,而AI Agent只需一个提示:“分类这封邮件并起草合适的回复”,它就能自动完成路由、起草回复并更新系统。
大语言模型(LLM) 是AI Agent的推理引擎,指基于海量文本训练、能够理解和生成自然语言的神经网络模型,如OpenAI的GPT系列。在n8n的Agent场景中,LLM并不直接操作数据,而是接收由Agent动态组装的提示(prompt),输出结构化的判断或自然语言回复。与传统的分类器或规则引擎不同,LLM能处理未见过的新表述、识别隐含意图,并可根据系统指令扮演特定角色(如客服语气)。其局限性在于输出具有概率性,可能产生不准确内容,且依赖外部API的延迟与成本,因此生产环境常需配合校验与人工兜底。
为什么AI Agent重要:从规则到推理
AI Agent的核心价值在于将自动化从基于规则的工作流升级为基于推理的工作流。传统自动化要求数据干净、可预测、结构化,但现实世界的工作流充满混乱。根据视频中的总结,AI Agent带来四项“超能力”:
- 消除人工审核:AI可以自动分类、总结和回复,无需人工逐条检查。
- 理解自然语言:不再需要严格的if-else规则或完美结构化的文本。
- 规模化个性化:每个用户或客户获得不同的回复,而非千篇一律的模板。
- 为工作流添加推理:逻辑变得自适应,而非仅仅是规则驱动。
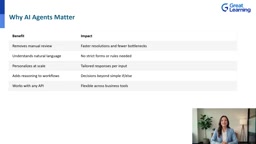
简而言之,AI Agent让工作流能够“思考”、适应和个性化,开辟了全新的可自动化领域。
AI Agent在n8n工作流中如何运行?
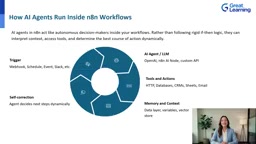
在n8n内部,AI Agent像一个自主决策者。它的运行周期包括以下几个环节:
- 触发器:Webhook、定时事件或Slack消息等启动工作流。
- AI Agent / LLM:输入被发送到OpenAI等模型,进行解释和推理。
- 工具与动作:根据AI的决策,调用API、更新数据库、发送邮件或与CRM交互。
- 记忆与上下文:通过变量、数据层或向量存储来保存和检索上下文,避免每次运行都是孤立的。
- 自我纠正:Agent评估结果并动态决定下一步,甚至循环或调整响应。
这样一来,工作流不再是直线,而是一个“思考循环”。我们不再只是自动化任务,而是在自动化决策。
向量存储(Vector Store) 是支撑Agent记忆与上下文检索的关键组件:它将文本转换为高维向量(embedding)并存入数据库,查询时按语义相似度召回相关内容。在n8n的Agent工作流中,向量存储常用于保存历史对话、产品文档或知识库,使Agent在每次运行时能检索而非重读全部信息,从而实现长期记忆与基于企业知识的回答。它与简单的变量记忆不同,擅长处理非结构化文本和大规模语料,但需要额外的嵌入模型与索引维护,检索质量直接决定回答的相关性。
实战:构建你的第一个AI客服机器人
视频教程在n8n Cloud中演示了一个迷你AI Agent的搭建过程。这个支持助手能够理解问题、解释含义并生成有用的回答。以下是关键步骤:
步骤1:创建工作流
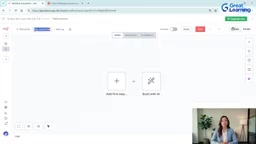
在n8n Cloud中新建工作流,命名为“AI Support Bot”。这个工作流将扮演Agent角色:接收输入、决定行动并智能响应。
步骤2:添加Webhook触发器
Webhook作为机器人的“收件箱”,用于接收用户或系统发送的问题。将方法设置为POST,路径命名为support-bot,并暂时保持测试模式以便触发。
步骤3:添加Edit Fields节点
原始Webhook数据可能很混乱。使用Set节点(命名为Edit Fields)提取用户提示,并清晰命名。例如,将用户消息提取为prompt字段。这为Agent提供了结构化的上下文。
步骤4:添加HTTP Request节点调用OpenAI
这是AI Agent的核心。向OpenAI API发送请求,包含系统指令(赋予AI个性)和用户消息作为提示。当工作流运行时,OpenAI返回对话式智能响应。如果遇到401错误,检查API密钥格式,必须以Bearer开头。
Bearer Token 是HTTP请求中常用的一种认证方式:客户端在请求头 Authorization 中携带 Bearer <令牌>,服务端据此验证调用者身份。调用OpenAI API时,API密钥必须以 Bearer 前缀放在该请求头中,格式错误是导致401未授权错误的常见原因。除认证头外,请求体通常还需指定模型名称、消息数组(含系统指令与用户提示)以及温度等参数。理解这一机制有助于在n8n的HTTP Request节点中手动构造请求,也便于排查密钥泄露、配额不足等运行时问题。
步骤5:触发Webhook测试
通过Webhook发送一个真实的支持问题,例如“How do I fix a failing workflow in n8n?”。工作流会提取提示、调用OpenAI并立即返回友好且智能的答案。
至此,一个可工作的AI Agent就完成了:它接收问题、使用自然语言理解进行解释、通过LLM推理并返回上下文相关的响应。这个模式完全模块化,可以将输出链接到n8n中的任何工具,是构建工单助手、聊天机器人、自动回复系统的基础。
总结与建议
传统自动化遵循固定规则,当输入混乱时就会失效。AI Agent增加了理解能力:它们阅读非结构化文本、识别意图并决定下一步。通过Webhook、Edit Fields节点和AI调用,我们构建了一个简单的AI客服机器人。n8n的AI Agent节点更进一步,通过添加工具和记忆,让AI不仅能回答,还能采取行动。对于任何敏感操作,建议保留人工审核环节。现在,不妨将这个模式应用到你自己的某个工作流中试试。
相关推荐

花旗AI编程代理Devon:年省30%技术外包费,1.4万工程师已使用
花旗集团利用AI编程代理Devon,一年内削减30%技术供应商费用,1.4万工程师使用,产品发布提速30%-40%。本文分析其对IT外包行业的冲击及未来人机协作模式。

从生日派对到千亿AI帝国:新一代PayPal黑帮崛起
2015年一张生日派对合影,十年后催生Scale AI、Cognition AI等千亿估值AI公司。解析新一代PayPal黑帮的创业路径、互相投资生态,以及Peter Thiel的Founders Fund如何完成代际传承。

GrokBot临床数据管理AI代理:5分钟组建10人专家团队
GrokBot 推出面向临床数据管理的 AI 代理模板,通过 MCP 服务器和自然语言指令,五分钟内组建 10 个专家代理加 1 个协调者的团队,自动完成数据验证、质疑管理与报告撰写。