n8n AI记账工具的陷阱:当"成功"却提取不出数据
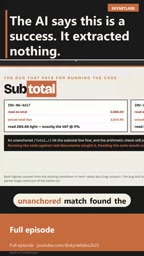
一个未锚定正则把"subtotal"误认成"total",揭示了AI发票解析中"假成功"比报错更危险的工程教训。
本文以一个AI自动记账系统的真实bug为切入点,描述了"流程成功、结果出错"这一最隐蔽的失败模式。根本原因是未锚定的正则表达式在匹配"total"时,先命中了包含"total"子串的"subtotal"行,导致两张发票各被少读了相当于税额的金额(约284-285美元),而整个流程没有任何报错。作者的解决方案借鉴自Google某项目的设计思路:让每个被提取的数字都携带其来源的原始文本行,实现可审计的数据溯源。在人工复核界面,点击任意字段即可高亮对应原句,且展示的是人类可读的完整句子而非机器处理后的裸字符串,使单据复核时间大幅下降。文章最终归纳出四条核心启示:警惕假成功、用真实数据测试、保留溯源信息、为人类设计复核界面。
当工具报告"成功",却什么都没提取到
一个AI自动化记账流程给出了成功的状态提示,但实际上它什么关键数据都没抽取出来。这正是构建发票解析系统时最隐蔽的失败模式——流程跑完了,没有报错,但结果是错的。在n8n这类自动化平台上搭建AI记账助手时,这种"假成功"比直接报错更危险,因为它会悄无声息地污染账目。
问题的根源在一个看似无害的字符串匹配:subtotal(小计)这个词里包含了total(合计)。当解析器使用一个未锚定(unanchored)的正则匹配去寻找"total"时,它会先命中"subtotal"所在的那一行。
一个字符串匹配引发的记账错误
结果是实实在在的金额偏差。两张发票分别被读少了284美元和285美元——而这个差额恰好等于税额。换句话说,解析器抓到的是不含税的小计金额,而不是应该入账的含税合计。对一个记账系统而言,这种差错足以让整套账目失去可信度。
关键在于:只靠阅读代码是发现不了这个bug的。它看起来完全正确,逻辑也说得通。只有把真实代码跑在真实文档上,让它去撞真实发票的版式,才能把这个"小计陷阱"暴露出来。
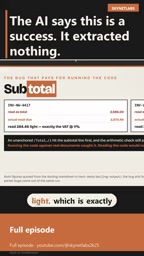
这给所有做AI文档提取的人一个提醒:面对版式各异的真实发票,测试必须用真实数据驱动,而不是在干净的样例上验证"看起来对不对"。
**未锚定正则(unanchored regex)**是指匹配模式没有使用边界断言(如 \b单词边界、^行首或精确的字段终止符)来限定匹配范围。以搜索 total 为例,未锚定时正则引擎会扫描整行文本,凡包含该字符序列的位置均视为命中——subtotal、grand total、total_amount 都会触发。锚定写法通常如 \btotal\b 或 (?<![a-z])total(?![a-z]),强制要求"total"前后不能紧跟其他字母,从而排除"subtotal"这类误匹配。发票文档中字段顺序固定(小计在前、合计在后),未锚定匹配天然会被排在更靠前的小计行"抢先命中",而解析器拿到第一个匹配结果后通常不再继续搜索,最终把小计金额当成合计入账。
让每个数字都带着它的出处
解决方案借鉴自一个Google的项目——注意,是重建了其模式思路,并没有照抄任何代码。核心理念很简单却很有力:这套工具提取出的每一个数字,都携带着它所在的原始文本行。

这种"数据溯源"的设计,把AI提取从一个黑箱变成了可审计的流程。模型抽出的每个字段都能追溯回源文档的具体位置,而不是一堆脱离上下文的孤立数字。
这种做法在数据工程领域通常称为数据血缘(data lineage)或提取溯源(extraction provenance)。传统的文档解析管道只输出结构化字段值(如 total: 1284.00),一旦值出错,排查时需要重新跑整条流水线才能定位源头。带溯源的设计则在输出时同时记录该值来自文档的第几行、原始文本是什么,形成"值—出处"的绑定对。这不仅便于事后审计,还为下游的置信度评分提供依据:如果原始行同时包含"subtotal"和数字,系统可以主动标记为低置信度候选,提示人工复核,而不是静默地写入账本。
人机协作:点击字段,原句高亮
这个溯源能力真正的价值体现在人工复核环节。当一个人打开待审核的卡片时,点击任意字段,对应的原始语句就会高亮亮起。
更贴心的是,它展示的是人类阅读习惯中的那一行文本,而不是解析器实际用来匹配的那个被剥离、被清洗过的版本。机器匹配的是去格式化后的字符串,但人看到的是完整自然的句子——两者分离,审核效率自然提升。
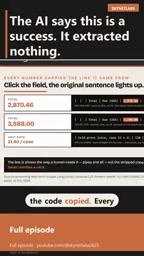
效果是直接的:单张单据的复核时间从原来的两分钟大幅下降。对于需要处理大量发票的记账场景,这种人机配合的效率提升会被成倍放大。
给AI文档提取的几点启示
这个短小的案例浓缩了构建可靠AI文档处理系统的几个核心经验:
- 警惕"假成功":状态为成功不代表结果正确,必须有独立的校验机制(比如税额交叉验证)去捕捉静默错误。
- 用真实数据测试:代码审阅发现不了的问题,真实文档的多样版式能逼出来。
- 保留溯源信息:让每个提取值绑定其源文本,是实现可审计和可信的基础。
- 为人类而设计复核界面:展示人类可读的原句而非机器匹配的裸字符串,能显著降低复核成本。
在AI越来越多地接管财务、法务等高精度场景时,这种"可解释、可追溯、可人工兜底"的工程思路,往往比模型本身的参数规模更能决定系统是否真正可用。
文章提到的**静默错误(silent error)**是自动化系统中最棘手的故障类别。与抛出异常的显式错误不同,静默错误让流程正常完成、状态码显示成功,但输出数据已经悄然偏离预期。财务场景中常见的防御手段包括:交叉校验(如验证"小计 + 税额 = 合计"等数学约束)、异常值检测(金额偏离历史均值超过阈值则触发告警)、以及抽样人工复核。这些机制的共同逻辑是——不信任任何单一来源的"成功"信号,而是从数据本身的内在一致性寻找验证依据。在n8n等低代码自动化平台上,这类校验节点往往比核心提取逻辑更难被重视,但它们恰恰是系统可信度的最后防线。
相关推荐

n8n入门实战:从零搭建你的第一个AI工作流
n8n入门实战教程:从自动化基本概念讲起,一步步教你用n8n搭建第一个AI工作流,连接Gemini模型,实现自动智能回复。涵盖节点、触发器、API Key配置、系统提示词等核心知识,适合零基础学习者。

AI自动修复生产崩溃:n8n+Dify打造自愈运维流水线
一个生产环境崩溃的真实案例:如何用 n8n 工作流、Dify AI 调试代理和 ChatGPT 构建自愈式运维流水线,自动捕获错误、修复代码并重新部署。附技术栈拆解与落地风险分析。

Anthropic向警方举报日记内容:AI隐私边界引发争议
Anthropic被曝将用户日记内容上报警方,导致一名女性面临重罪指控,在Hacker News引发热议。本文探讨AI隐私边界、服务商举报义务与用户信任之间的深层矛盾。